MUTF-8 编码逃逸:当字节码安全扫描漏掉恶意字符串
漏洞分析
class 常量池不用标准 UTF-8。两处字节差,让 grep 和静态扫描器漏掉含特定字符的字符串。
class 常量池不用标准 UTF-8。两处字节差,让 grep 和静态扫描器漏掉含特定字符的字符串。 1 常量池不是 UTF-8 ------------- class 文件的常量池是静态分析工具的第一入口。`CONSTANT_Utf8_info` 承载类名、方法名、字符串常量,扫描器解析这些字符串来做符号提取和规则匹配。几乎默认这些字符串用的是标准 UTF-8。 但这个默认假设在 JVMS §4.4.7 面前不成立——常量池用的是 Modified UTF-8(MUTF-8),与 RFC 3629 标准 UTF-8 有两处系统性差异。差异不在规范描述层面,在字节序列上。它们直接决定一个扫描器能不能正确读到 CP 里的字符串。 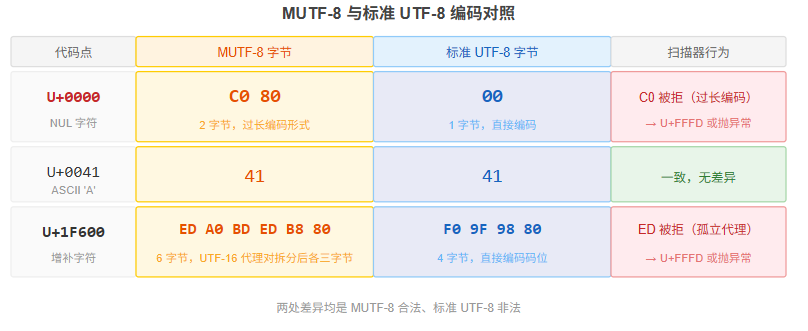 2 环境与源码 ------- | | | |---|---| | 组件 | 版本 | | OS | Kali Linux 2026.1,内核 6.6.x | | JDK | OpenJDK 21.0.11-ea | | Python | 3.11 | | 工具 | xxd、javap、grep、strings |  3 `C0 80` 不是 `00` ----------------- `U+0000` 在标准 UTF-8 中是单字节 `00`。在 MUTF-8 中是双字节 `C0 80`。 写了第一个测试,让 `javac` 把含 `\u0000` 的字面量编进常量池。 `src/Zero.java`: ```php public class Zero { static final String S1 = "\\u0000"; static final String S2 = "A\\u0000B"; public static void main(String[] args) { System.out.printf("S1.length=%d S2.length=%d%n", S1.length(), S2.length()); } } ``` ```php javac src/Zero.java -d . && xxd Zero.class ```  `xxd` 输出中,偏移 0xA2 处是 `c0 80`——S1 对应的 Utf8 项。偏移 0x120 处是 `41 c0 80 42`——S2。`String.length()` 返回 1 和 3,这个数字按代码点计数,和 CP 里的字节数不一样。CP 中 length 字段存的是字节数,不是字符数。两个概念被 MUTF-8 拉开了差距。 4 四字节变六字节 --------- `U+1F600` 在标准 UTF-8 中编码为四字节 `F0 9F 98 80`。MUTF-8 不走这条路径——它先把码位拆成 UTF-16 代理对 `D83D DE00`,再对每个代理码位做三字节编码,合计六字节 `ED A0 BD ED B8 80`。MUTF-8 不接受 `F0` 开头的四字节序列,增补字符只能走代理对这条路。 `src/ZeroFull.java`: ```php public class ZeroFull { static final String S3 = "\\uD83D\\uDE00"; public static void main(String[] args) {} } ``` ```php javac src/ZeroFull.java -d . && xxd ZeroFull.class ```  偏移 0x76 出现了 `ed a0 bd ed b8 80`——六字节,不是标准 UTF-8 的四字节。首字节 `ED` 在三字节头的范围内,但 RFC 3629 §3 明确禁止编码代理码位。标准 UTF-8 解码器遇到 `ED A0 BD` 这样的孤立高位代理,要么抛异常,要么替换为 U+FFFD。 5 javap 知道真相 ------------ `javap -v` 读 CP 时走的是 MUTF-8 解码路径,它能看到正确的字符串。 ```php javap -v -p Zero.class 2>&1 | grep -E 'Utf8|String' ```   ```php javap -v -p ZeroFull.class 2>&1 | grep -E 'Utf8|String' ```  Zero.class 的 `#18 = Utf8` 显示为 `\u0000`,`#32 = Utf8` 显示为 `A\u0000B`——`C0 80` 被反解为 `\u0000` 转义。ZeroFull.class 的 `#13 = Utf8` 显示为 `😀`——六字节代理对合成了码位 `U+1F600`。`javap` 的输出逻辑正确,因为它从一开始就知道 CP 用的是 MUTF-8。 6 跳过 javac ---------- 接下来不再依赖 `javac`,直接生成 class 文件。CP 里的每个 Utf8 项由三段构成:1 字节 tag(固定为 1)、2 字节 length(字节数,不是字符数)、length 字节的 MUTF-8 payload。 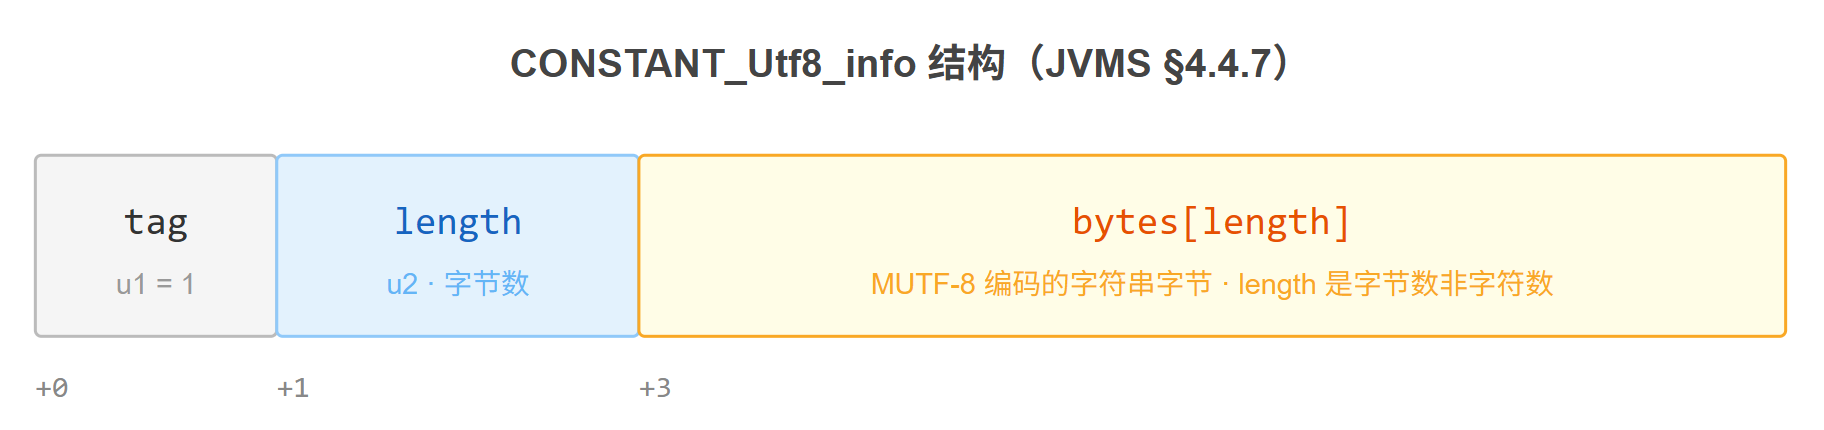 `gen/build_zero.py`——往 CP 里写入 `A` + U+0000 + `B`: ```php import struct def u1(x): return struct.pack(">B", x) def u2(x): return struct.pack(">H", x) TAG_UTF8 = 1 TAG_CLASS = 7 TAG_STRING = 8 def cp_utf8(b): """返回 CONSTANT_Utf8_info 的字节:tag + length(u2) + payload""" return u1(TAG_UTF8) + u2(len(b)) + b def cp_class(i): return u1(TAG_CLASS) + u2(i) def cp_string(i): return u1(TAG_STRING) + u2(i) entries = [ cp_utf8(b"Zero"), cp_class(1), cp_utf8(b"java/lang/Object"), cp_class(3), cp_utf8(b"\x41\xC0\x80\x42"), # "A" + U+0000 + "B",4 字节 cp_string(5), ] cp = b"".join(entries) cp_count = len(entries) + 1 body = b"\xCA\xFE\xBA\xBE" + u2(0) + u2(52) + u2(cp_count) + cp body += u2(0x0001) + u2(2) + u2(4) + u2(0) * 8 with open("Zero_manual.class", "wb") as f: f.write(body) print(f"wrote {len(body)} bytes, cp_count={cp_count}") ``` ```php python3 gen/build_zero.py && xxd Zero_manual.class ```  偏移 0x2A:`01 00 04 41 c0 80 42`。tag=1,length=4,payload 就是这四个字节。length 是 4 而不是 3——`C0 80` 作为两字节序列计入了 length,字符数和字节数在这里是不同的。 `gen/build_emoji.py`——往 CP 里写入 `E` + U+1F600: ```php import struct def u1(x): return struct.pack(">B", x) def u2(x): return struct.pack(">H", x) TAG_UTF8 = 1; TAG_CLASS = 7; TAG_STRING = 8 def cp_utf8(b): return u1(TAG_UTF8) + u2(len(b)) + b def cp_class(i): return u1(TAG_CLASS) + u2(i) def cp_string(i): return u1(TAG_STRING) + u2(i) def mutf8_supplementary(cp): v = cp - 0x10000 hi = 0xD800 | (v >> 10) lo = 0xDC00 | (v & 0x3FF) def enc3(w): return bytes([ 0xE0 | (w >> 12), 0x80 | ((w >> 6) & 0x3F), 0x80 | (w & 0x3F), ]) return enc3(hi) + enc3(lo) emoji = mutf8_supplementary(0x1F600) print(f"emoji hex: {emoji.hex()} len={len(emoji)}") entries = [ cp_utf8(b"Emoji"), cp_class(1), cp_utf8(b"java/lang/Object"), cp_class(3), cp_utf8(b"E" + emoji), cp_string(5), ] cp = b"".join(entries) cp_count = len(entries) + 1 body = b"\xCA\xFE\xBA\xBE" + u2(0) + u2(52) + u2(cp_count) + cp body += u2(0x0001) + u2(2) + u2(4) + u2(0) * 8 with open("Emoji_manual.class", "wb") as f: f.write(body) ``` ```php python3 gen/build_emoji.py && xxd Emoji_manual.class ```  偏移 0x2F:`45 ed a0 bd ed b8 80`。'E' 后面紧跟着六字节代理对,length=7。 7 四种策略,两种结果 ----------- 有了精确的字节序列,接下来用四种不同的解码策略去读这两份 class 文件。 `scan/naive_scan.py`: ```php import sys, re def std_utf8_replace(data): return data.decode("utf-8", errors="replace") def std_utf8_strict(data): try: return data.decode("utf-8", errors="strict") except UnicodeDecodeError: return "<strict-fail>" def ascii_strings(data, min_len=4): return re.findall(rb"[\x20-\x7e]{%d,}" % min_len, data) def mutf8_aware(data): s = data.replace(b"\xC0\x80", b"\x00") pat = re.compile( rb"\xED[\xA0-\xAF][\x80-\xBF]" rb"\xED[\xB0-\xBF][\x80-\xBF]" ) def collapse(m): b = m.group(0) hi = ((b[0] & 0x0F) << 12) | ((b[1] & 0x3F) << 6) | (b[2] & 0x3F) lo = ((b[3] & 0x0F) << 12) | ((b[4] & 0x3F) << 6) | (b[5] & 0x3F) cp = 0x10000 + ((hi - 0xD800) << 10) + (lo - 0xDC00) return chr(cp).encode("utf-8") s = pat.sub(collapse, s) return s.decode("utf-8", errors="replace") path = sys.argv[1] data = open(path, "rb").read() r1 = std_utf8_replace(data) r2 = std_utf8_strict(data) r4 = mutf8_aware(data) print(f"file: {path}") print(f"[1] std_utf8_replace: C0_80_found={b'\\xC0\\x80' in data}" f" U+FFFD_in_output={'\\ufffd' in r1}") print(f"[2] std_utf8_strict: {r2[:60]}") print(f"[3] ascii_strings: count={len(ascii_strings(data))}") print(f"[4] mutf8_aware: A_NUL_B_recovered={'A\\x00B' in r4}") ``` ```php python3 scan/naive_scan.py Zero_manual.class python3 scan/naive_scan.py Emoji_manual.class ```  | | | | |---|---|---| | 策略 | Zero\_manual(含 `A\u0000B`) | Emoji\_manual(含 `E😀`) | | std\_utf8\_replace | U+FFFD 出现,`A` 和 `B` 被污染 | U+FFFD 出现 | | std\_utf8\_strict | 抛异常,整个文件扫描失败 | 抛异常 | | ascii\_strings | `A` 与 `B` 分两行输出 | `E` 孤立输出 | | mutf8\_aware | `A\u0000B` 完整恢复 | `E😀` 完整恢复 | `strings` 那列最直观——`A` 和 `B` 分两行,`C0` 和 `80` 都不是可打印 ASCII,字符串在这断开。标准 UTF-8 严格模式连一个字符都读不出来就抛异常了,整个 class 文件扫描直接失败。replace 模式静默地把 `C0 80` 换成两个 U+FFFD——字符串没断,但内容已经不是原来的了。 8 同一段字节,三种 Java 结果 ------------------ Java 标准库内部,同一个 `41 C0 80 42` 输入,根据走哪条路径,产出的字符串完全不同。 `src/DecodePath.java`: ```php import java.io.*; import java.nio.*; import java.nio.charset.*; public class DecodePath { public static void main(String[] args) throws Exception { byte[] payload = { 0x41, (byte)0xC0, (byte)0x80, 0x42 }; // readUTF —— 内部走 MUTF-8,认出 C0 80 就是 U+0000 ByteArrayOutputStream buf = new ByteArrayOutputStream(); DataOutputStream dos = new DataOutputStream(buf); dos.writeShort(payload.length); dos.write(payload); String r1 = new DataInputStream( new ByteArrayInputStream(buf.toByteArray())).readUTF(); // new String(UTF-8) —— 标准 UTF-8,遇非法字节静默替换为 U+FFFD String r2 = new String(payload, StandardCharsets.UTF_8); // CharsetDecoder REPORT —— 标准 UTF-8,遇非法字节直接抛异常 String r3; try { CharsetDecoder dec = StandardCharsets.UTF_8.newDecoder() .onMalformedInput(CodingErrorAction.REPORT); r3 = dec.decode(ByteBuffer.wrap(payload)).toString(); } catch (CharacterCodingException e) { r3 = "EXCEPTION: " + e.getClass().getSimpleName(); } System.out.println("[1] readUTF: len=" + r1.length() + " chars=[" + dump(r1) + "]"); System.out.println("[2] new String UTF8: len=" + r2.length() + " chars=[" + dump(r2) + "]"); System.out.println("[3] CharsetDecoder: " + r3); } static String dump(String s) { StringBuilder sb = new StringBuilder(); for (int i = 0; i < s.length(); i++) sb.append(String.format("U+%04X ", (int)s.charAt(i))); return sb.toString().trim(); } } ``` ```php javac src/DecodePath.java -d . && java -cp . DecodePath ```  `readUTF` 认出了 `C0 80` 就是 `U+0000`,返回 3 个字符。`new String(UTF-8)` 返回 4 个字符——两个 U+FFFD 替换了原来的 `C0 80`,长度变了,没抛异常。`CharsetDecoder` REPORT 直接抛 `MalformedInputException`。 如果一个扫描器用 `new String(bytes, "UTF-8")` 解析类名,`"A\u0000B"` 传进去,出来的是四个字符的 `"A" + U+FFFD + U+FFFD + "B"`。精确匹配的规则找的是原始字符串,永远命中不了。 9 连 `strings` 都看不全 ------------------ 通用工具不需要理解 class 格式——`strings` 直接扫二进制文件里的可打印 ASCII 段。 ```php strings -a -n 1 Zero_manual.class | head -20 ```  `A` 和 `B` 各占一行。`C0` 和 `80` 不在可打印 ASCII 范围,`strings` 在这里断开了。常见的管道用法 `strings target.class | grep 'A.*B'`——`strings` 已经把 `A` 和 `B` 劈成两行,`grep` 逐行匹配,跨行的规则永远不会命中。攻击者只需要把敏感字符串里某个字符换成 `U+0000`,扫描器的 `strings | grep` 链就断了。 10 JVM 知道哪里不对 ------------- JVM 内部有 MUTF-8 校验——`-Xverify:all` 会检查 CP 中 Utf8 项的字节合法性。把 `Emoji_manual.class` 中六字节代理对的第二个代理首字节从 `ED` 改成 `EE`,只改 1 个字节: ```php import re data = bytearray(open("Emoji_manual.class","rb").read()) m = re.search(rb"\xED\xA0\xBD\xED\xB8\x80", bytes(data)) if m: i = m.start() data[i + 4] = 0xEE open("Emoji_broken.class","wb").write(data) print(f"Patched offset {hex(i)}: byte {hex(i+4)} ED -> EE") ``` ```php java -Xverify:all -cp . Emoji_broken 2>&1 ```  `ClassFormatError` 直接拒绝加载。但合法的 MUTF-8——`C0 80` 和完整的六字节代理对——通过校验时是静默的。JVM 检查的是字节在 MUTF-8 规范下是否合法,不关心标准 UTF-8 解码器怎么读。 扫描器恰好相反:读的是字节,用的是标准 UTF-8。JVM 放行的,恰恰是扫描器看不见的。 11 利用和修法 -------- 两个差异点,三种扫描结果。归到一张表里: | | | | |---|---|---| | 差异点 | MUTF-8 字节 | 标准 UTF-8 行为 | | `U+0000` | `C0 80`(2B) | 过长编码 → U+FFFD 或异常 | | `U+10000` 以上 | `ED Ax Bx ED Bx Bx`(6B) | 孤立代理 → U+FFFD 或异常 | 攻击面很清楚。一个扫描器用 `new String(bytes, UTF-8)` 解析 CP 里的类名,做黑名单子串匹配。攻击者把类名里的某个字符换成 `U+0000`——常量池里写入 `C0 80` 序列。JVM 加载时 `readUTF` 还原出完整的类名,但扫描器读到的是 U+FFFD 污染后的版本。黑名单规则匹配的是原始字符串,和污染后的字符串对不上。类名越过检查。方法名、字符串常量、签名——只要落在 CP 里,都能用同一招数让扫描器侧看到假字符串。 修复只需要两步。读到 CP Utf8 项的 `bytes[]` 之后,交规则引擎之前: ```php import re def from_mutf8(raw): s = raw.replace(b"\xC0\x80", b"\x00") s = re.sub( rb"\xED[\xA0-\xAF][\x80-\xBF]\xED[\xB0-\xBF][\x80-\xBF]", lambda m: chr( 0x10000 + (((m[0])[0] & 0x0F) << 18) | (((m[0])[1] & 0x3F) << 12) | (((m[0])[2] & 0x3F) << 6) | (((m[0])[4] & 0x0F) << 6) | ((m[0])[5] & 0x3F) ).encode("utf-8"), s, ) return s.decode("utf-8") ``` `C0 80` → `00`,六字节代理对 → 增补码位。两步过后,CP 里的字符串和标准 UTF-8 保持了一致,扫描器不再看到假数据。 不感知 MUTF-8 的静态分析工具,在读 class 文件 CP 的第一刻就已经站在了盲区里。两处字节差而已,后果是 grep 漏串、规则绕行、恶意字符串穿越扫描链。
发表于 2026-09-02 09:00:02
阅读 ( 2845 )
分类:
代码审计
0 推荐
收藏
0 条评论
Dracarys
信息安全工程师
10 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!