「JavaWeb审计盲点」JSON反序列化 Key 顺序绕过 Setter 校验
漏洞分析
JSON 反序列化时部分框架按 key 顺序逐个调用 setter,研发写在 setter 里的跨字段校验看似严谨,实际上攻击者只需调换字段先后顺序即可让其静默失效,从而达到漏洞利用的效果。
0x00 前言 ======= 随着攻防对抗的不断深入,后端开发时逐渐已经达成基本的安全共识——用户输入不可信,必须在服务端做好相关的限制。例如金额不能为负、抵扣不能超过订单总额、数量不能超过库存上限等。 这类规则遍布每个业务系统,写法也五花八门:注解校验、Controller 里判断、Service 里判断、Aspect处理等等,以及本文的主角——**写在 setter 里**。 0.1 **为什么研发喜欢在 setter 里做逻辑** ---------------------------- setter 在Java应用中主要是用于封装,字段私有,通过方法控制读写。但很多时候,setter 经常被赋予更多职责,而且这种写法有充分的"合理性": - **就近防御**:校验和赋值放在一起,"任何途径给这个字段赋值都绕不过校验",看起来确实是最不容易漏的防御位置; - **数据补全**:在 `setOrderId()` 里顺手查出订单金额、在 `setParentId()` 里加载父节点,setter 承担关联查询和数据初始化非常常见; - **简单方便**:某个属性可能在多个Controller都会用到,多个Controller重复校验比较麻烦。 - **顺手为之**:IDE 生成 setter 后,加两行校验是最低成本的"加固",直观明了,也不涉及跨文件,在项目交接时不用大费周章地去理解切面,注解等各种复杂的设计逻辑。 **0.2 是否会存在安全风险** ----------------- 例如下面的例子: ```Java public void setUsePoints(Long usePoints) { // 风控:积分抵扣金额不能超过订单金额 BigDecimal deduct = new BigDecimal(usePoints).divide(new BigDecimal("100")); if (this.orderAmount != null && deduct.compareTo(this.orderAmount) > 0) { throw new IllegalArgumentException("积分抵扣金额不能超过订单金额"); } this.usePoints = usePoints; } ``` 判空逻辑、边界、异常捕获都有,尝试提交 `{"orderAmount":100,"usePoints":50000}` 时会因为抵扣金额超过订单金额而被拦截。初看下貌似不存在什么潜在的安全风险。 这里可以思考两个问题: 1. **这段代码在什么时机被执行?** - 如果它运行在对象构建的**中间态**:执行时,其他字段可能还没有被赋值。 2. **这段代码以什么顺序被执行?** - JSON 反序列化时,如果对应的JSON解析框架按请求方控制的字段顺序逐个调用 setter,结合问题1的假设,只要让 `usePoints` 先于 `orderAmount` 出现在请求体里,此时校验执行时 `orderAmount` 还是 `null`,`if` 不成立,风控静默跳过,随后的 `setOrderAmount` 再把金额写进去,一个抵扣 500 元、实付 -400 元的订单貌似就“合法”地产生了。 **同一套代码、同样的字段、同样的值,唯一不同的是 key 的顺序**。下面看一个具体的例子: 0x01 相关风险案例 =========== 看一个实际的业务场景,某商城通过在请求时提供订单号(orderId)以及本次消费使用的积分(usePoints)完成相应的积分抵扣优惠操作。 目前有如下的限制: - 订单金额由服务端按照订单号查单确定,不接受客户端交的金额。 - 积分抵扣(100积分可抵扣1元),由用户自行输入。 - 服务端校验了抵扣金额不能超过订单金额,用于防止积分倒冲的风险。 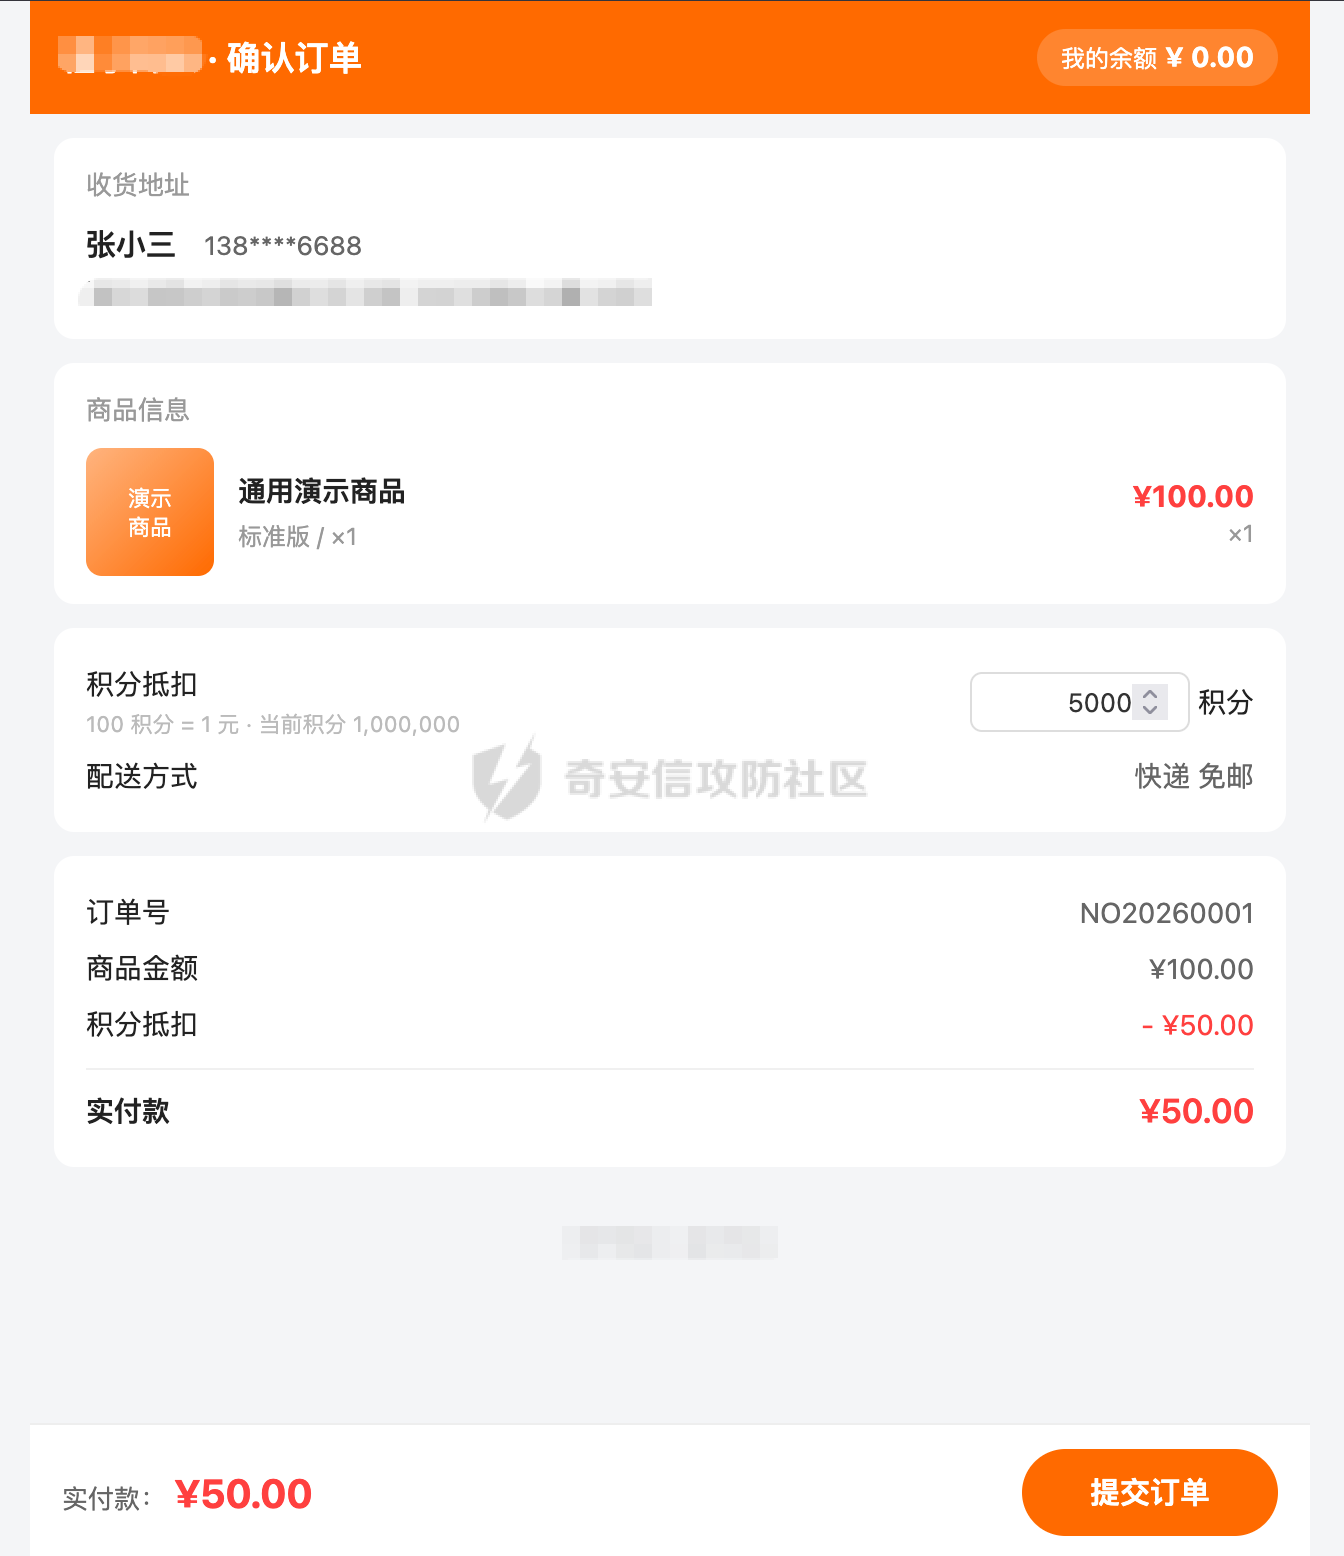 正常情况下,使用100积分进行请求,成功抵扣1元,最终100元的商品,只需付款99元: 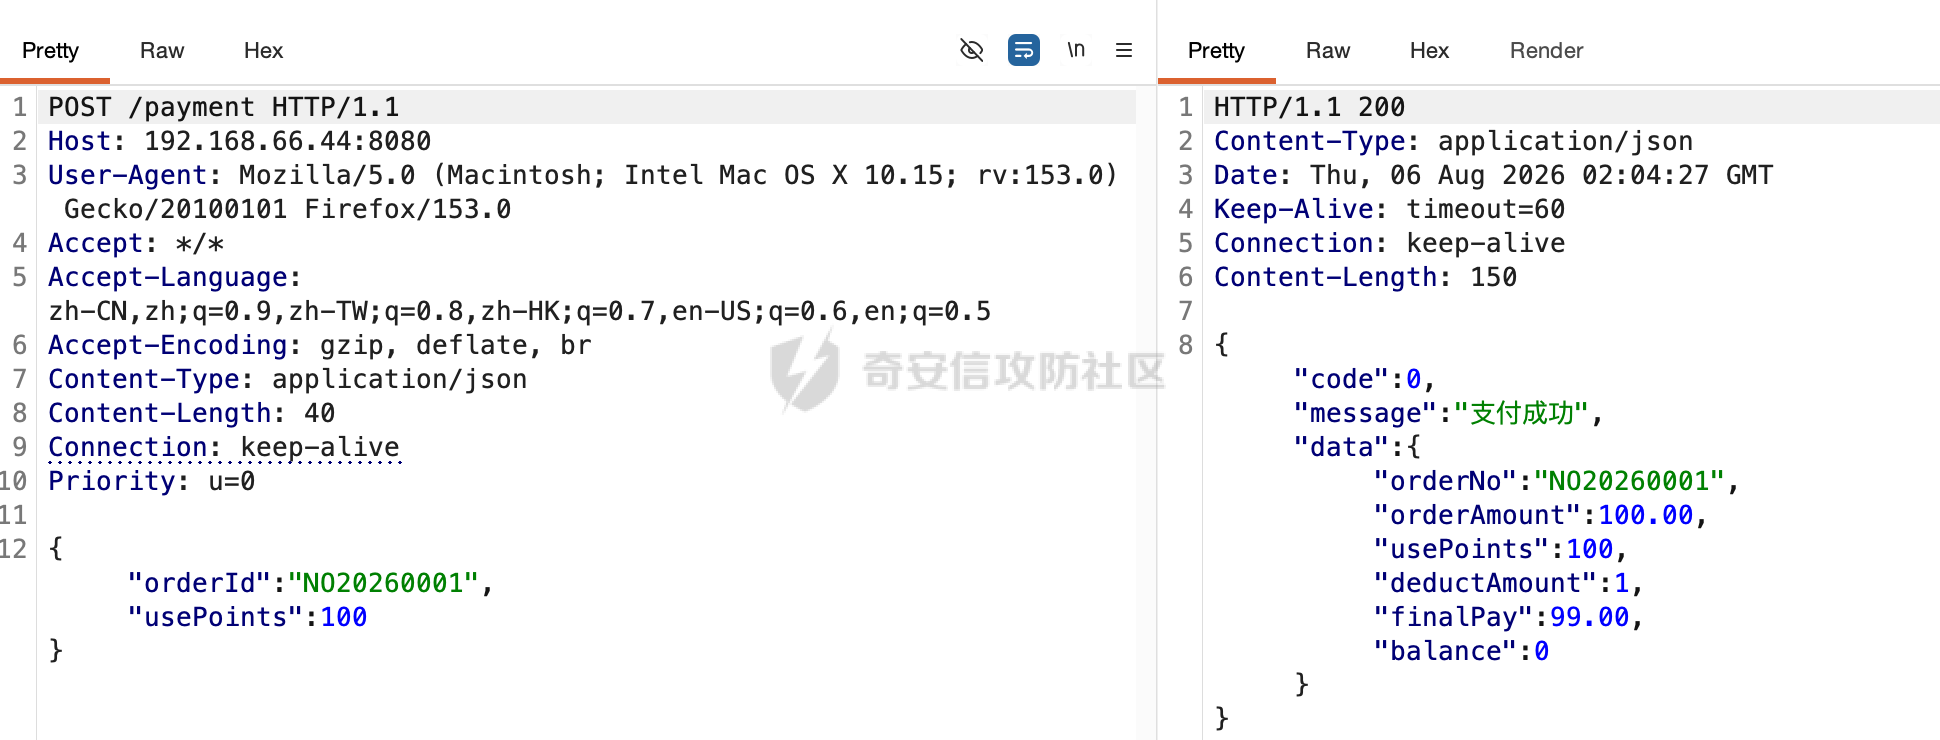 尝试使用100000积分抵扣,由于超过了订单金额,无法成功付款: 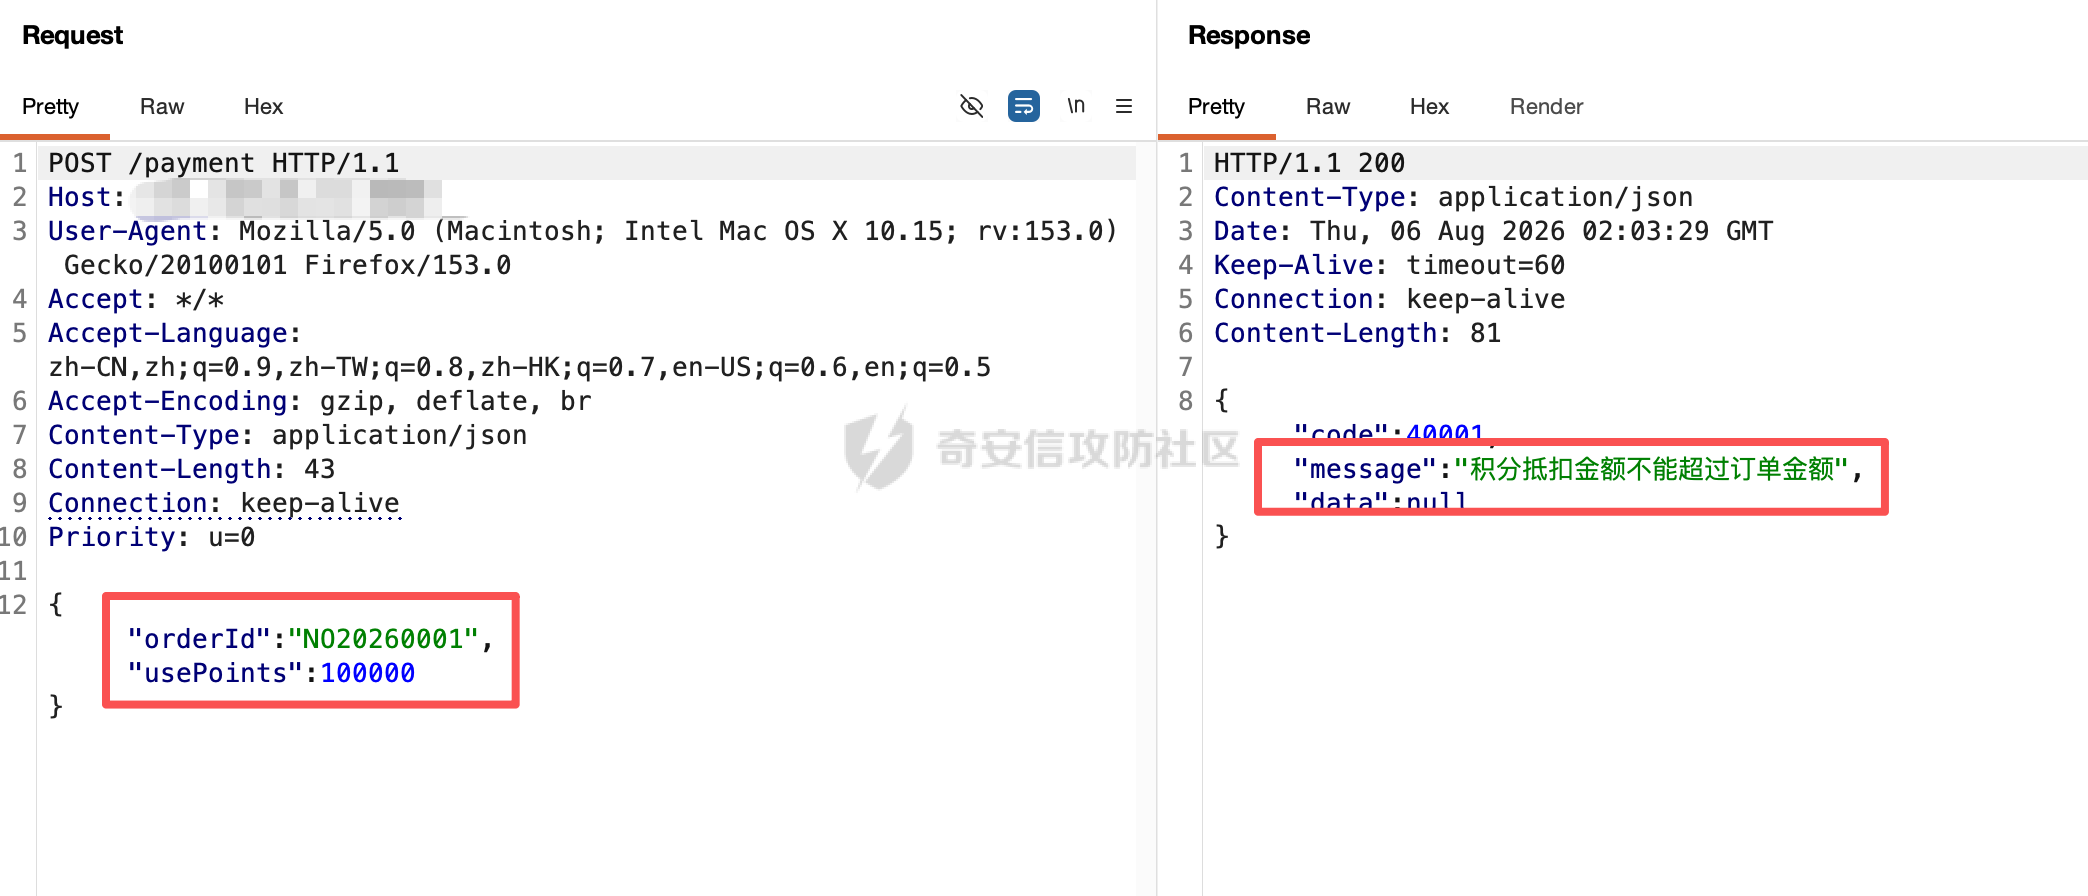 看看具体的防护方式,主要是在PaymentDTO的usePoints属性的setter方法处理的,这里限制了使用积分不能为负,以及积分抵扣金额不能超过订单金额: ```Java public void setOrderId(String orderId) { this.orderId = orderId; // 查单:订单金额以服务端订单库为准 this.orderAmount = getAmountByOrderId(orderId); } public void setUsePoints(Long usePoints) { log.info("[setter] setUsePoints({}) 被调用, 当前 orderAmount={}", usePoints, this.orderAmount); if (usePoints == null) { return; } if (usePoints < 0) { throw new IllegalArgumentException("使用积分不能为负"); } // 风控规则:积分抵扣金额不能超过订单金额。 BigDecimal deduct = new BigDecimal(usePoints).divide(POINTS_PER_YUAN); if (this.orderAmount != null && deduct.compareTo(this.orderAmount) > 0) { throw new IllegalArgumentException("积分抵扣金额不能超过订单金额"); } this.usePoints = usePoints; } ``` 包括在后续service层,也对订单状态,积分余额等关键条件进行了校验。 按照前面的猜想,如果对应的json解析器(这里是jackson)在解析时,会按请求方控制的字段顺序逐个调用 setter,那么此时是不是可以**尝试先让usePoints在前,此时orderAmount还没解析(还没获取到OrderId),为null**,那积分抵扣金额不能超过订单金额这道防线就形同虚设了? 可以看到,确实交换顺序后,以100000积分成功付款,并且额外的900块并入到了用户的账户里: 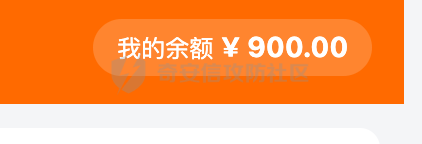 在这个案例里每个 setter 单独看逻辑都正确,功能测试(按正常顺序提交)全部通过,并且一般的SAST工具将 POJO 视为数据终点,并不会对"setter 执行顺序"维度进行建模,一般情况下很难扫描出来类似的风险。 0x02 原理分析 ========= 一般情况下,Jackson 对普通 Bean 的反序列化是**单遍流式绑定:**会按请求体中 JSON key 出现的字节顺序,逐个调用对应的 setter。 这也就解释了上面的漏洞场景,如果某个 setter 内部的校验逻辑依赖**兄弟字段的当前值**(例如"免单订单金额必须为 0"),**攻击者只需调整 JSON 中 key 的先后顺序,让校验先执行、被依赖字段后赋值,即可使校验失效。** 下面以Jackson为例,看看setter方法的解析过程。 2.1 jackson setter方法解析 ---------------------- 以com.fasterxml.jackson.core:jackson-databind:2.12.6.1为例: 相关DTO: ```TypeScript public static class SimpleDTO { private String alpha; private String beta; private String gamma; public String getAlpha() { return alpha; } public void setAlpha(String alpha) { this.alpha = alpha; } public String getBeta() { return beta; } public void setBeta(String beta) { this.beta = beta; } public String getGamma() { return gamma; } public void setGamma(String gamma) { this.gamma = gamma; } } ``` 具体解析,断点下在readValue方法: ```Java String json = args.length > 0 ? args[0] : "{\"alpha\":\"A\",\"beta\":\"B\",\"gamma\":\"C\"}"; ObjectMapper om = new ObjectMapper(); PaymentDTO dto = om.readValue(json, SimpleDTO.class); ``` readValue()是通过构造\_readMapAndClose(JsonParser jp, JavaType valueType)方法所需要的参数,来调用解析JSON数据的: 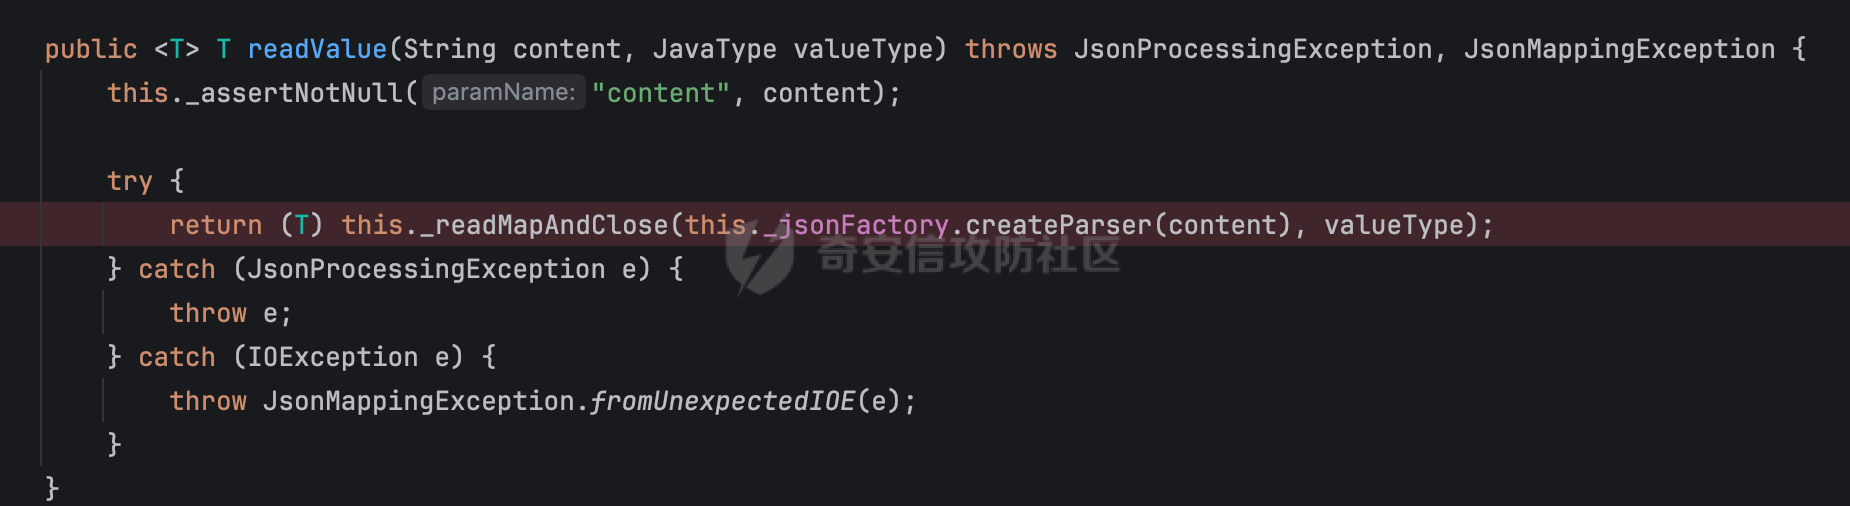 在\_readMapAndClose方法中,首先调用 \_initForReading 方法初始化解析器,并创建 DefaultDeserializationContext 上下文对象,然后读取 JsonToken并根据类型处理数据,如果不是 `END_ARRAY` 或 `END_OBJECT`,则调用上下文的 `readRootValue` 方法来处理,这里会调用\_findRootDeserializer方法来查找现有的反序列化器: 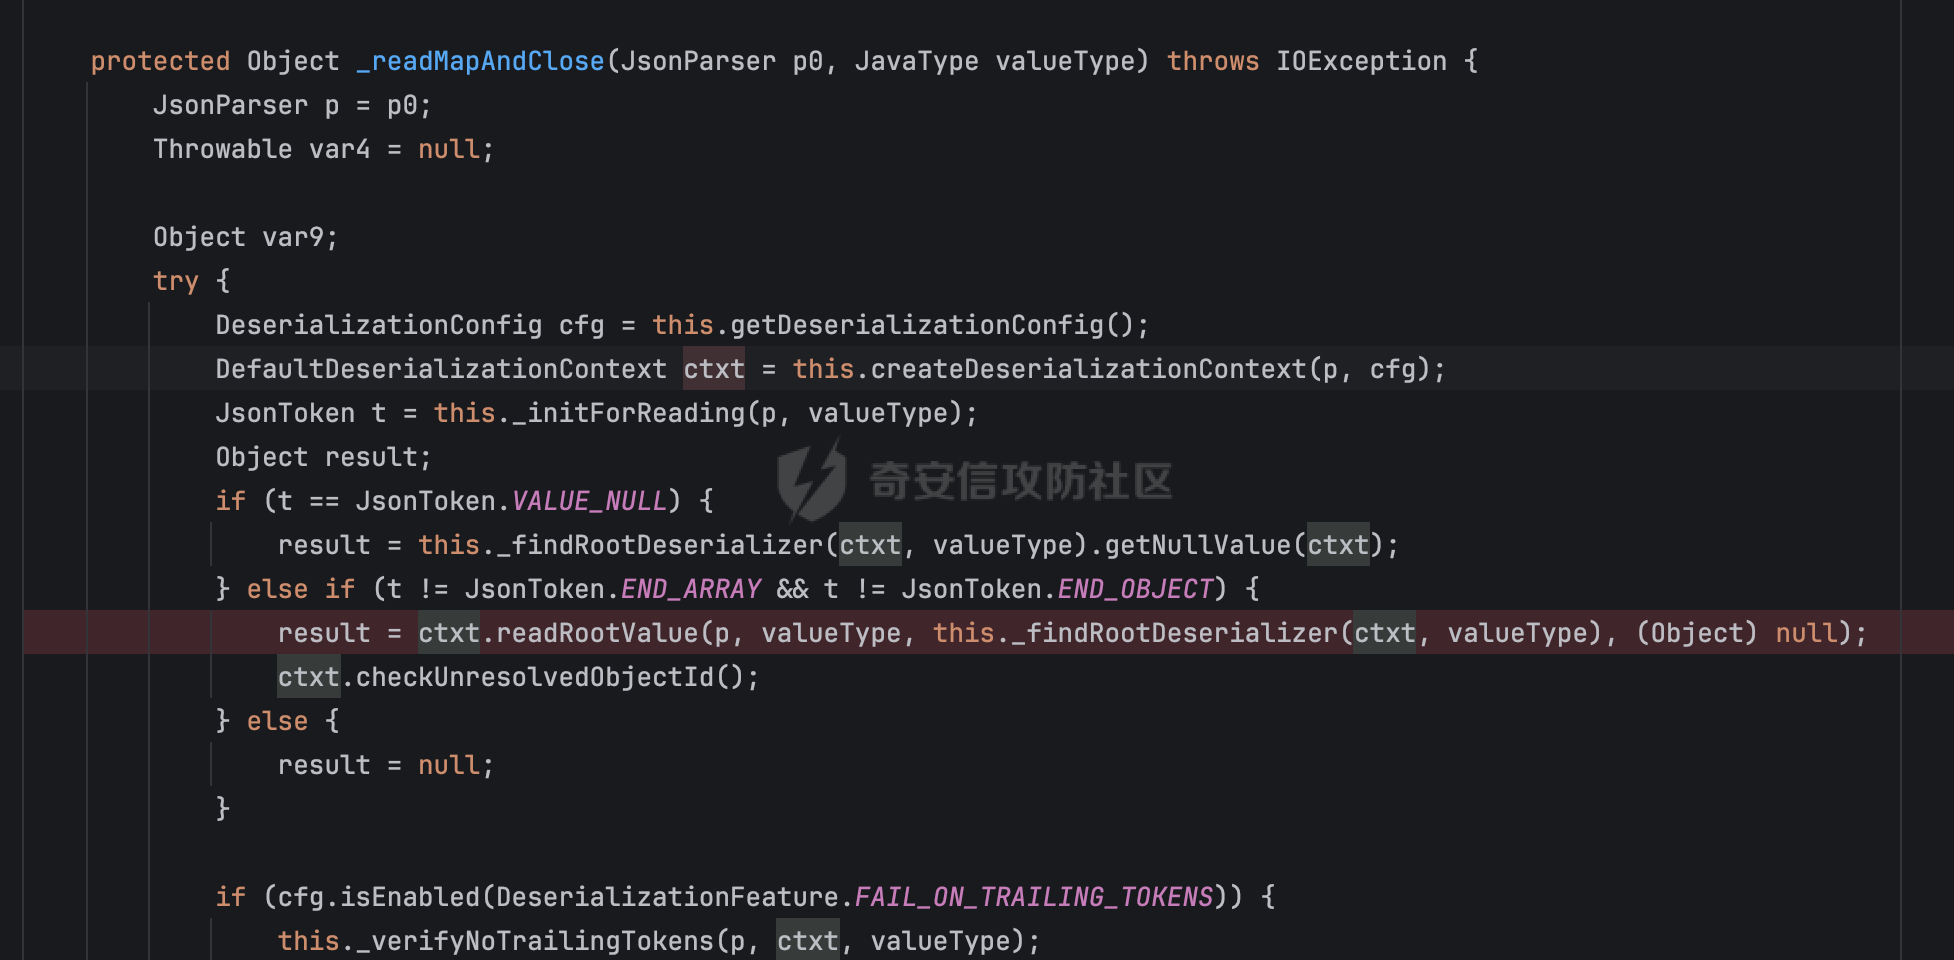 然后会调用DefaultSerializationContext的readRootValue方法,最后进入到BeanDeserializer类执行逻辑中,在deserialize方法中中会根据 JSON 数据的不同类型调用不同的处理方法: 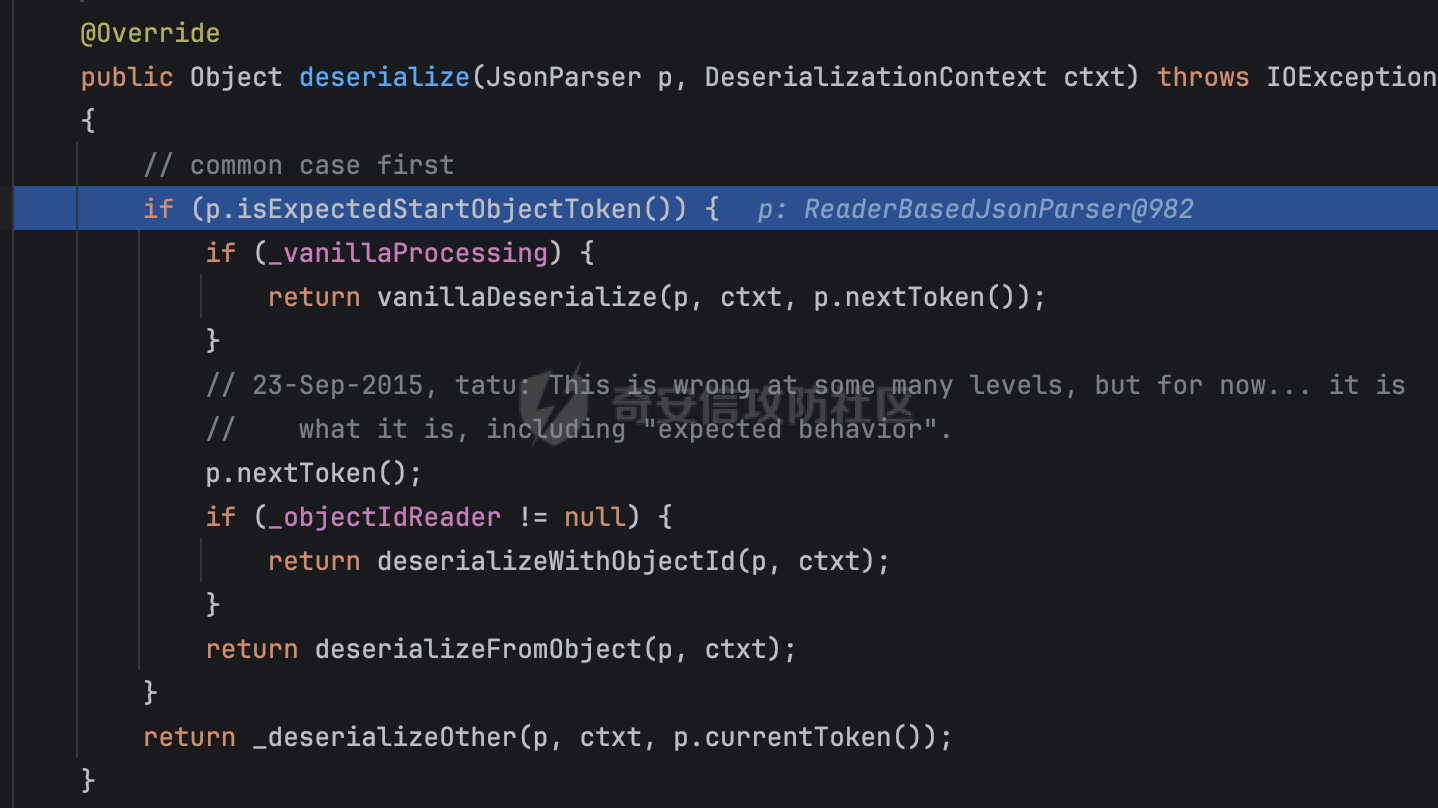 在vanillaDeserialize方法的实现中,这里会通过p.currentName() 获取当前 JSON 对象的字段名,并进入一个循环,遍历所有字段。 对于每个字段,使用 this.\_beanProperties.find(propName) 查找对应的属性。如果找到了,则调用 prop.deserializeAndSet(p, ctxt, bean) 方法反序列化字段值并设置到 bean 对象中,然后调用nextFieldName直至解析完成: 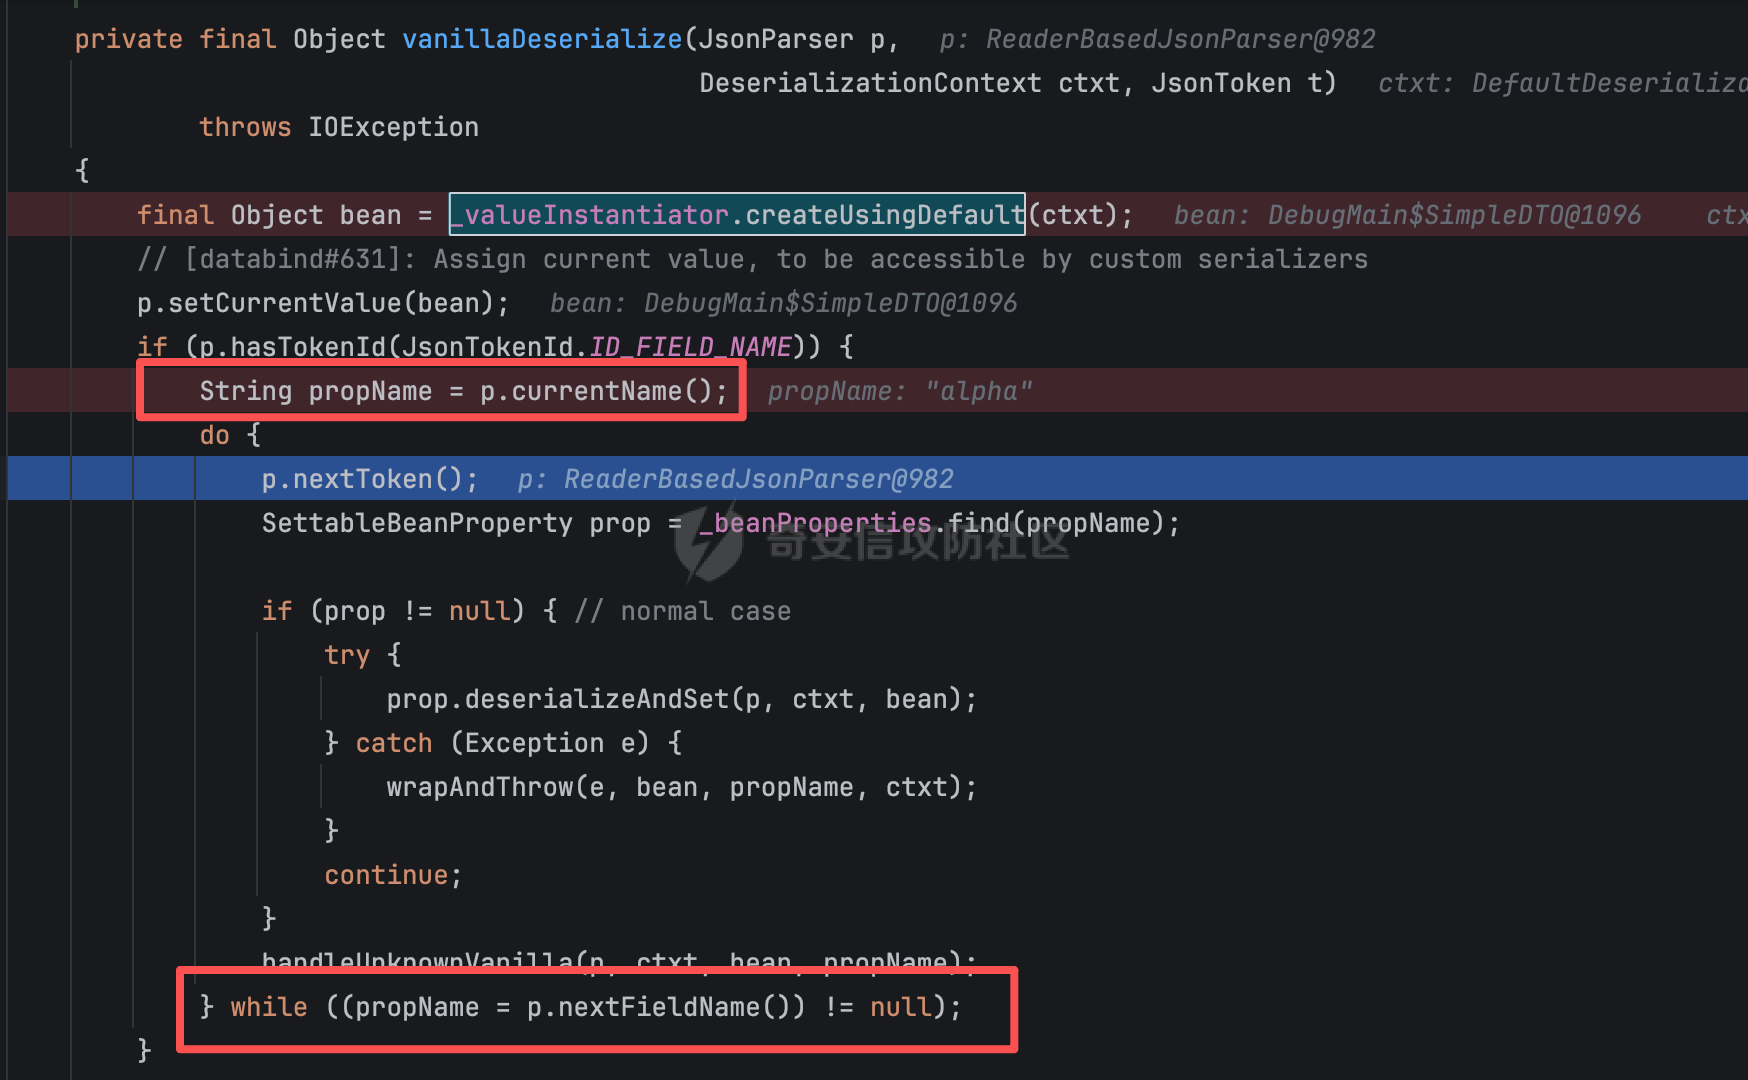 从堆栈中也可以看到,当前第一个拿到的属性与解析的字符串第一个属性一致,都是alpha: 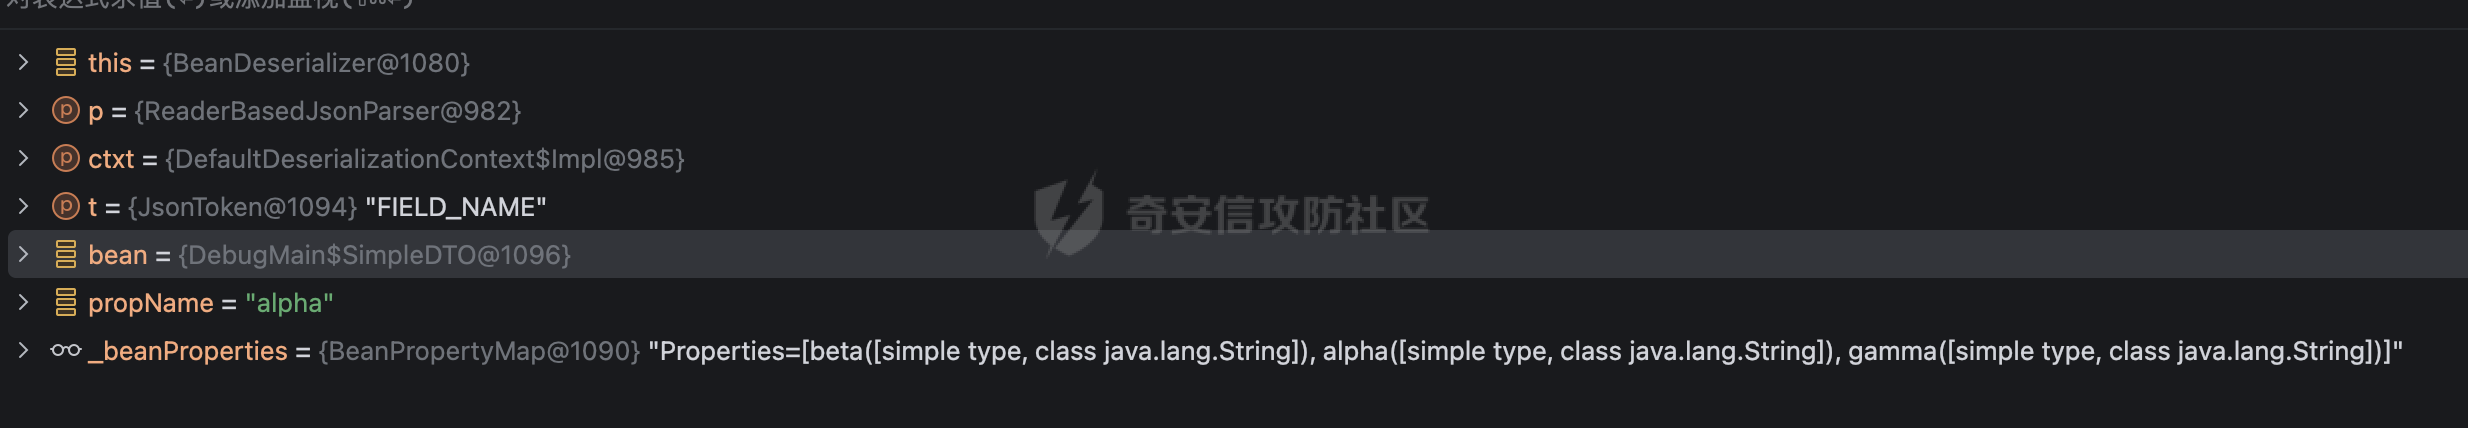 从getCurrentName也可以看到,主要按字节流顺序获取key进行setter方法的调用: 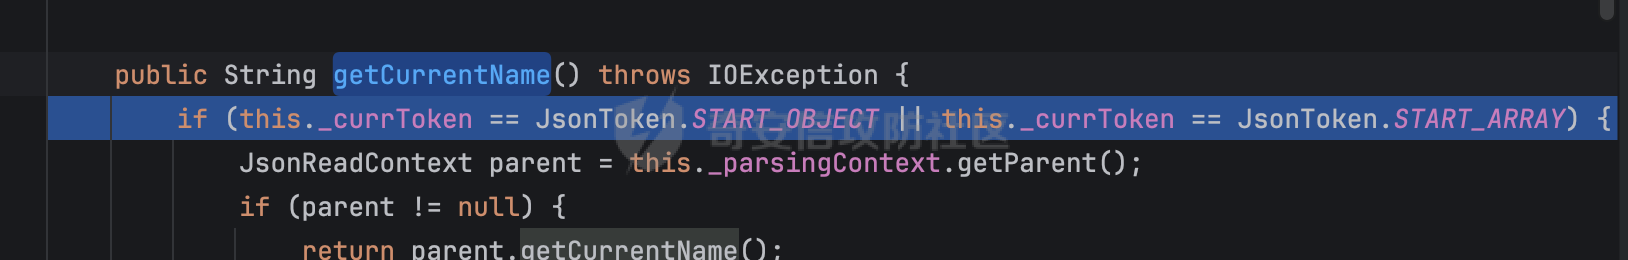 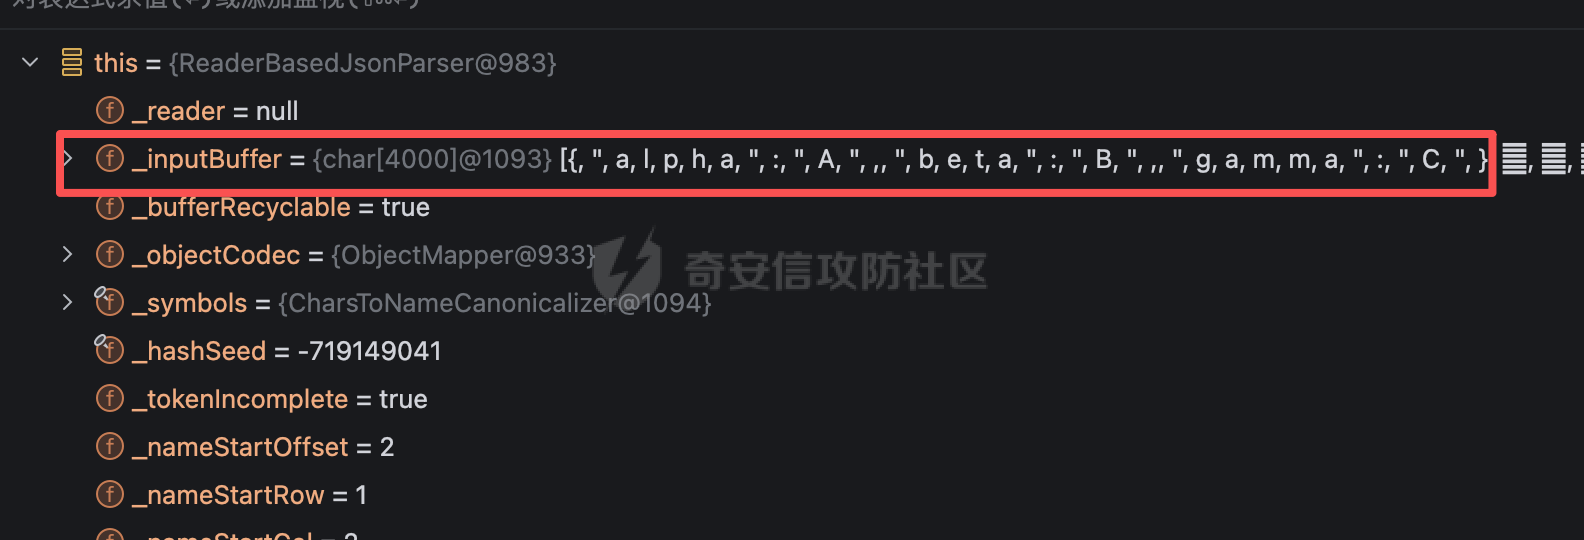 综上,这也就解释了为什么替换json属性顺序后,会造成积分倒冲的风险。 2.2 @JsonCreator注解 ------------------ @JsonCreator 注解是 Jackson 库中用于指定如何从 JSON 数据创建 Java 对象实例的一个重要工具。 它允许你定义一个静态方法(通常是构造函数或静态工厂方法),Jackson 在反序列化时会调用这个方法来生成对象实例。 跟前面的案例不同,**通过@JsonCreator 生成实例时,利用 property-based 路径的缓冲特性,构造时拿到全量参数,消除了"构建中间态"的问题,让跨字段校验变得可行。** 从解析流程上看,该方式会通过BeanDeserializer#\_deserializeUsingPropertyBased进行处理,在方式上,creator 属性会先存起来: 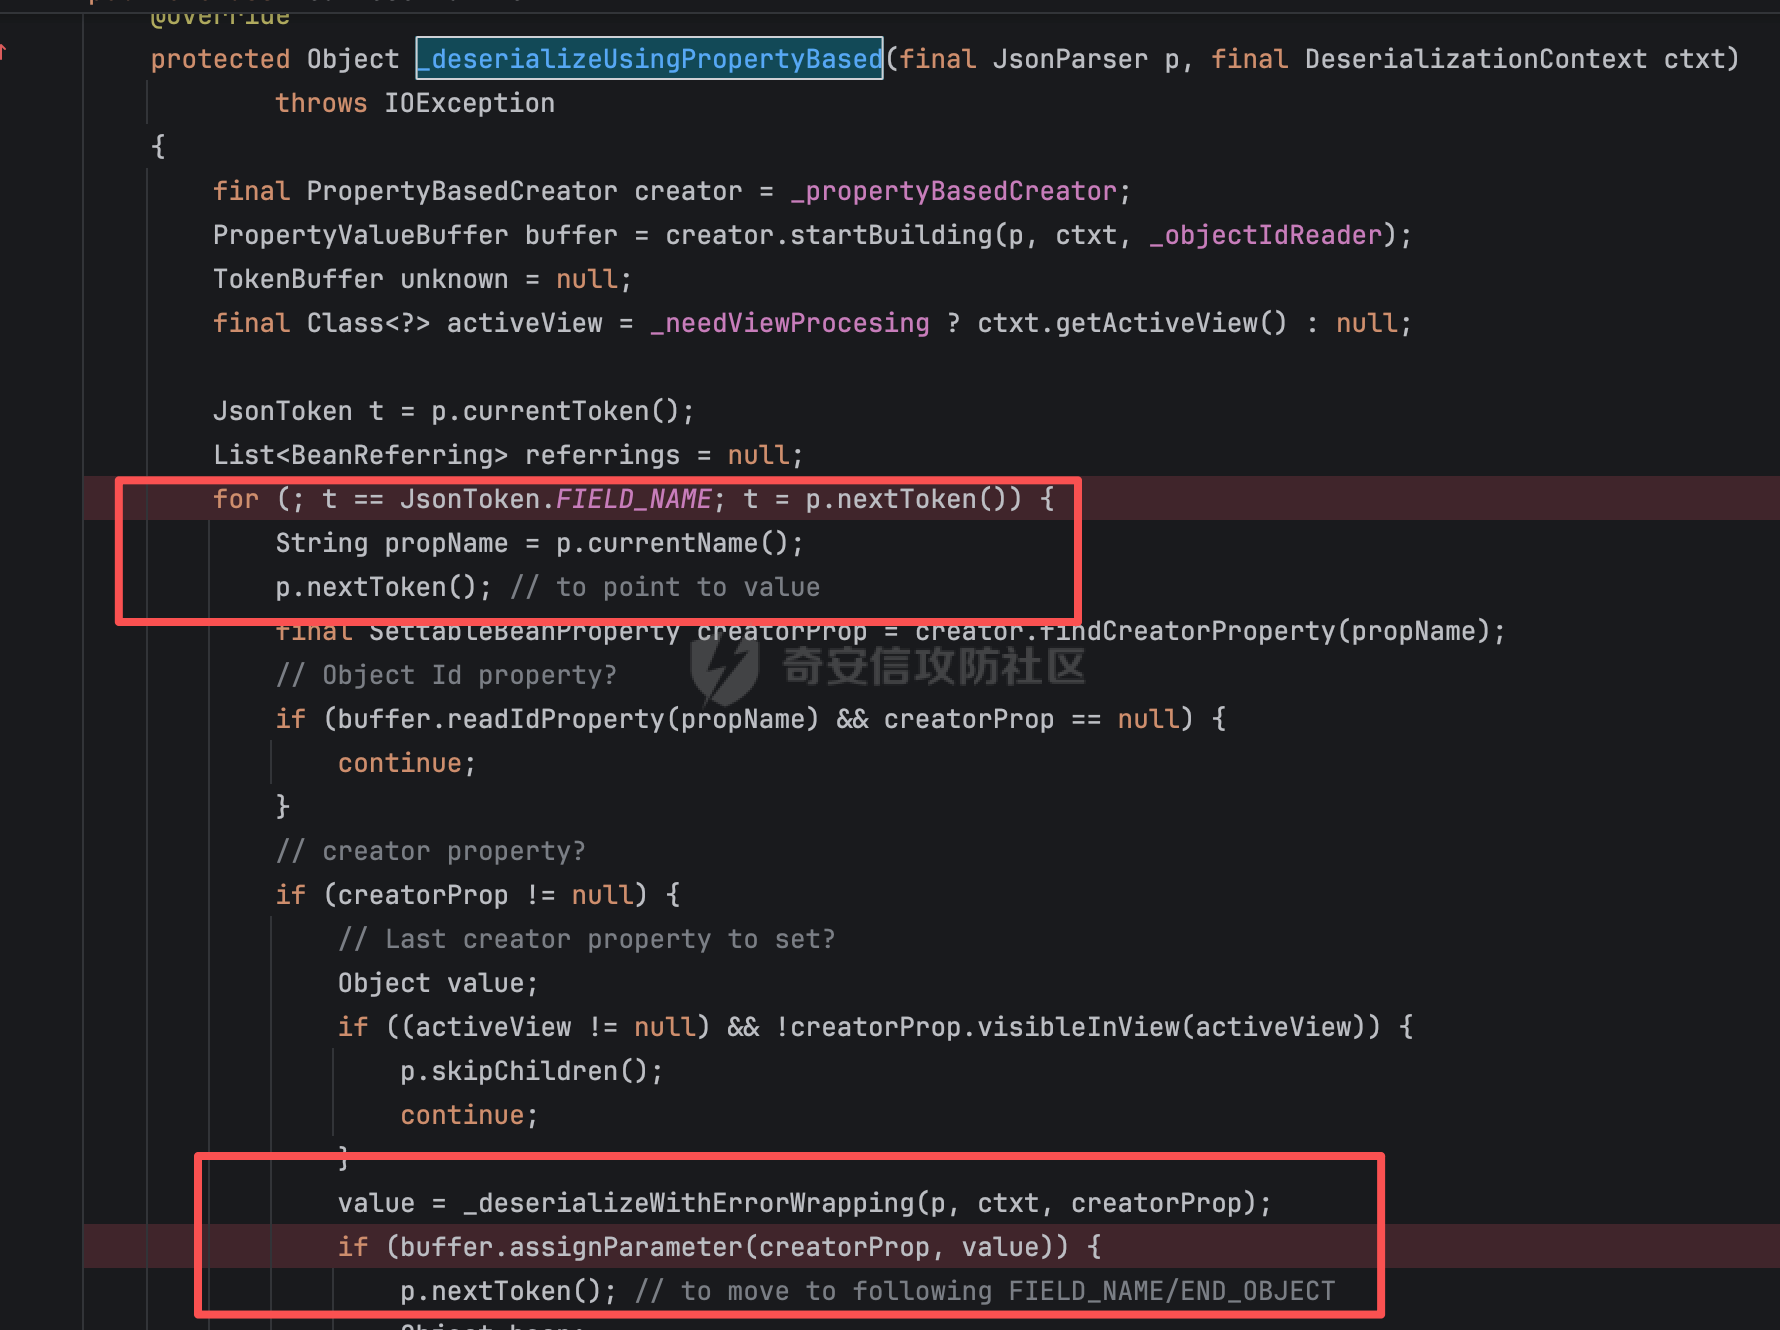 在PropertyValueBuffer#assignParamete按构造参数下标存起来: 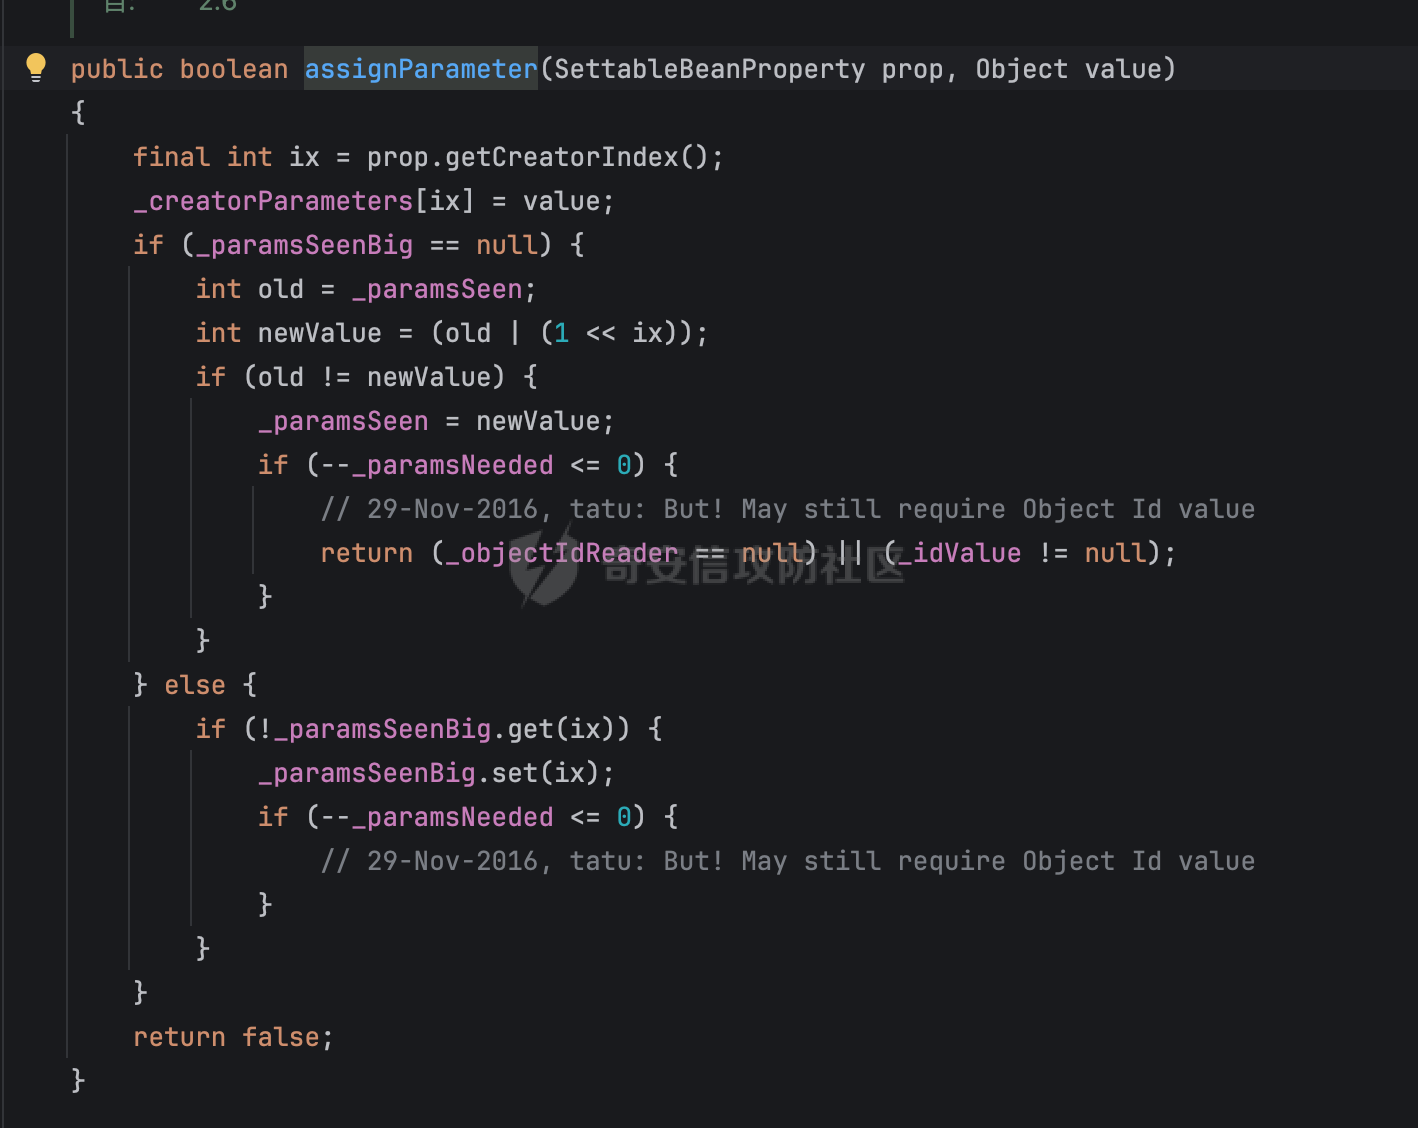 最后判定收齐后,一次性调用build方法进行赋值操作: 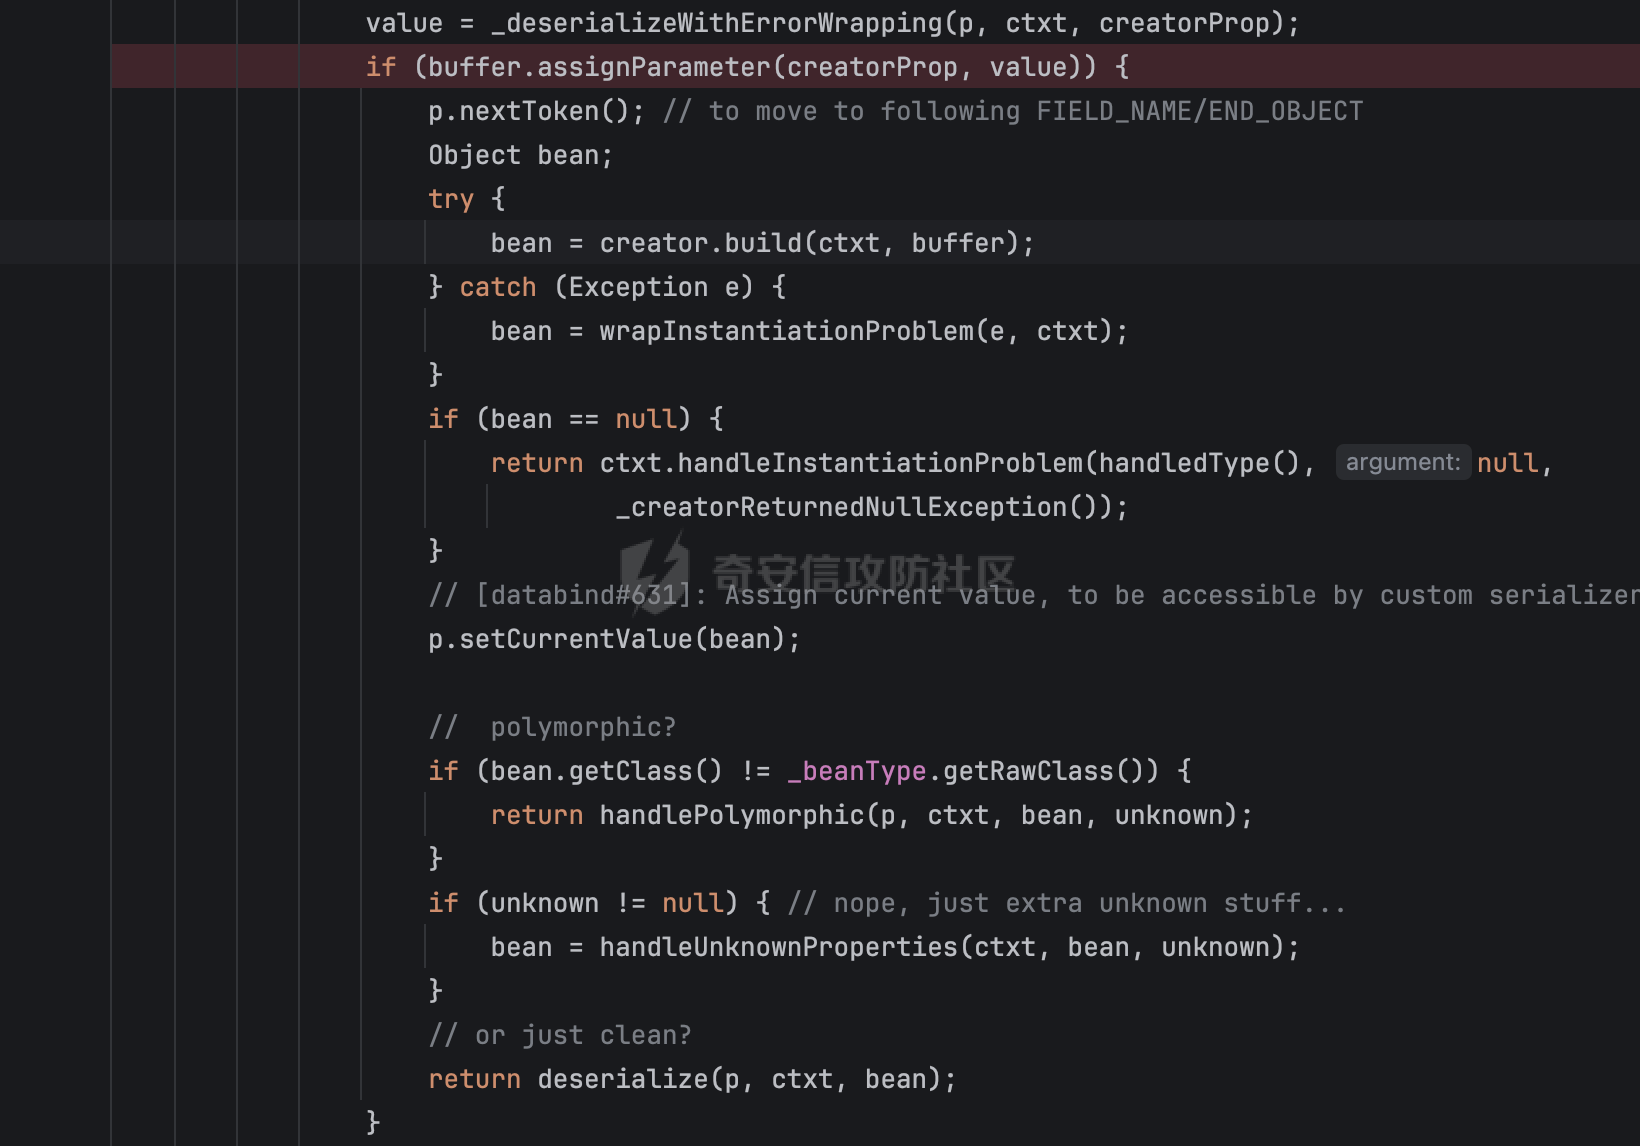 通过下面的例子证明: ```Java public class CreatorProofMain { private static final BigDecimal POINTS_PER_YUAN = new BigDecimal("100"); public static class CreatorOrderDTO { private final BigDecimal orderAmount; private final Long usePoints; @JsonCreator public CreatorOrderDTO(@JsonProperty("orderAmount") BigDecimal orderAmount, @JsonProperty("usePoints") Long usePoints) { System.out.println("[构造] @JsonCreator 构造函数被调用: orderAmount=" + orderAmount + ", usePoints=" + usePoints); if (usePoints != null && orderAmount != null) { BigDecimal deduct = new BigDecimal(usePoints).divide(POINTS_PER_YUAN); if (deduct.compareTo(orderAmount) > 0) { throw new IllegalArgumentException("积分抵扣金额不能超过订单金额"); } } this.orderAmount = orderAmount; this.usePoints = usePoints; } public BigDecimal getOrderAmount() { return orderAmount; } public Long getUsePoints() { return usePoints; } } public static void main(String[] args) throws Exception { String json = args.length > 0 ? args[0] : "{\"usePoints\":50000,\"orderAmount\":100}"; System.out.println("INPUT: " + json + " ← 攻击顺序(usePoints 在前)"); System.out.println("---- 反序列化开始 ----"); CreatorOrderDTO dto = new ObjectMapper().readValue(json, CreatorOrderDTO.class); System.out.println("---- 反序列化结束 ----"); System.out.println("RESULT: orderAmount=" + dto.getOrderAmount() + ", usePoints=" + dto.getUsePoints()); } } ``` 同样的模拟场景在修改顺序后并没有达到绕过检验的效果: 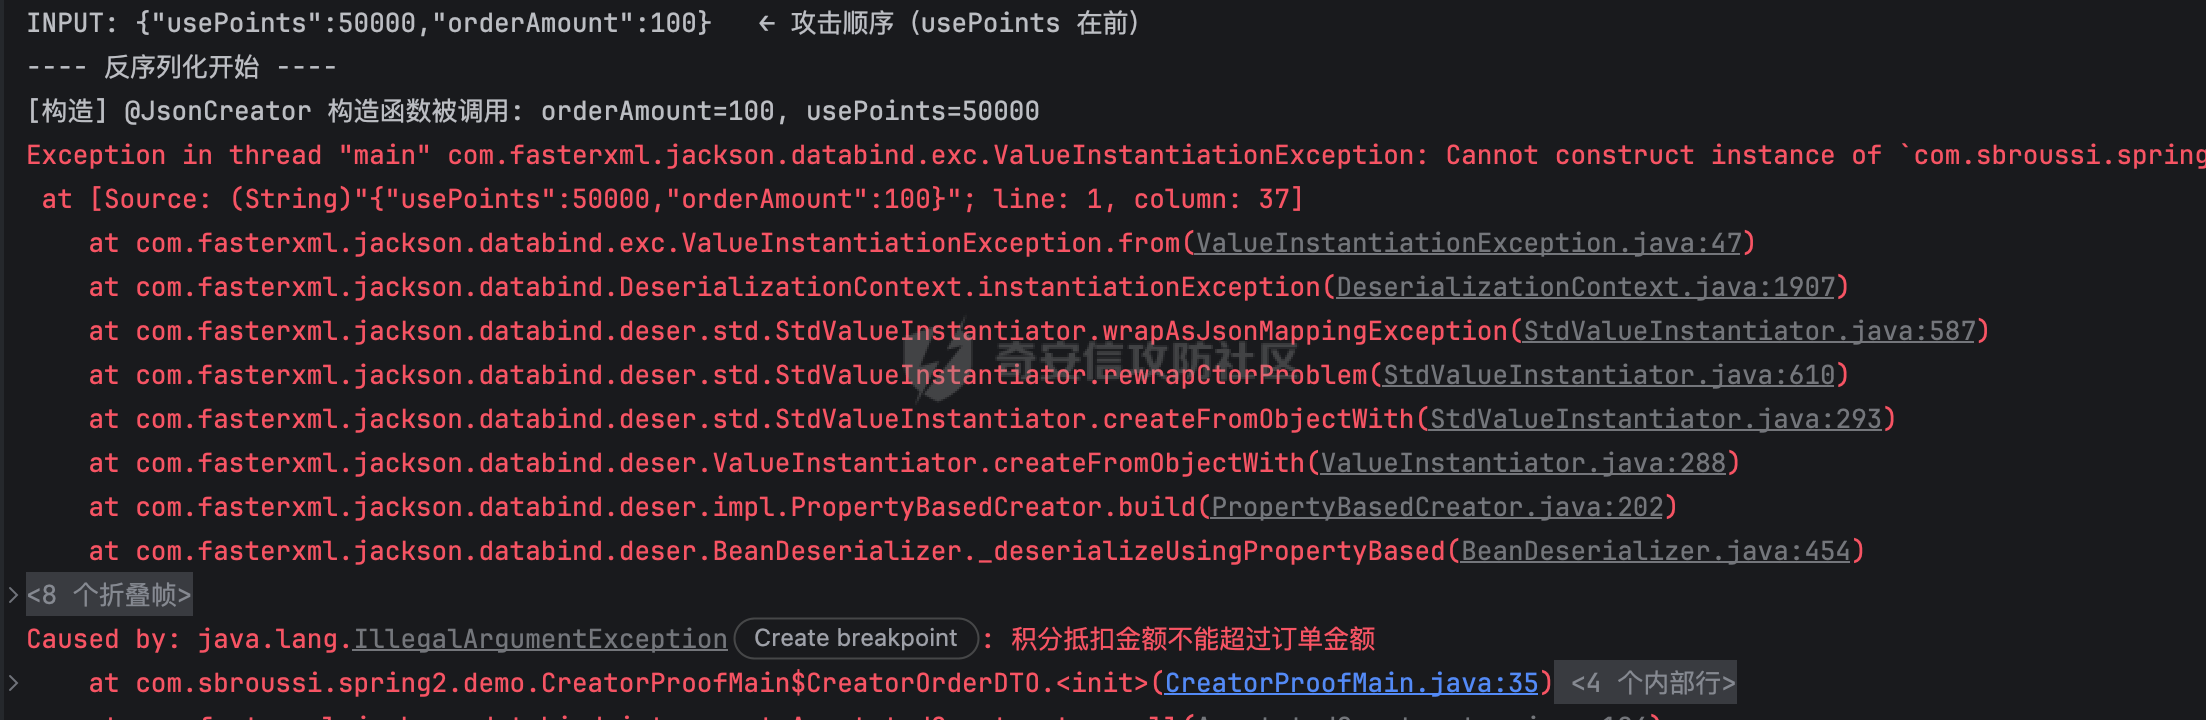 2.3 修复方式 -------- | | | | |---|---|---| | 方式 | 说明 | 备注 | | 绑定完成后统一校验(本 demo 采用) | setter 保持纯赋值,不变量校验放在业务方法/Controller 入口 | 改动最小 | | @JsonCreator 构造函数校验 | 利用 property-based 路径的缓冲特性,构造时拿到全量参数 | 框架层面根因消除,同时获得不可变对象 | | 自定义 JsonDeserializer | 自行控制解析与校验时序 | 灵活但维护成本高 | 注意:jackson中`@JsonPropertyOrder` 只影响**序列化**输出顺序,不能约束反序列化时的 key 处理顺序,不是修复手段。 2.4 其他Json解析器 ------------- 用同构 DTO(`setUsePoints` 内校验"抵扣 ≤ 订单金额")对Fastjson跟FastJson2分别验证: | | | | |---|---|---| | | 正常顺序 {"orderAmount":100,"usePoints":50000} | 攻击顺序 {"usePoints":50000,"orderAmount":100} | | fastjson 1.2.83 | 校验生效,抛异常 | 绕过,校验时 orderAmount=null | | fastjson2 2.0.62 | 校验生效,抛异常 | 绕过,同上 | 默认情况下,与 Jackson 完全一致,遇到 key 立即调 setter,顺序由请求方决定。篇幅有限就不深入代码分析了,有兴趣的师傅可以一起探讨下。 0x03 其他 ======= 在审计这类问题时,可以对`setter 内引用 this. 其他属性字段做判断`的写法进行全局搜索,高发漏洞场景一般集中在金额抵扣、配额上限、审批开关这类跨字段约束上,在审计时可以额外关注。
发表于 2026-09-03 09:00:02
阅读 ( 2878 )
分类:
代码审计
2 推荐
收藏
0 条评论
tkswifty
73 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!