CVE-2026-53362: 一个Linux内核漏洞为什么价值9w+$
漏洞分析
CVE-2026-53362 是Linux内核IPv6模块中可本地提权的高危漏洞,Google Kernel CTF为该漏洞支付了9w+$的赏金,本文将结合Linux内核源码对该漏洞的成因进行详细分析
前言 -- 分析一个在 Google Kernel CTF 中价值9w+$的漏洞(exp522). 背景知识 ---- ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#%E6%96%87%E4%BB%B6%E9%A1%B5%E7%BC%93%E5%AD%98 "文件页缓存")文件页缓存 为了提升对文件的读写效率,Linux 内核会以页大小(4KB)为单位,将文件划分为多数据块。当用户对文件中的某个数据块进行读写操作时,内核首先会申请一个内存页(称为 页缓存)与文件中的数据块进行绑定。 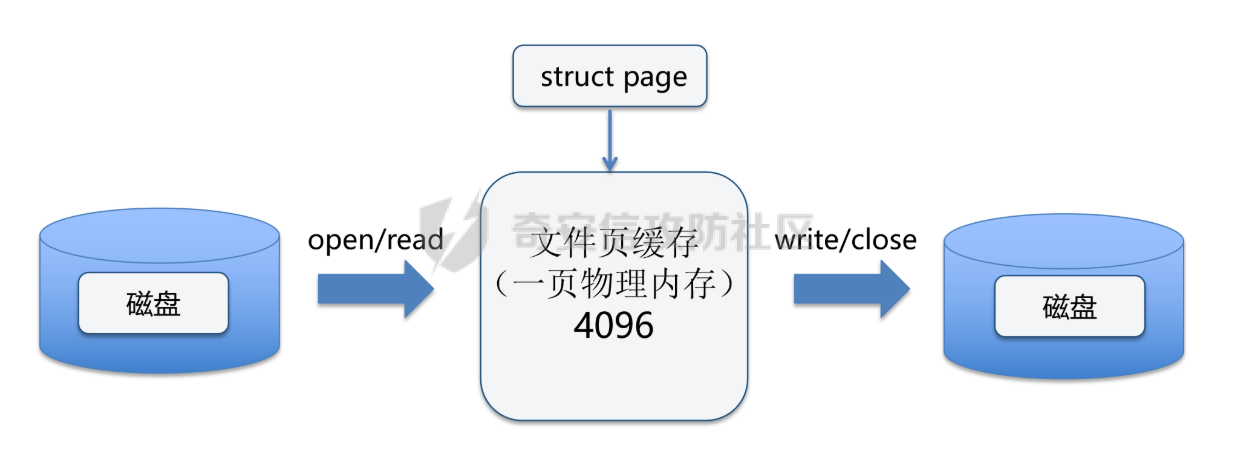 ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#pipe-%E7%AE%A1%E9%81%93 "pipe 管道")pipe 管道 管道是一种进程间通信机制,也是Linux操作系统中的一种文件形式。一个进程写入管道的数据可以被另一个进程读取。数据按先进先出顺序处理。 pipe\_buffer 是 Linux 内核管理管道页面的重要结构体,其中page成员指向一个page结构体(实际管理一个内存页面),offset表示正在读取当前内存页的偏移量(可以简单理解为读指针),len则用于表示当前内存页拥有未读数据的长度(可以简单理解为写指针),ops则是管道的回调函数表(注册如read、write、release等函数): ```c struct pipe_buffer { struct page *page; unsigned int offset, len; const struct pipe_buf_operations *ops; unsigned int flags; unsigned long private; }; ``` 两个进程可以通过管道进行通信,进程A从管道的一头写入数据,进程B则从管道的另一头读出数据,示例如下: ```c #include <stdio.h> #include <stdlib.h> int main(){ int pipefd[2]; pipe(pipefd); // 创建管道 if(!fork()){ // 进程A write(pipefd[1], "AAAAAAAA", 8); // 向管道中写入数据 exit(0); } // 进程B char buff[20]; read(pipefd[0], buff, 8); // 从管道中读出数据 } ``` ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#splice-%E7%B3%BB%E7%BB%9F%E8%B0%83%E7%94%A8 "splice 系统调用")splice 系统调用 splice 是Linux系统调用, 用于在两个文件描述符之间高效地移动数据, 而无需将数据复制到用户空间。 将一个文件的内容拷贝到另一个文件中的示例代码如下: ```c int func(char *file1, char *file2){ ... char buf[4096]; int fd1 = open(file1, O_RDONLY); int fd2 = open(file2, O_RDWR); read(fd1, buf, 4096); write(fd2, buf, 4096); ... } ``` 可以看到文件内容先被read系统调用从磁盘中拷贝到文件页缓存中,然后再被读入到用户态缓冲区; 之后write系统调用将文件内容从用户态缓冲区拷贝到file2的文件页缓存中,并最终被写回到磁盘中; splice最直观的一个作用就是将文件的页缓存直接挂到pipe\_buffer的page指针上,实现**页面的复用**,使用splice加速文件拷贝的示例代码如下: ```c int func(char *file1, char *file2){ ... int pipefd[2]; pipe(pipefd); // 创建管道 int fd1 = open(file1, O_RDONLY); int fd2 = open(file2, O_RDWR); splice(fd1, NULL, pipefd[1], NULL, 4096, SPLICE_F_MOVE|SPLICE_F_MORE); splice(pipefd[0], NULL, fd2, NULL, 4096, SPLICE_F_MOVE|SPLICE_F_MORE); ... } ``` 上述代码中,第一个splice实现了将file1的文件页缓存挂到了pipe\_buffer的page指针中; 第二个splice把pipe中的数据拷贝到file2的文件页缓存中,(通常file1和file2不会共用同一个page cache,所以这里发生了一次拷贝); 综上所述,使用splice可以减少一个文件内容的拷贝。 ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#SPLICE-F-MORE "SPLICE_F_MORE")SPLICE\_F\_MORE 用户可以通过 splice() 将 pipe 中的数据发送到 IPv6 UDP socket。当调用 splice() 时传入 SPLICE\_F\_MORE 标志位,内核会设置 MSG\_MORE 标志,并暂不发送当前 UDP 数据报,允许后续发送继续追加到同一个数据报中。 ```c splice(pipefd[0], NULL, udpfd, NULL, len, SPLICE_F_MORE); ``` ```c msg.msg_flags = MSG_SPLICE_PAGES; if (flags & SPLICE_F_MORE) msg.msg_flags |= MSG_MORE; ``` 但是当这个 UDP 报文超过出口网卡的 MTU 时,一个报文不能直接作为单个 IP 包发送,内核必须把它拆成多个 IPv6 fragment。负责构造这些 fragment 的代码位于 net/ipv6/ip6\_output.c,核心函数是\_\_ip6\_append\_data()。 > MTU:网络设备有一个最大传输单元 MTU(通常为1500字节),一个 IPv6 数据包通常不能超过 1500 字节。数据更大时,内核必须拆成多个 IPv6 fragment。 > > 但 IPv6 fragment 还有两个限制: > > 1. 每个 fragment 要预留 IPv6 头和 Fragment Header; > 2. fragment 的数据部分通常要按 8 字节对齐。 这个函数为每个 fragment 创建一个 sk\_buff。 ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#sk-buff "sk_buff")sk\_buff sk\_buff 的大致定义如下: ```c struct sk_buff { ... ... sk_buff_data_t tail; sk_buff_data_t end; unsigned char *head, *data; ... ... } ``` 其中 skb->data ~ skb->tail 之间的区域是线性数据区,然后通过 skb\_end\_pointer(skb) 计算得到skb->head + skb->end 得到 skb\_shared\_info 的位置,skb\_shared\_info 用于管理 sk\_buff 的共享数据区,sk\_buff的线性数据区和shard\_info之间的布局关系如下图所示: 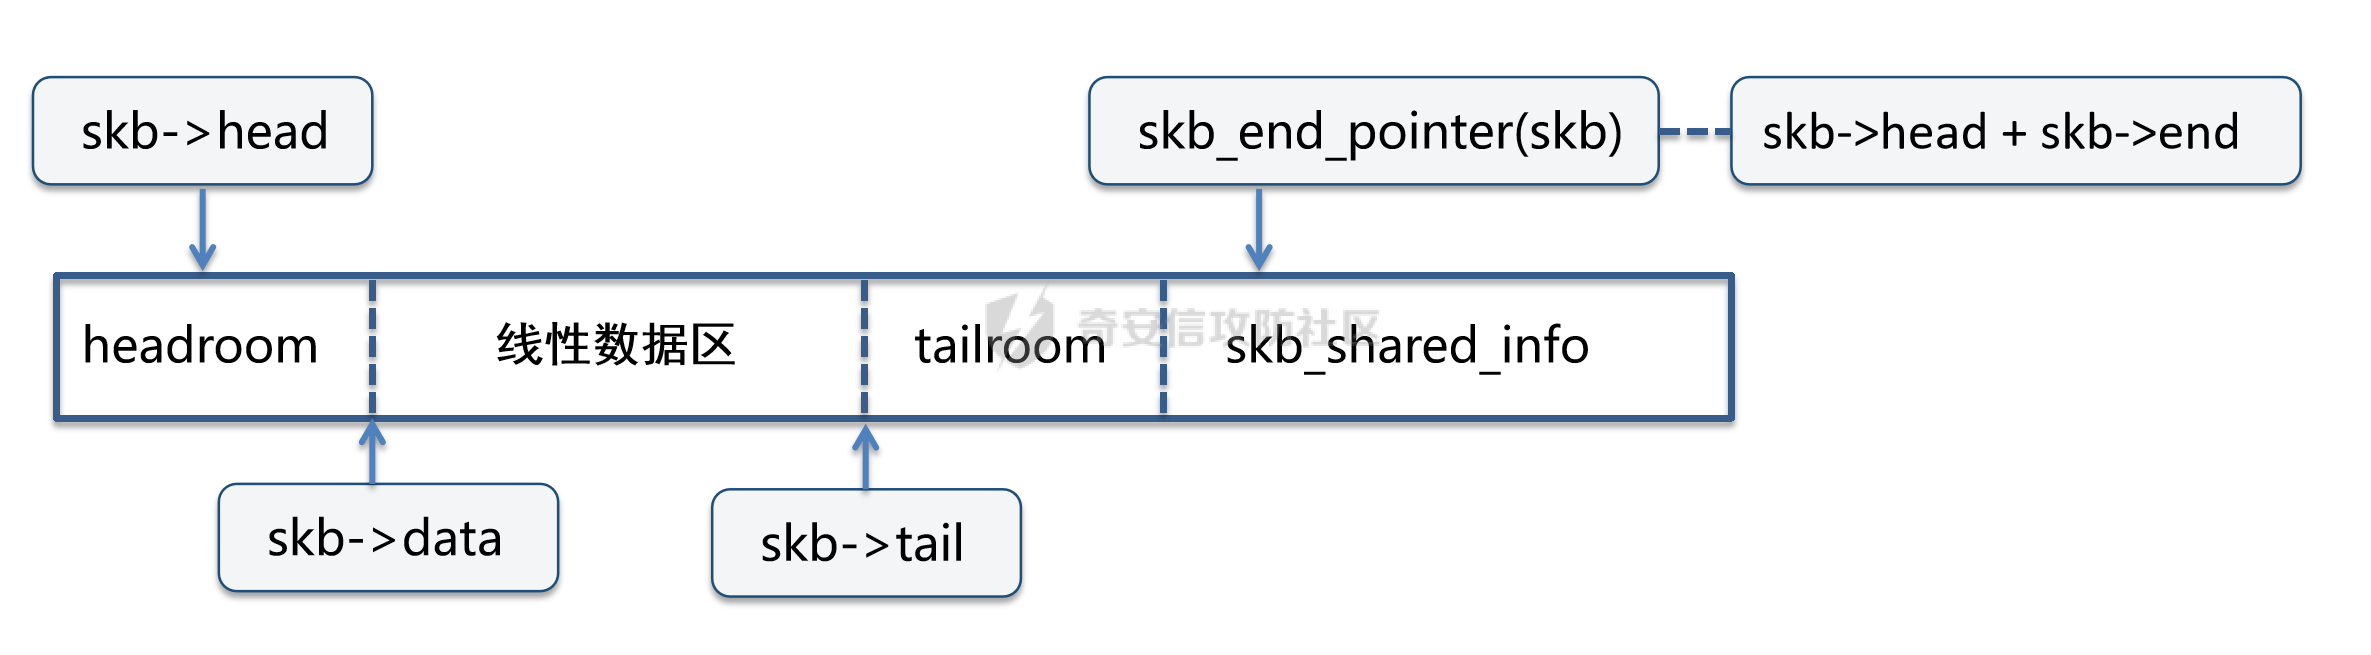 sk\_buff的skb\_shared\_info的管理结构如下: 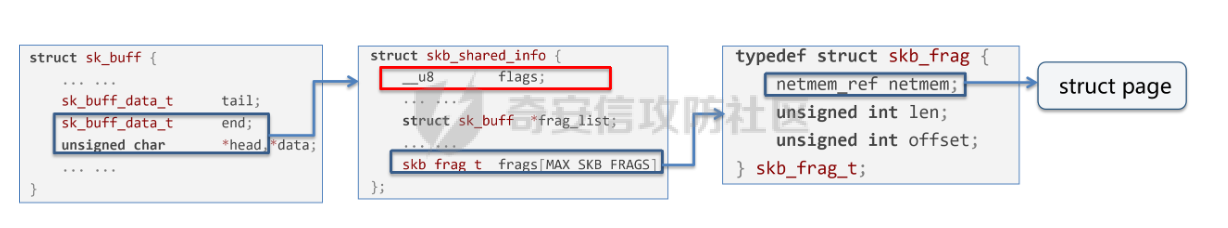 其中frags是一个skb\_frag数组,每一个skb\_frag项的netmem成员相当于一个struct page指针,当线性数据区的空间不够用的时候就会使用skb\_shard\_info中的frags数组中管理的page存放数据,如果这些page还不够用,机会使用skb\_shard\_info的frag\_list成员区链接别的sk\_buff。 ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#sk-buff-head "sk_buff_head")sk\_buff\_head sk\_buff\_head 结构体的定义如下: <https://elixir.bootlin.com/linux/v7.0/source/include/linux/skbuff.h#L337> ```c struct sk_buff_head { /* These two members must be first to match sk_buff. */ struct_group_tagged(sk_buff_list, list, struct sk_buff *next; struct sk_buff *prev; ); __u32 qlen; spinlock_t lock; }; ``` 该结构体使用一个双链表来管理一系列的sk\_buff结构体,通常情况下queue是socket的 sk->sk\_write\_queue,它里面保存着已经构造好的、但暂时还没有发送出去的 struct sk\_buff; skb\_peek\_tail(queue) 表示取出队列最后一个 skb,如果返回 NULL,表示这是该socket第一次创建skb,如果返回一个 skb 则表示该socket之前已经暂存过数据,本次继续追加; 用户使用 MSG\_MORE 标志发送数据的过程大致如下: - 第一次 send / splice 的时候,会创建 skb1 并放入到 sk\_write\_queue 中; - 第二次 send / splice 的时候,从 sk\_write\_queue 中取出 skb1,如果发现 skb1 已经达到分片边界,就会创建skb2,计算 fraggap,将 skb2 放到队列中; - 最后一次发送时,不再设置 MSG\_MORE,发送并清空队列。 ### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#IPv6-%E6%95%B0%E6%8D%AE%E5%8C%85%E5%8F%91%E9%80%81 "IPv6 数据包发送")IPv6 数据包发送 #### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#IPv6-%E6%95%B0%E6%8D%AE%E5%8C%85%E5%8F%91%E9%80%81%E7%9A%84%E8%BF%87%E7%A8%8B "IPv6 数据包发送的过程")IPv6 数据包发送的过程 首先,用户调用 splice(),将 pipe 中的数据发送到 UDPv6 socket。splice\_to\_socket() 将 pipe 页面组织成 bvec,并设置 MSG\_SPLICE\_PAGES 标志,如果后面还有数据,还会设置 MSG\_MORE 标志。 接下来,splice\_to\_socket() 调用 sock\_sendmsg()。udpv6\_sendmsg() 发现 MSG\_MORE 后,不立即发送 UDP 数据报,而是**调用 \_\_ip6\_append\_data() 暂存数据**。第一次进入时,发送队列为空 `skb = skb_peek_tail(queue);` 返回NULL,因此\_\_ip6\_append\_data() 函数创建第一个 skb,并将 pipe 页面挂到 skb\_shinfo(skb)->frags\[\] 上。 后续再次发包时,\_\_ip6\_append\_data() 函数取得队列末尾的 skb (通过 skb = skb\_peek\_tail(queue)),如果还有空间,就继续追加;如果达到分片边界,就创建新的 skb,并加入 sk\_write\_queue。 多次发包后,队列可能变成 sk\_write\_queue:skb1 -> skb2 -> skb3 这个样子,它们共同保存一个尚未发送的 UDP 数据报。 最后一次发送不再设置 MSG\_MORE,内核结束暂存并准备发送。如果总长度超过 MTU,IPv6 层将数据拆成多个 fragment,确保每个网络包不超过 MTU,然后分别发送。接收端重新组装这些 fragments,恢复原始 UDP 数据报。 #### [](http://localhost:4000/2026/08/09/CVE-2026-53362/#IPv6%E6%95%B0%E6%8D%AE%E5%8C%85%E7%9A%84%E5%88%86%E7%89%87 "IPv6数据包的分片")IPv6数据包的分片 IPv6发包是有这样一个规则——**不分片的 IPv6 包没有 Fragment Header**(一开始字节数量比较少按照不分片进行计算,后续如果超载发生了分片,还得从第一个分片的尾部挪走12字节到后边的分片中);分片后的每个 fragment 都要增加 8 字节 Fragment Header,并满足 8 字节对齐。 如下图,当没有发生分片时,一个sk\_buff上的最大数据容量是mtu: 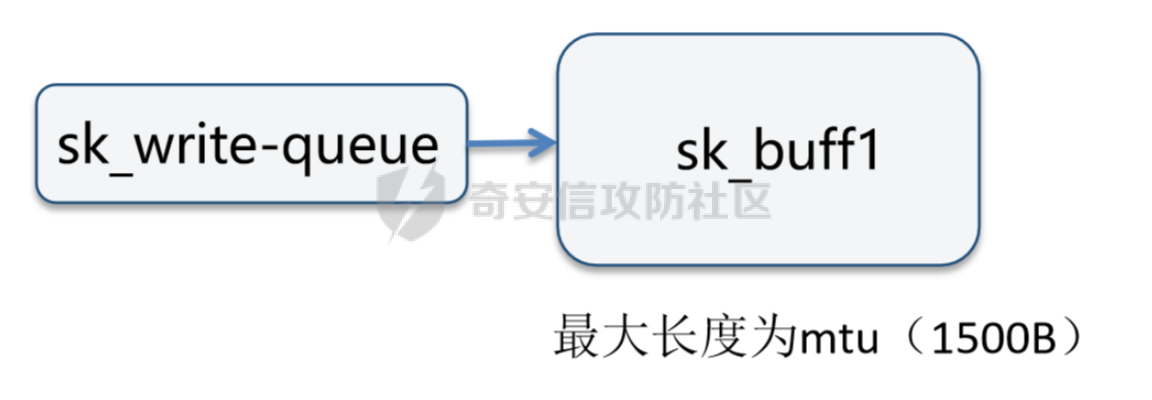 但是当总数据长度超过mtu的时候,每个sk\_buff中的最大数据容量时mtu-Fragment Header,且如果在创建sk\_buff2的时候sk\_buff1中的数据长度超过了Fragment Header的长度,超出部分要挪到sk\_buff2中: 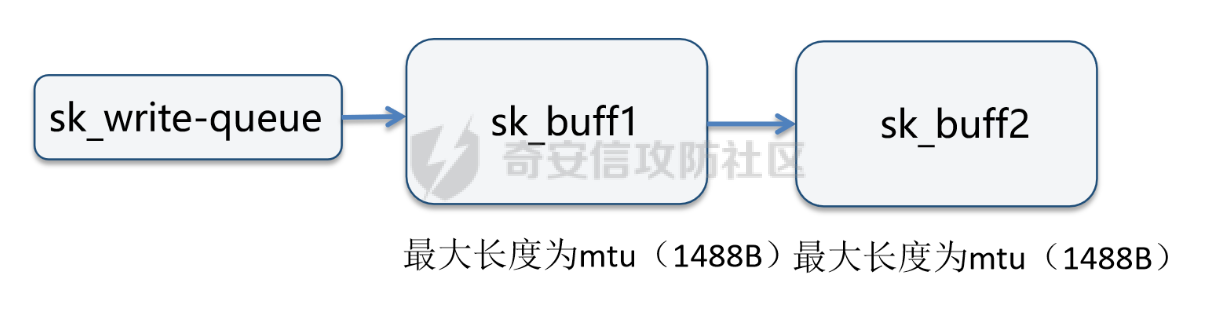 [](http://localhost:4000/2026/08/09/CVE-2026-53362/#%E6%BC%8F%E6%B4%9E%E5%88%86%E6%9E%90 "漏洞分析")漏洞分析 ---------------------------------------------------------------------------------------------------- 该漏洞位于 IPv6 输出模块 linux/net/ipv6/ip6\_output.c:1449 的 \_\_ip6\_append\_data()函数。 该函数负责组织 UDPv6 的待发送数据。多次调用 splice() 并设置 MSG\_MORE 时,内核会将这些数据追加到同一个尚未发送的 UDP数据报中。 该函数把数据存入一个或多个 sk\_buff(当前面)。当数据长度超过 MTU 时,它会按照 IPv6 分片所需的长度边界组织这些 skb,为后续生成并发送 IPv6 fragments 做准备。 漏洞函数如下:[https://elixir.bootlin.com/linux/v7.0/source/net/ipv6/ip6\_output.c#L1418](https://elixir.bootlin.com/linux/v7.0/source/net/ipv6/ip6_output.c#L1418) 函数重点参数的含义是: - queue:socket 的 sk->sk\_write\_queue,它里面保存着已经构造好的、但暂时还没有发送出去的 sk\_buff; - length:本次 splice 系统调用一共要发送的数据的长度; 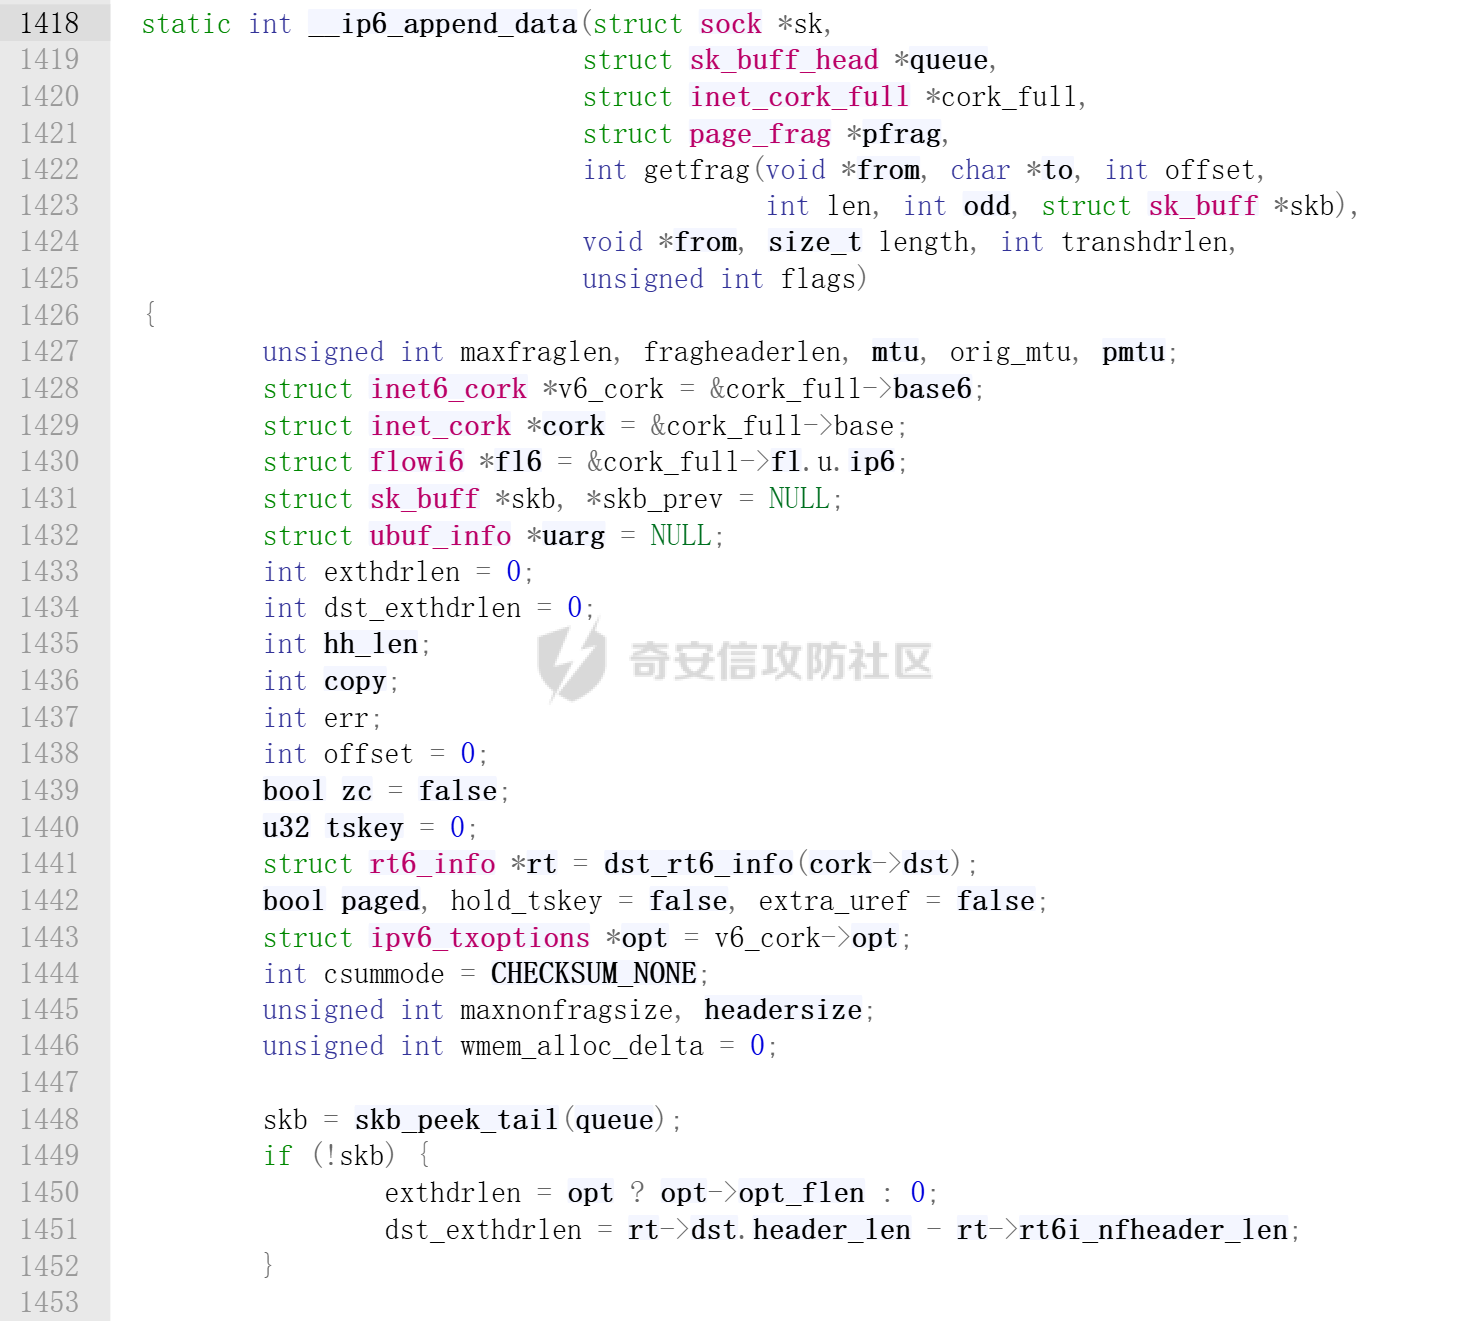 该函数首先会通过 skb\_peek\_tail(skb) 获取当前socket的skb队列中最后一个skb; 之后计算 fragment 的边界,首先计算出 mtu 的值,然后计算出fragheaderlen,最后根据上述两个值计算出 maxfraglen,其中: - mtu 网卡允许的最大包长 - fragheaderlen IPv6 基础头和不可分片扩展头长度 - frag\_hdr IPv6 Fragment Header,通常为 8 字节 - & ~7 将数据长度向下对齐到 8 字节 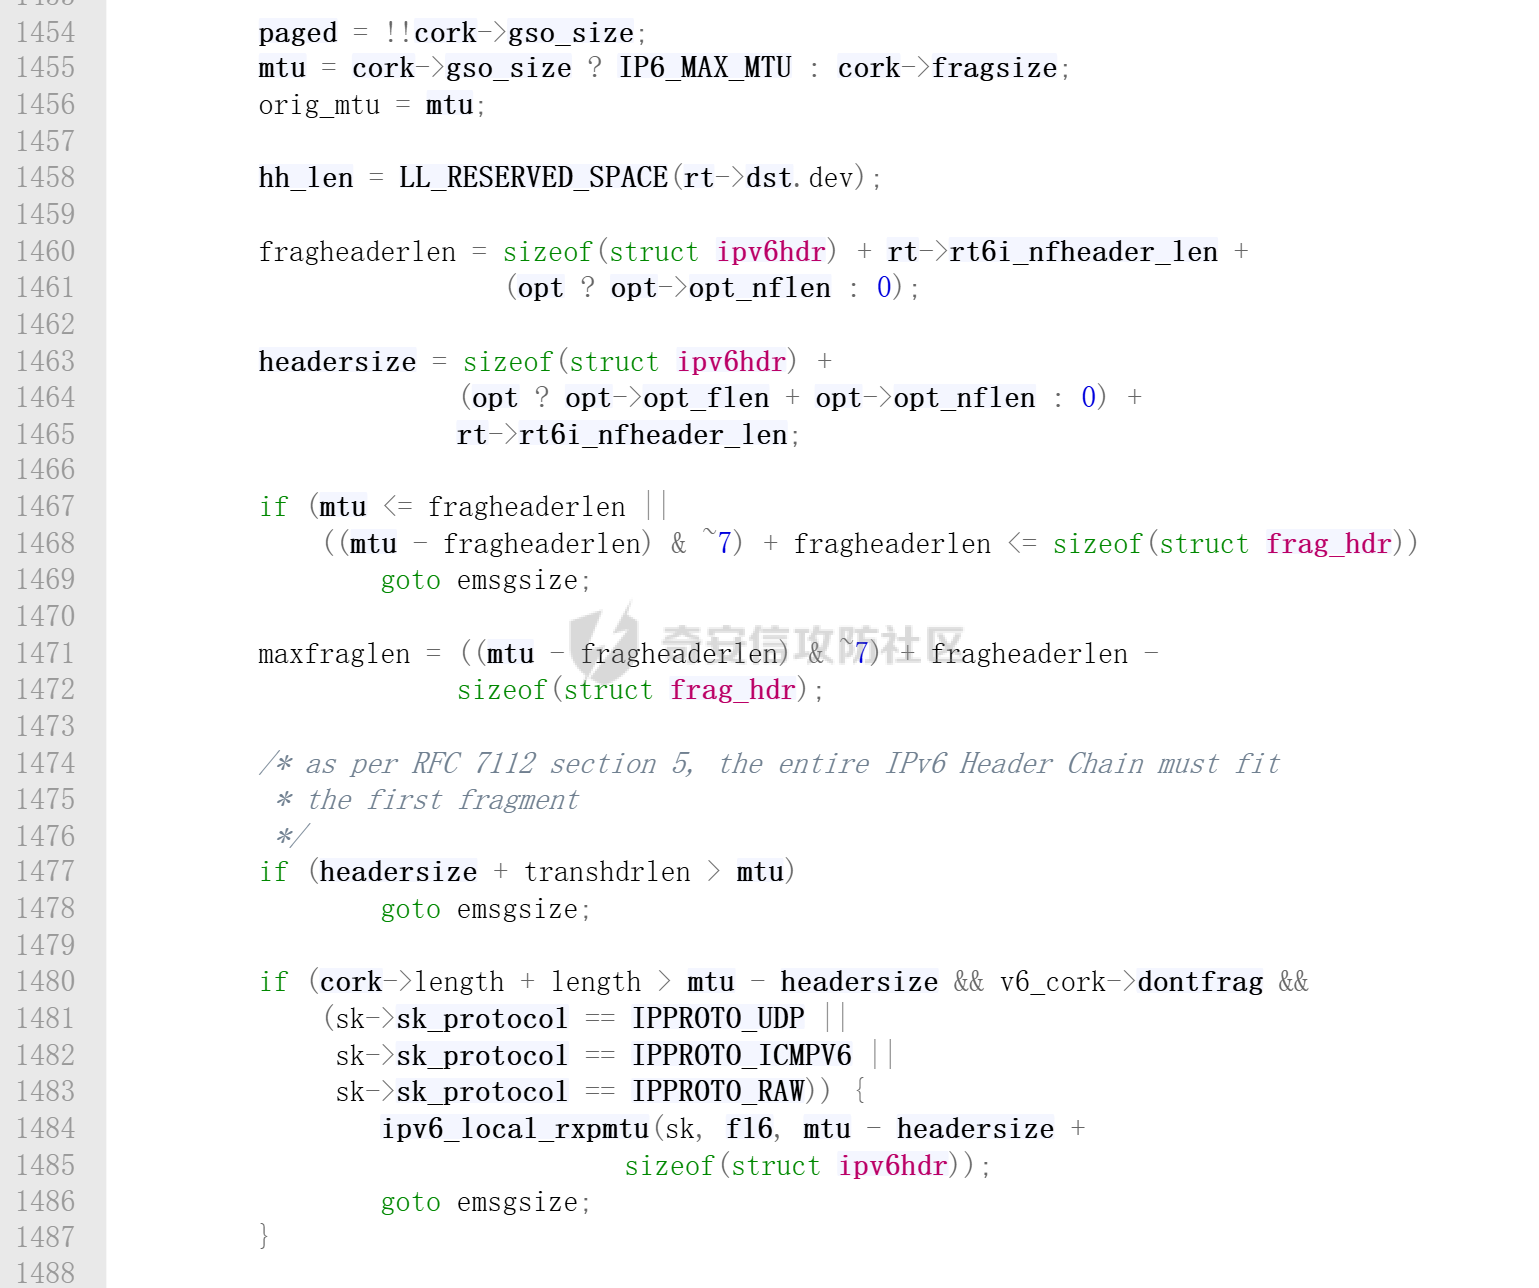 如果是第一次发送,则直接 goto alloc\_new\_skb,分配一个skb: 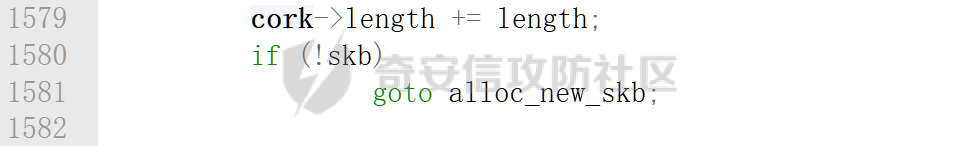 之后会通过一个 while 循环不断暂存数据,length在这个循环中不断变小,直到 lenth == 0 循环结束;每轮先计算当**前 skb 还能放多少copy**,IPv6发包是有这样一个规则——**不分片的 IPv6 包没有 Fragment Header**(一开始字节数量比较少按照不分片进行计算,后续如果超载发生了分片,还得从第一个分片的尾部挪走12字节到后边的分片中);分片后的每个 fragment 都要增加 8 字节 Fragment Header,并满足 8 字节对齐,所以如果当前累计数据长度没有超过mtu、即没有分片,则一个fragment的上限是mtu - skb->len,否则就是maxfraglen - skb->len。 如果 copy 小于 length 说明,现在这个IPv6分片中的剩余空间已经装不下这个这次的消息了,copy被设置成 maxfraglen - skb->len,表示当前这个skb中还能装多少字节(🤔这里思考一个场景,如果这是第一个分片,之前累计发送刚好让skb->len == mtu == 1500,那么此时 copy = maxfraglen - skb->len == -12): 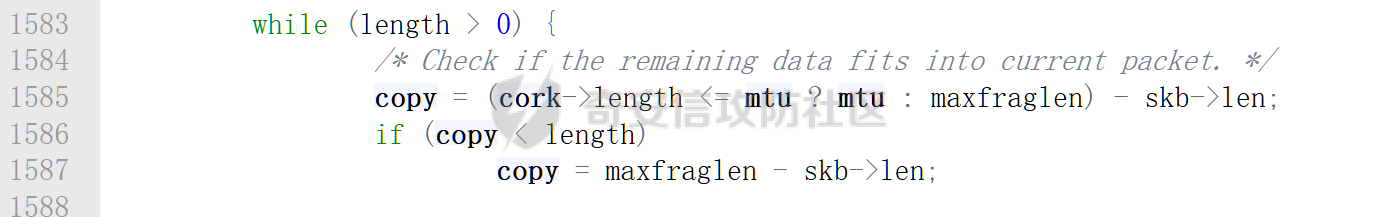 接下来,如果 copy <= 0,也就是说当前skb已经完全没有空间存放新的数据,则进入到如下分支准备分配新的skb后续在发包时进入一个新的IPv6分片,首先计算fraggap,\*\*fraggap的含义是 前一个刚满的 skb 超过maxfraglen的长度\*\*,如果 skb 不为 NULL 则表示 queue 中已有skb,则 fraggap = skb->len - maxfraglen(🤔也就是前面我们所说的第一个分片多出来的12个字节需要挪到后边的分片中),否则说明当前分配的skb是第一个skb,所以 fraggap = 0: 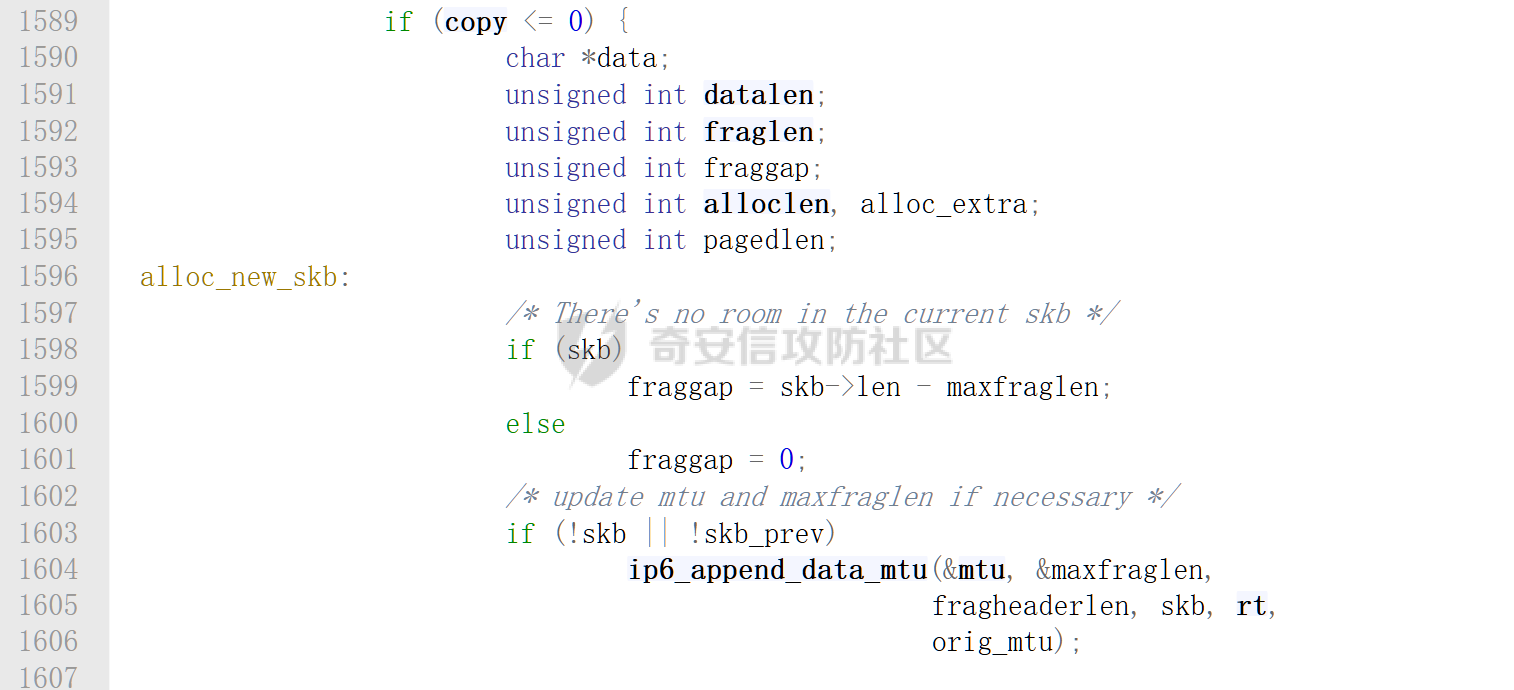 接下来首先保存旧 skb,后面需要从它的尾部复制 fraggap; 然后计算 datalen = length + fraggap,表示新分片中要复制的总数据的长度,包括上个分片中需要挪过来的部分,加本次发包要暂存的数据; 默认所有数据都放在线性区,所以 pagedlen = 0; 接着计算额外预留空间: alloc\_extra = hh\_len; 表示 链路层头部 ; alloc\_extra += dst\_exthdrlen; 路由/IPsec 扩展头 alloc\_extra += rt->dst.trailer\_len; 尾部数据 alloc\_extra += sizeof(struct frag\_hdr); Fragment Header 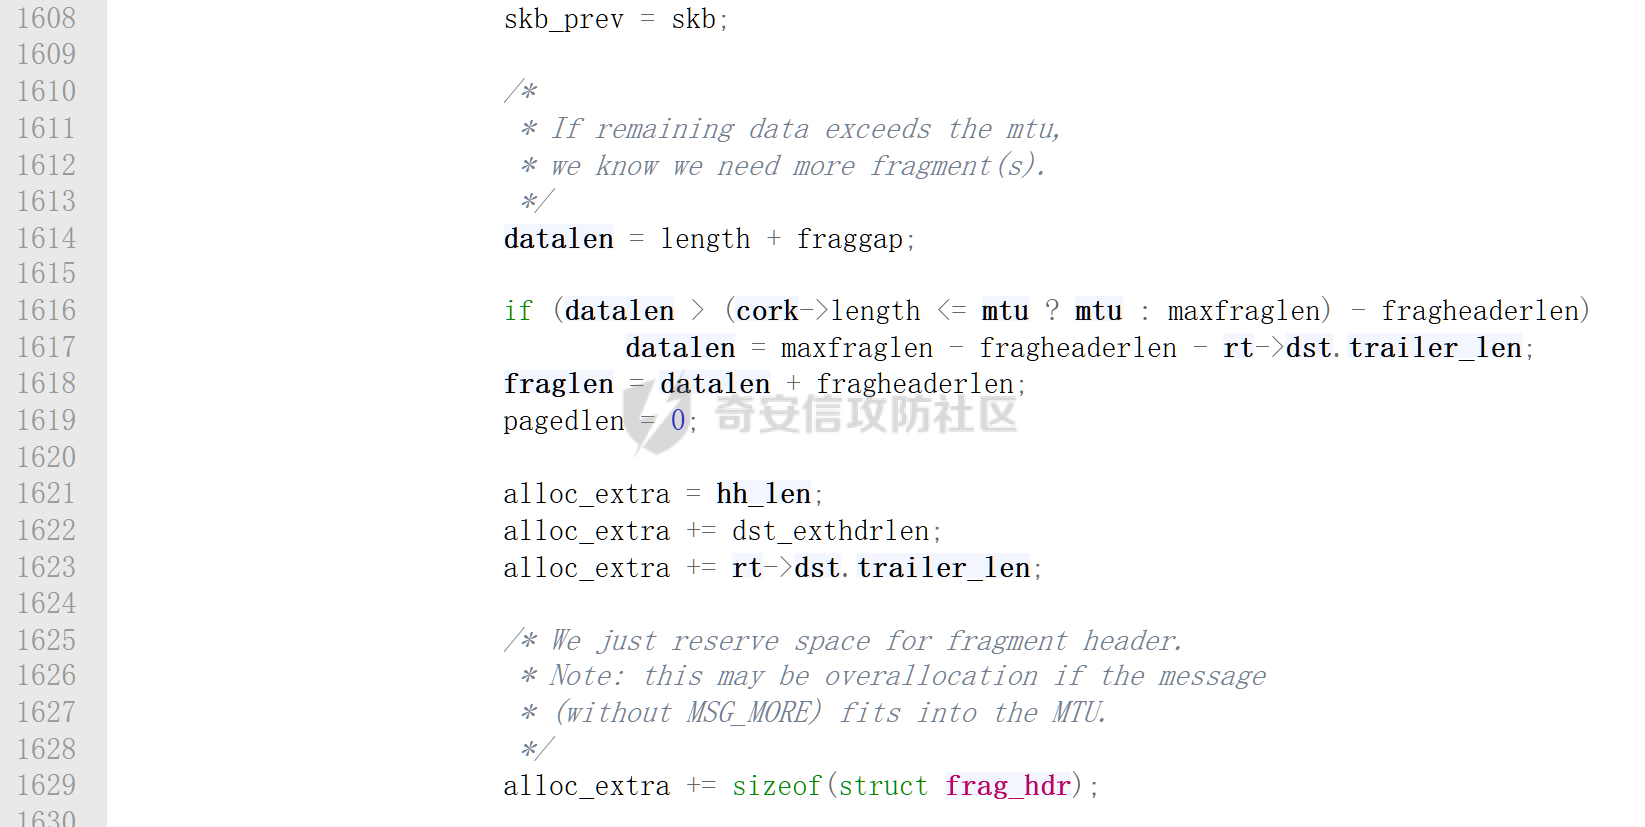 如下图所示红色框中的代码就是漏洞发生的位置,在这里: - alloclen 表示新skb需要分配的线性缓冲区大小,sk\_buff的线性数据区中不仅包括数据,还包括了fragheader、transhdr; - pagedlen 表示当前 fragment 中存放在 page fragments 的数据长度,这些数据由skb\_shinfo(skb)->frags\[\]引用; - transhdrlen 表示传输层头部长度,例如 UDP 头长度为 8 字节; - datalen = transhdrlen + fraggap + pagedlen + copy 但是 fraggap 也就是需要挪动的部分的长度并没有被计算在alloclen中(L1639~L1640): 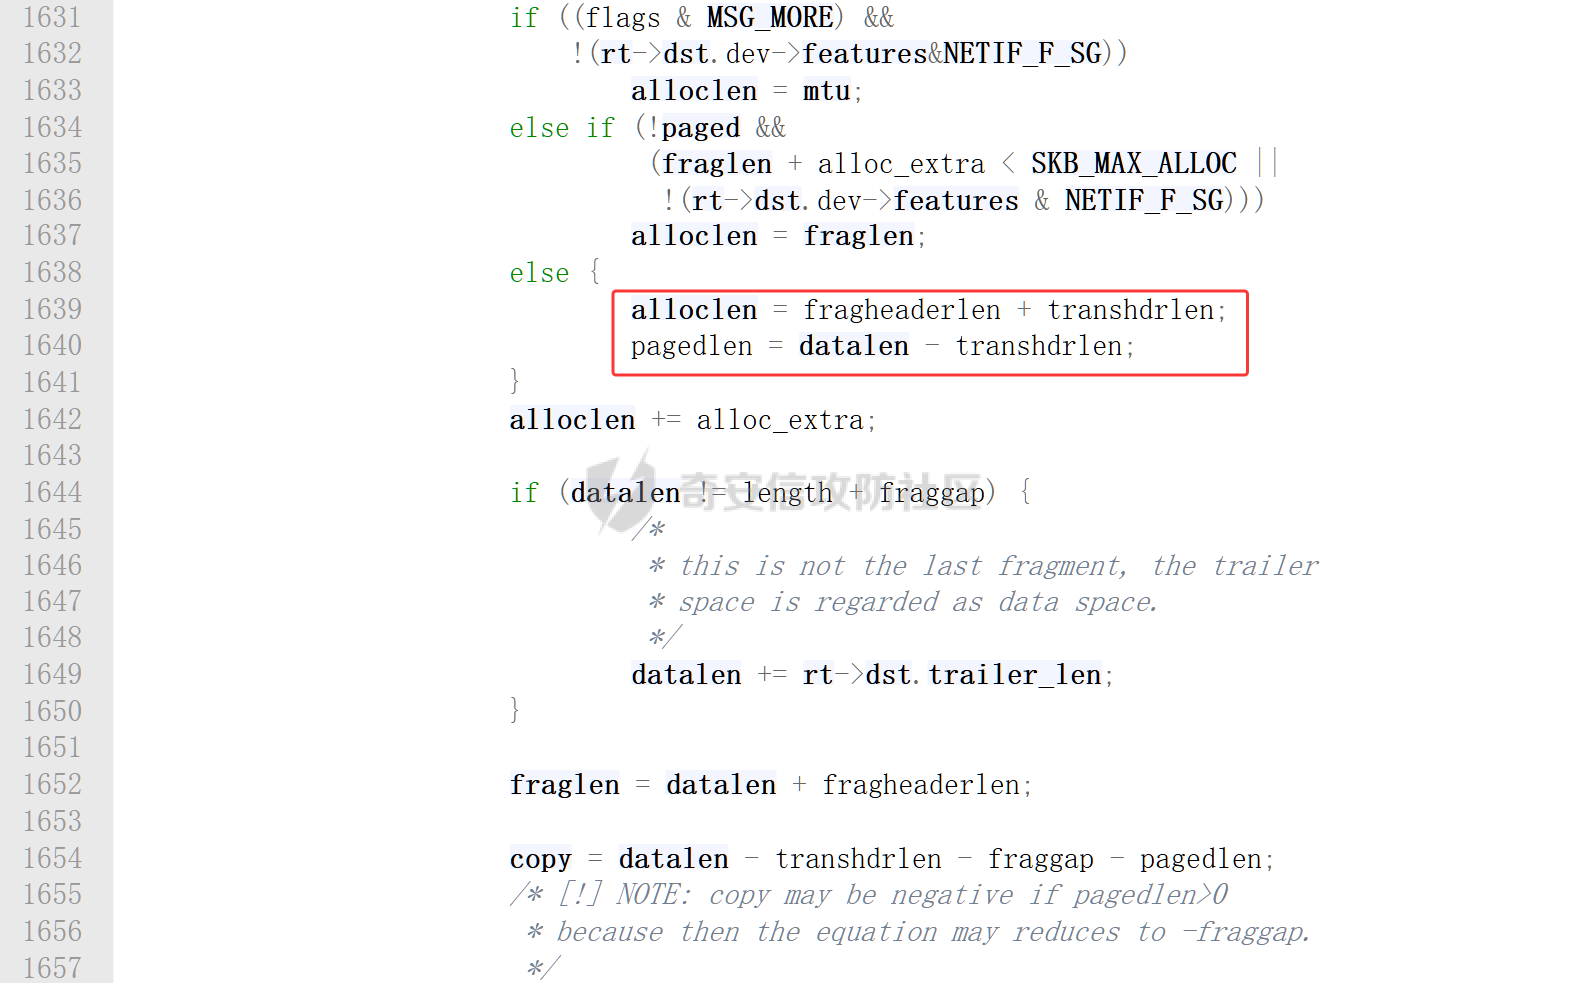 导致后续分配sk\_buff的长度过小: 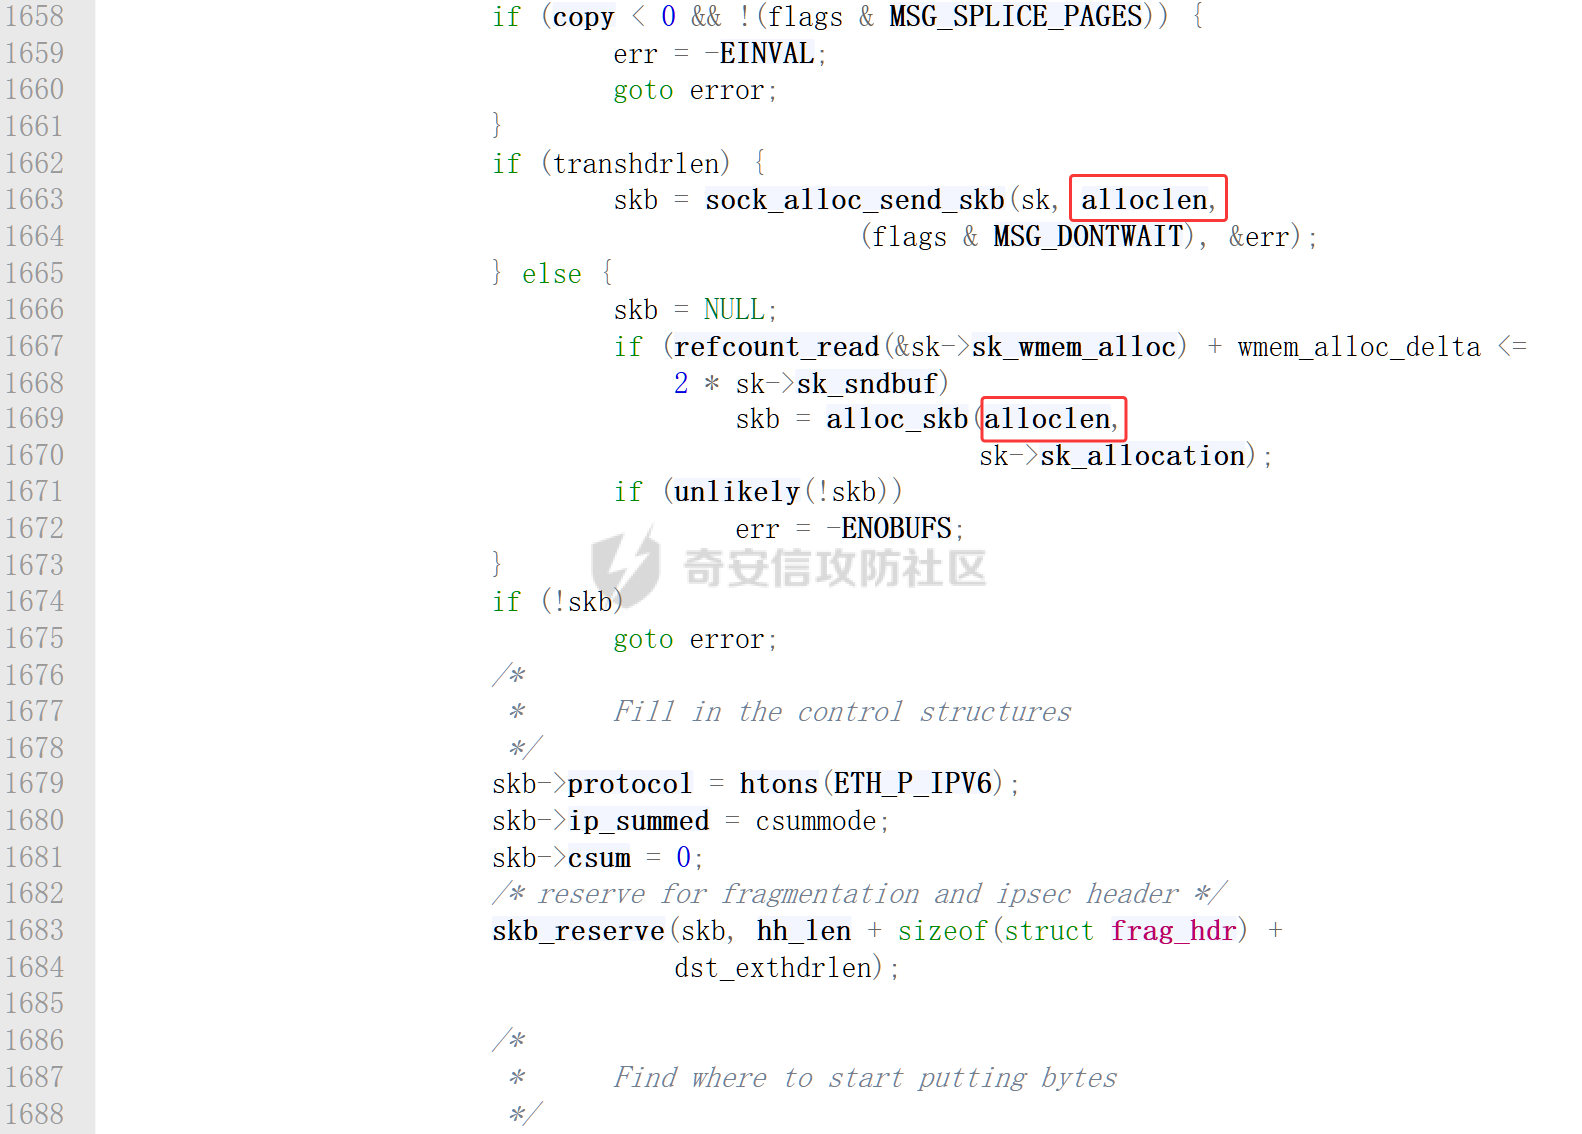 后续如果由fraggap调用skb\_copy\_and\_csum\_bits函数将旧 skb 的尾部数据写入线性区: 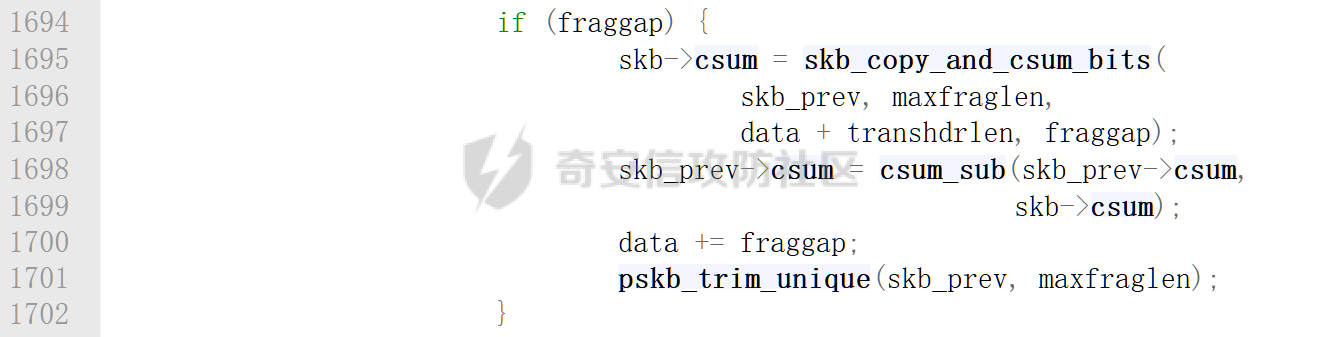 之后通过getfrag将新数据页拷贝到新sk\_buff上: 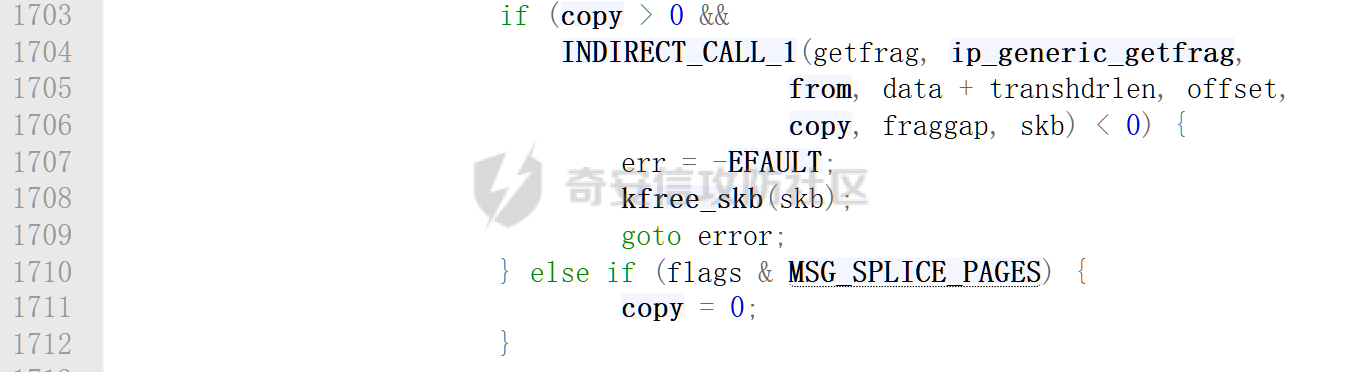 因此这个漏洞会导致sk\_buff线性数据区向下溢出,虽然字节数非常少,但是却足够篡改 skb\_shared\_info 的开头部分。 [](http://localhost:4000/2026/08/09/CVE-2026-53362/#%E8%A1%A5%E4%B8%81%E5%88%86%E6%9E%90 "补丁分析")补丁分析 ---------------------------------------------------------------------------------------------------- 漏洞的补丁如下,可以看到错误的长度计算被修复: <https://git.kernel.org/pub/scm/linux/kernel/git/torvalds/linux.git/commit/?id=736b380e28d0480c7bc3e022f1950f31fe53a7c5> 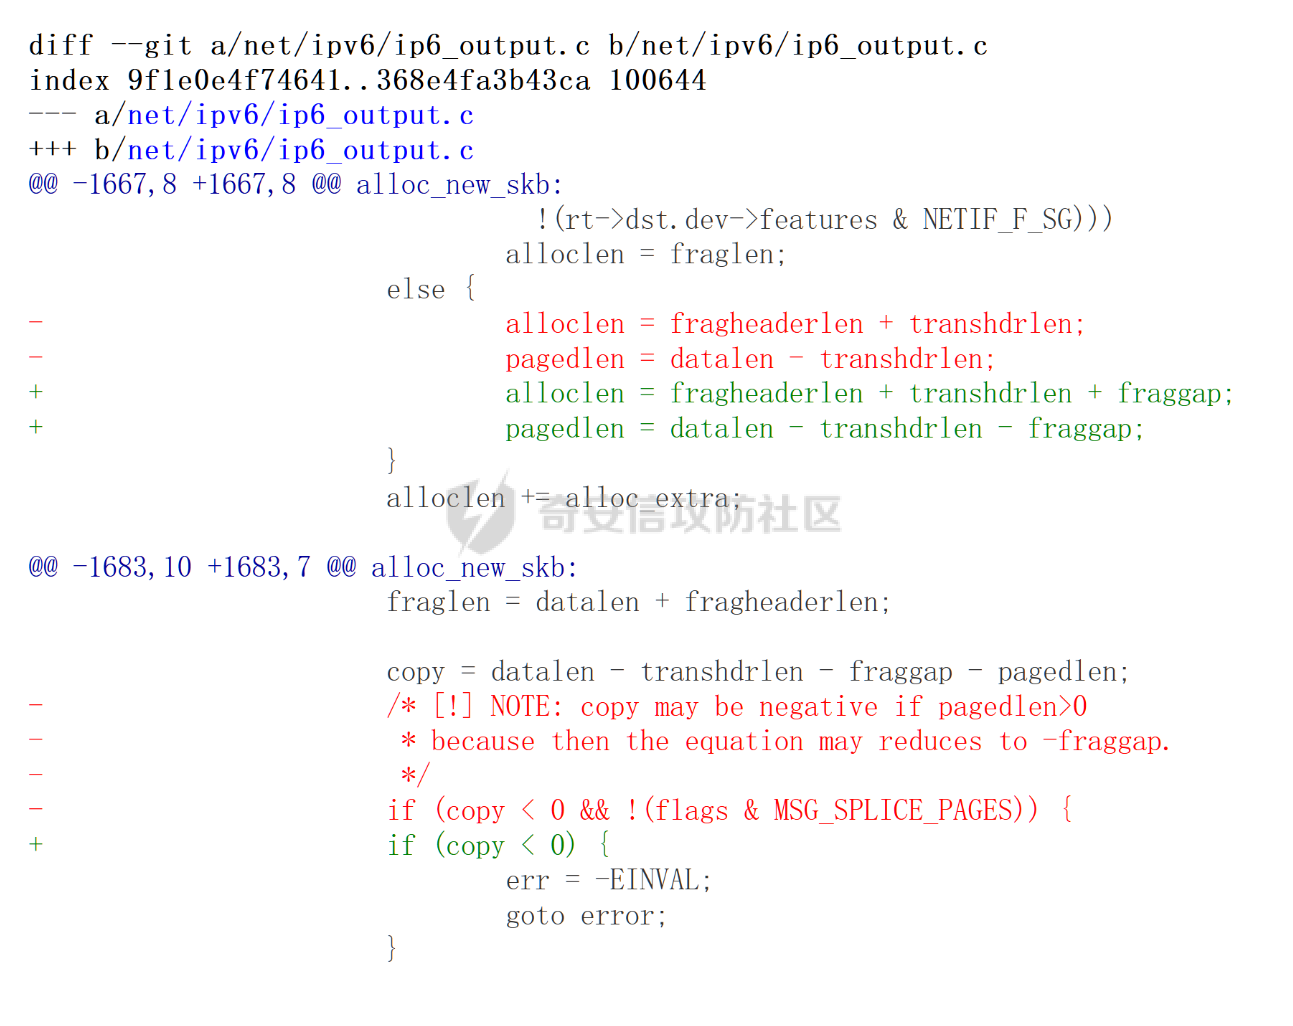 [](http://localhost:4000/2026/08/09/CVE-2026-53362/#%E5%8F%82%E8%80%83 "参考")参考 ------------------------------------------------------------------------------ <https://zhuanlan.zhihu.com/p/551833981> <https://zhuanlan.zhihu.com/p/544639332> <https://zhuanlan.zhihu.com/p/573893175> [https://elixir.bootlin.com/linux/v7.0/source/include/linux/pipe\_fs\_i.h#L26](https://elixir.bootlin.com/linux/v7.0/source/include/linux/pipe_fs_i.h#L26)
发表于 2026-09-08 09:00:02
阅读 ( 4891 )
分类:
漏洞分析
0 推荐
收藏
0 条评论
q1ming
2 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!
