「JavaWeb审计盲点」FormContentFilter 与 Charset 走私
漏洞分析
本文主要分析了 Servlet 规范仅覆盖 POST 的表单解析、与 Spring FormContentFilter 对 PUT/PATCH/DELETE body 按声明 charset 独立解析这两类机制的差异,结合统一鉴权 filter 手动解析 body 的典型场景,展示了其中可能存在的 charset 走私越权风险。
一般情况下,很多业务场景虽然接口繁多,但是基本上操作的资源ID其实比较有限,如果归属校验写在每个 service 方法里,例如保证"非管理员角色只能操作自己的订单",会有很多“不方便”的地方: - 一是会引入重复的代码,每个方法开头都是同一段 `owns` 校验。 - 其次是新成员加入、新接口上线时,没人能保证每次都记得调用同样的办法。遗漏就会导致越权问题的发生。 所以很多时候研发都会选择通过建设统一的鉴权网关,把资源 ID 的归属校验收敛到一个统一组件, 让新接口"默认被保护"、不再依赖每个研发的自觉。 下面是最近审计的一个例子: orderId是该应用里比较关键的资源,除了管理员以外,在调用相关的接口时需要保证当前用户仅仅只能操作自己所属orderId的内容。 本着"**鉴权当然要在最外层、越早越好**"的思路,在设计时相关研发选择了使用过滤器 filter 来实现,并注册得尽量靠前。 首先能想到的就是使用`getParameter`来获取参数,然后进行相关的校验。 `HttpServletRequest#getParameter()` 的数据来自两处: - URL 上的查询参数 (query string) - 请求体 body 里`application/x‑www‑form‑urlencoded`表单:仅 POST 会被容器自动解析并入 parameterMap。而类似PUT/PATCH 即便是是 urlencoded 表单,body 内容不会自动合并进 parameterMap,只能手动读 inputStream 解析。 但是应用接口按 RESTful 规范设计,类似部分更新接口会使用用 PUT进行请求+urlencoded 表单,`getParameter`获取不到对应的参数。 为了解决这个问题,研发通过缓存 body + 包装 request的方式进行了对应参数的解析。 相关filter的关键代码如下: 首先通过jwt区分用户角色,如果是管理员则无需校验,否则获取orderId参数进行鉴权检查,这里主要涉及两种方式,一种是传统的getParameter,另外一种是通过`request.getInputStream`捕获,然后调用parseFormBody方法进行自解析*:* ```Java @Component @Order(Ordered.HIGHEST_PRECEDENCE) public class OrderAuthFilter extends OncePerRequestFilter{ @Override protected void doFilterInternal(HttpServletRequest request, HttpServletResponse response, FilterChain chain) throws ServletException, IOException { // JWT 认证:未携带/非法 token 一律 401 JwtSupport.JwtUser jwt = JwtSupport.authenticate(request); if (jwt == null) { response.sendError(HttpServletResponse.SC_UNAUTHORIZED, "missing or invalid token"); return; } if (jwt.admin()) { chain.doFilter(request, response); return; } String user = jwt.username(); String orderId = request.getParameter("orderId"); if (orderId == null) { byte[] body = StreamUtils.copyToByteArray(request.getInputStream()); Map<String, String[]> formParams = parseFormBody(body); String[] ids = formParams.get("orderId"); if (ids != null && ids.length > 0) { orderId = ids[0]; } // 把 body 还回去,让 FormContentFilter 还能解析 request = new CachedBodyRequestWrapper(request, body); } if (orderId != null) { long id; try { id = Long.parseLong(orderId.trim()); } catch (NumberFormatException e) { response.sendError(HttpServletResponse.SC_BAD_REQUEST, "orderId 格式非法"); return; } if (!orderService.owns(user, id)) { response.sendError(HttpServletResponse.SC_FORBIDDEN, "订单 " + id + " 不属于用户 " + user); return; } } chain.doFilter(request, response); } } ``` parseFormBody具体实现如下,模仿了Servlet 容器对 POST 表单 body 的解析逻辑,具备完整的 form-urlencoded 解析能力,通过 &/= 分词、对 key 和 value 做URL码、同名参数多值合并 ,最终输出与框架一致的 parameterMap: ```TypeScript private static Map<String, String[]> parseFormBody(byte[] bodyBytes) { Map<String, String[]> parameterMap = new LinkedHashMap<>(); String bodyStr = new String(bodyBytes, StandardCharsets.UTF_8); if (!StringUtils.hasText(bodyStr)) { return parameterMap; } // 分割 a=1&b=2 String[] pairs = bodyStr.split("&"); for (String pair : pairs) { if (!StringUtils.hasText(pair)) { continue; } String[] kv = pair.split("=", 2); if (kv.length < 2) { continue; } // URL 解码 String key = URLDecoder.decode(kv[0], StandardCharsets.UTF_8); String value = URLDecoder.decode(kv[1], StandardCharsets.UTF_8); // 合并参数,支持多值 parameterMap.compute(key, (k, oldArr) -> { if (oldArr == null) { return new String[]{value}; } String[] newArr = Arrays.copyOf(oldArr, oldArr.length + 1); newArr[oldArr.length] = value; return newArr; }); } return parameterMap; } ``` 受保护的update接口: ```TypeScript @PutMapping("/update") public Map<String, Object> update(@RequestParam long orderId, @RequestParam(required = false) String item, @RequestParam(required = false) Long amount) { boolean ok = orderService.update(orderId, item, amount); Map<String, Object> result = new LinkedHashMap<>(); result.put("success", ok); result.put("updatedOrderId", orderId); return result; } ``` 基于上述的设计,正常情况下当前用户修改自己的order信息成功: 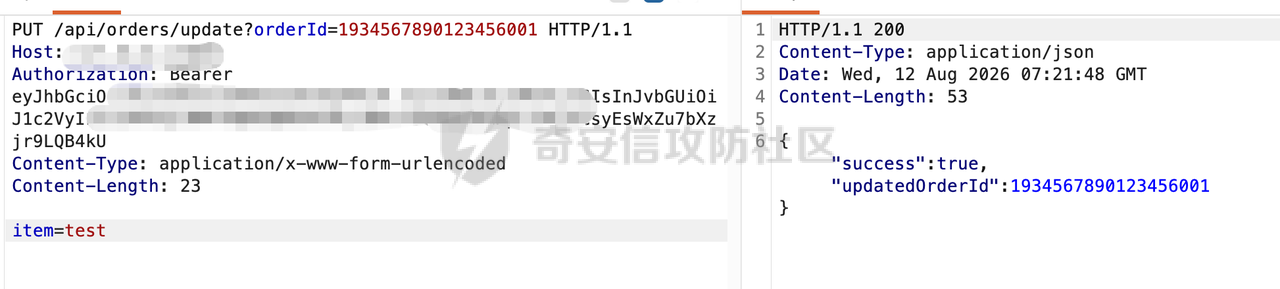 尝试修改他人的订单,系统返回403 status: 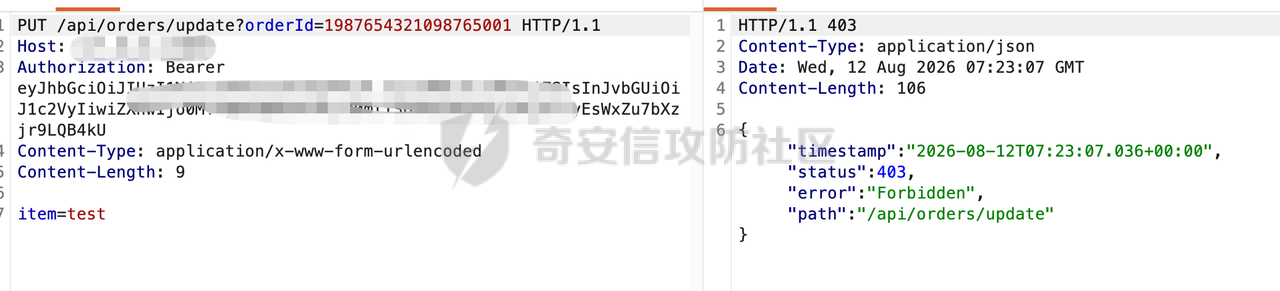 从相关HTTP请求的stauts可以看到,确实没办法越权更新他人的订单,但是相关的接口真的安全了么? 0x01 Charset Smuggling ====================== 有经验的师傅可能第一时间会想到通过类似orderid=&orderid=的方法达到HPP走私的效果,但是这种方法前提是`两侧取值口径不一致`(一侧取首值、另一侧取尾值或全值)。而这个案例里 filter 和业务接口**都是首值语义**,口径恰好一致,这个思路明显没办法达到绕过鉴权的效果。 1.1 绕过方式 -------- 基于前面Filter的设计,在getParameter无法突破的情况下,可以把思路转移到parseFormBody方法里,需要通过类似PUT进行请求+urlencoded 表单的形式才会调用这里的逻辑,类似下面的请求: 正常更新自己的订单1934567890123456001,更新成功: 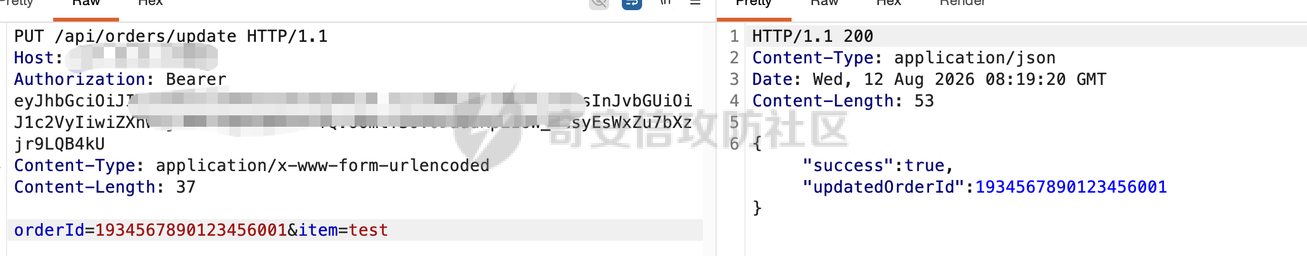 尝试更新他人订单1987654321098765002,返回403 status: 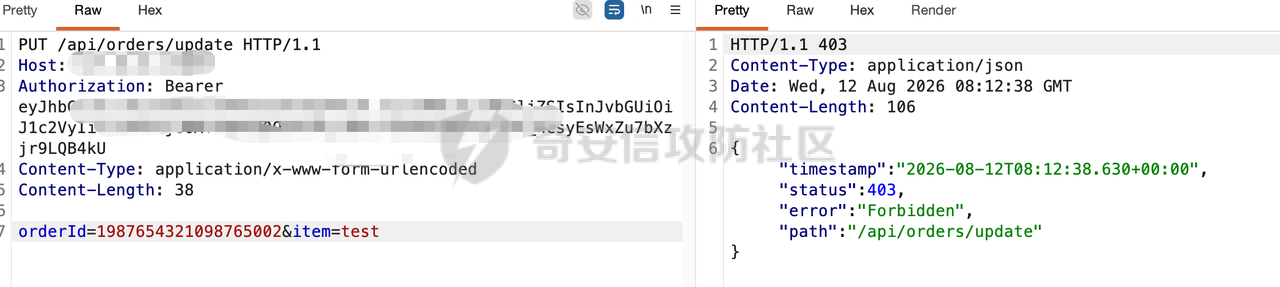 可以看到,即使是parseFormBody的逻辑,貌似也没有办法达到越权利用的效果。 至于为什么这种情况下`getParameter`获取不到但是后端仍可以正常获取到orderId并正常解析,在1.2节再详细剖析。 下面先说绕过的方式: 通过`utf-16le`对请求的body(orderId=1987654321098765002&item=pwned)进行编码,即可成功绕过(注意Content-type里通过charset指定了对应的编码类型): 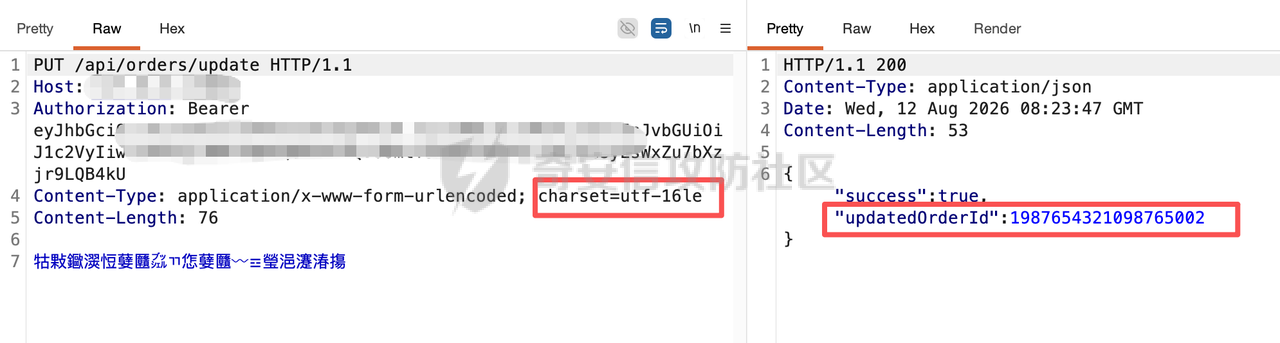 1.2 相关原理 -------- ### 1.2.1 FormContentFilter 首先回答一个问题,为什么`PUT+urlencoded 表单请求`的情况下`getParameter`获取不到参数,但是后端仍可以正常获取到orderId并正常解析,这里主要是 FormContentFilter起到了作用。 首先是getParameter的解析逻辑,通过见https://jakarta.ee/specifications/servlet/6.0/jakarta-servlet-spec-6.0.html的3.1.1 节可以看到: Servlet 规范(3.1.1.1 "When Parameters Are Available")只要求容器在 **POST +** **`application/x-www-form-urlencoded`** 的情况下,才会把 form body 解析成 request parameters。原因也很简单,因为HTML 表单只支持 GET 和 POST,规范是围绕浏览器表单提交写的: 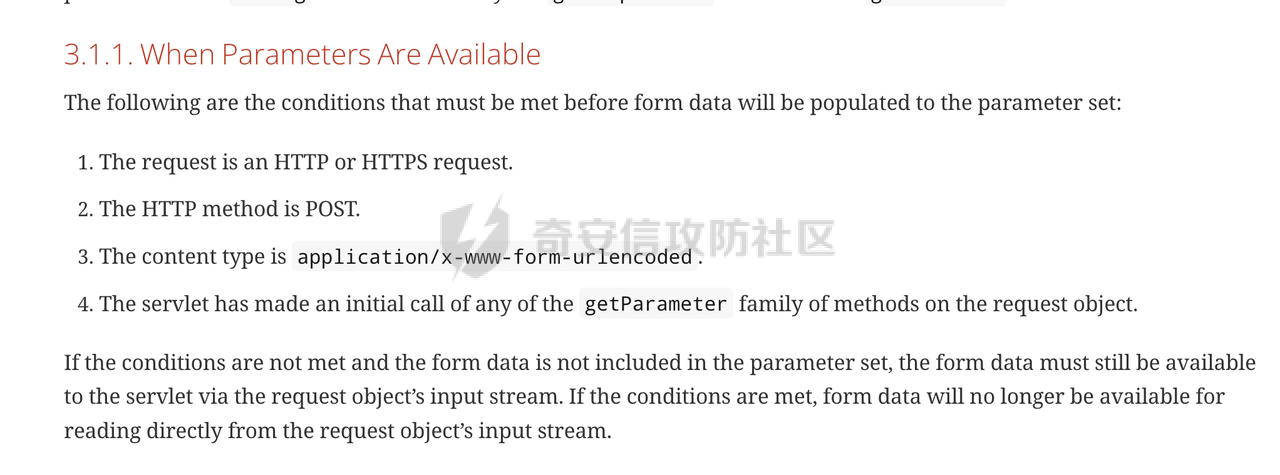 对于类似PUT/PATCH/DELETE 携带 form body 是 REST API 时代的习惯,并没有在规范中体现,类似Tomcat之类的容器按规范严格实现: <https://github.com/apache/tomcat/blob/10.1.26/java/org/apache/catalina/connector/Connector.java#L230> 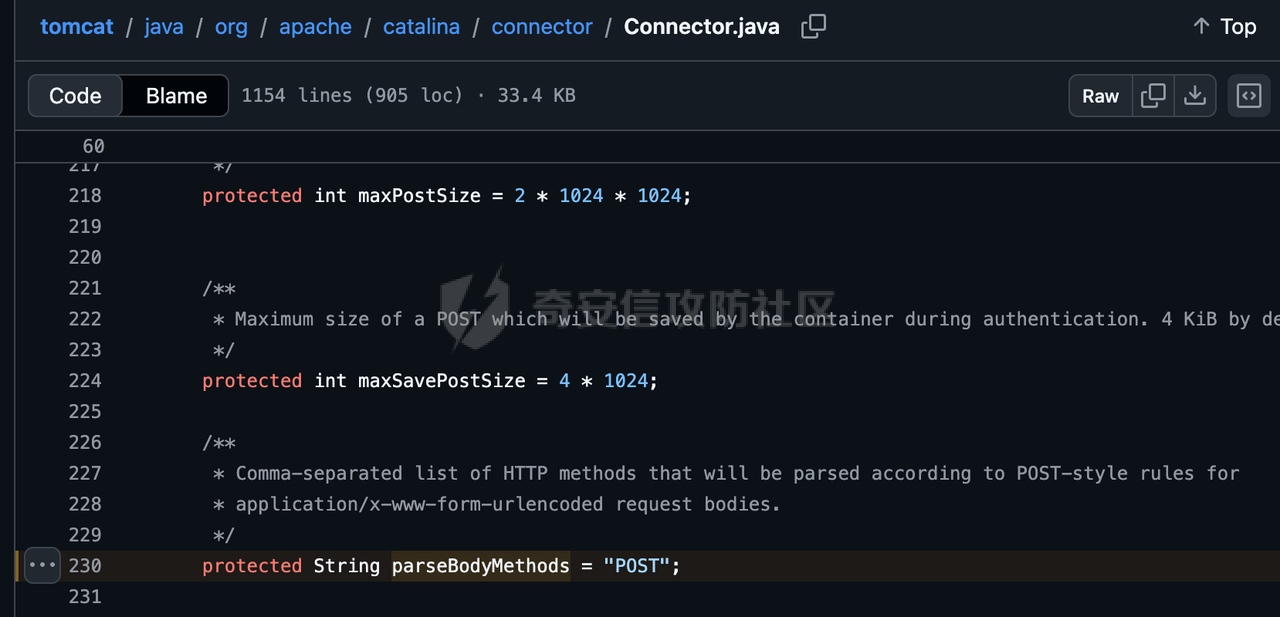 <https://github.com/apache/tomcat/blob/10.1.26/java/org/apache/catalina/connector/Request.java#L2916> 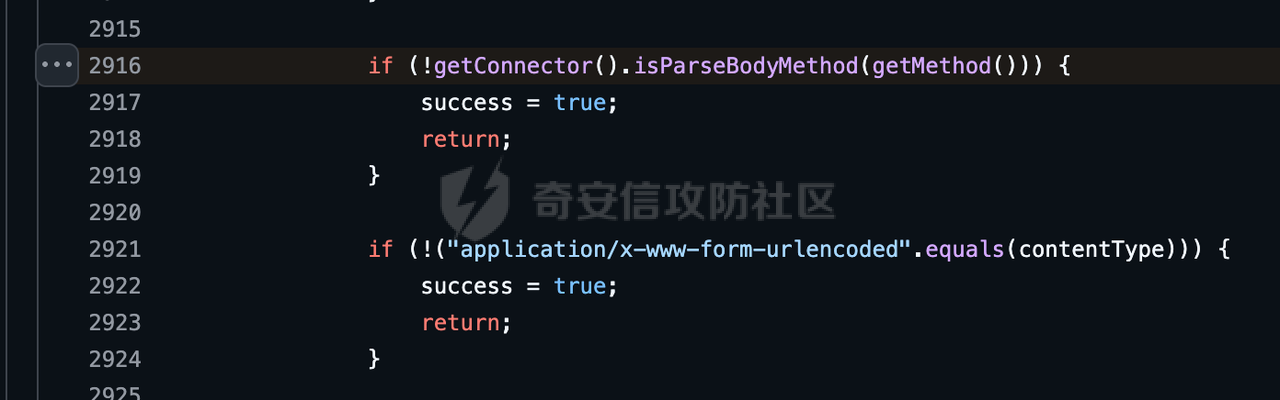 为了解决这个问题,Spring 通过FormContentFilter“打了一个补丁”,把 PUT/PATCH/DELETE 的 form body 也解析进 parameter map。并且FormContentFilter默认情况下是开启的: <https://github.com/spring-projects/spring-boot/blob/v3.4.1/spring-boot-project/spring-boot-autoconfigure/src/main/java/org/springframework/boot/autoconfigure/web/servlet/WebMvcAutoConfiguration.java#L173> 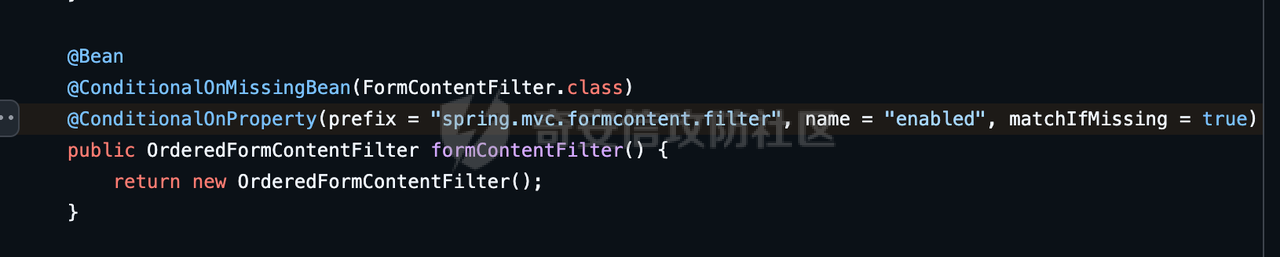 这就解释了前面的那个疑问。 当然也可以通过下面的配置将其关闭,这里篇幅有限,就不展开了: ```Bash spring.mvc.formcontent.filter.enabled=false ``` 下面简单看一下org.springframework.web.filter.FormContentFilter的具体实现: 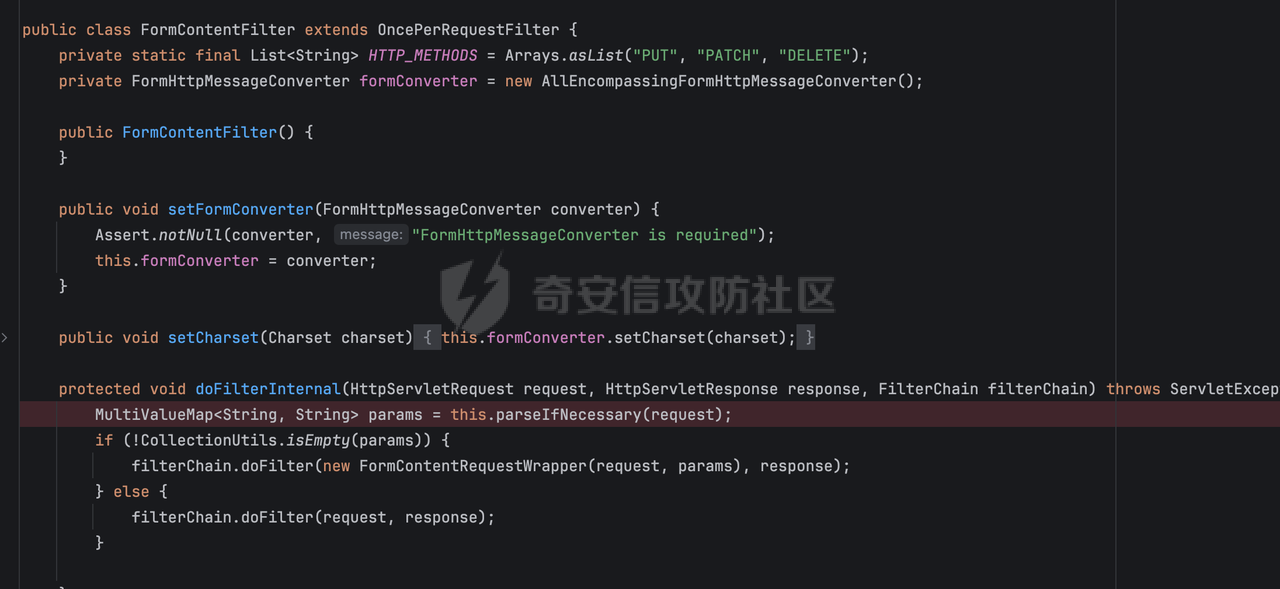 首先在parseIfNecessary(request)方法中会先判断是否需要解析: 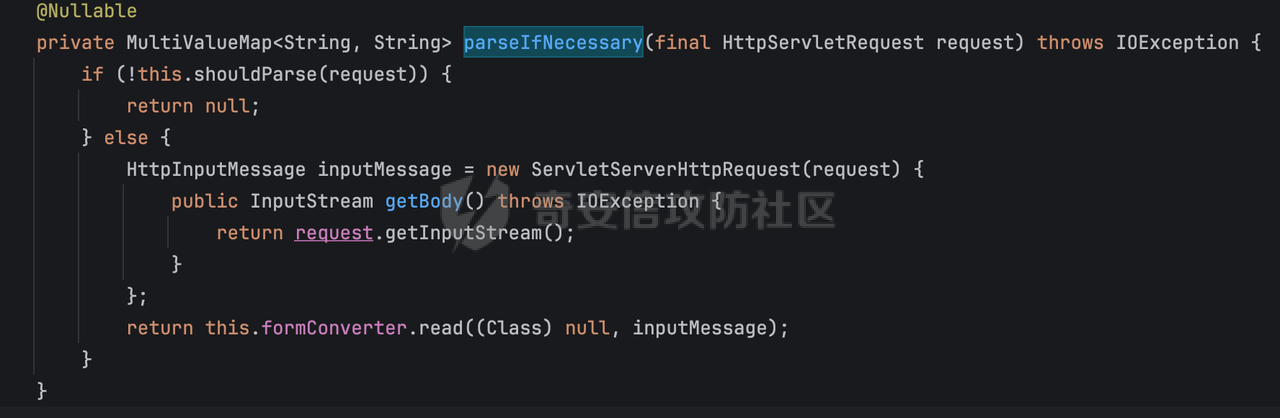 请求方法必须是 PUT/PATCH/PATCH/DELETE 白名单之一,且 Content-Type 是 application/x-www-form-urlencoded,否则直接返回:   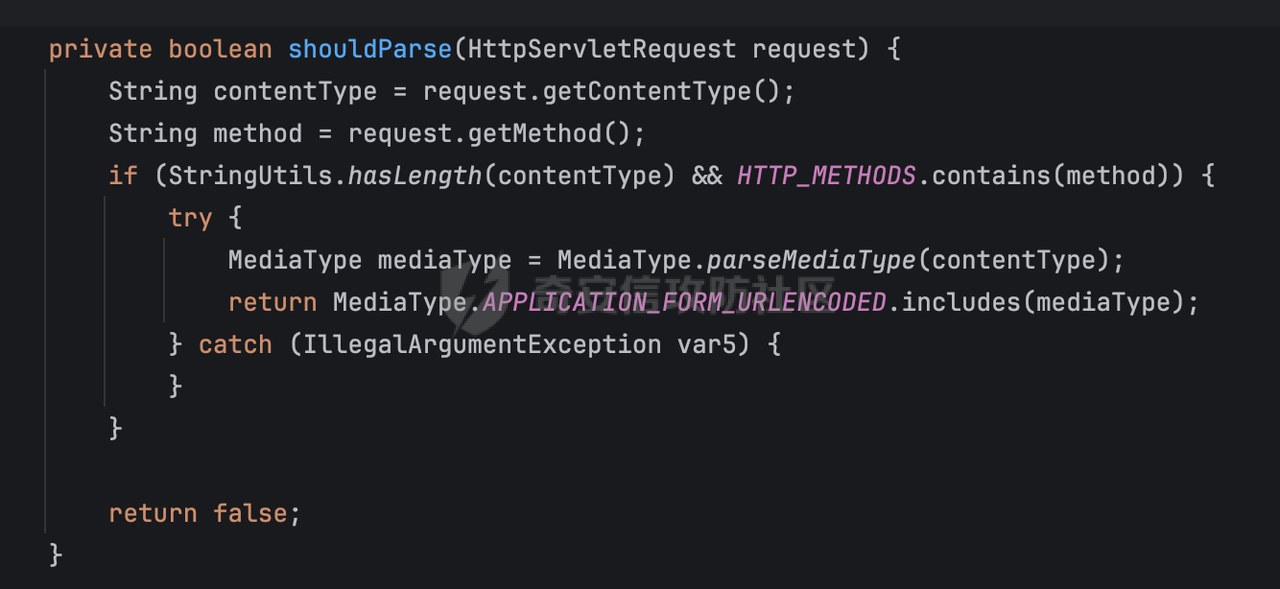 如果满足条件就会获取对应的字节流,通过FormHttpMessageConverter 按 **Content-Type 头里声明的 charset** 解码成 MultiValueMap参数名 → 值列表的形式: 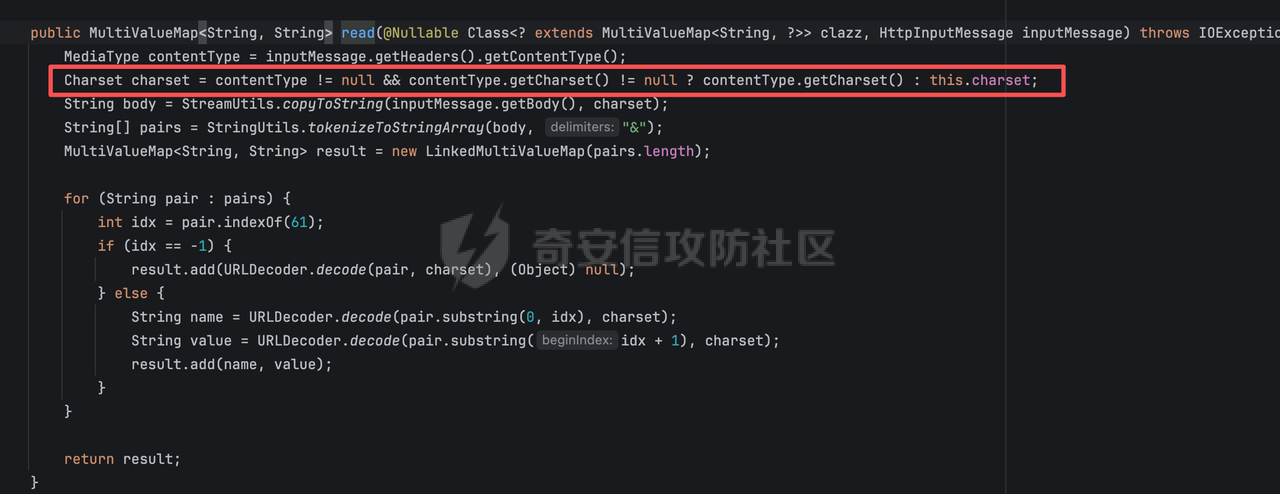 如果成功获取到相关的参数,构造 FormContentRequestWrappe,后续所有组件(后面的 filter、拦截器、@RequestParam 绑定)拿到的都是这里处理的内容: 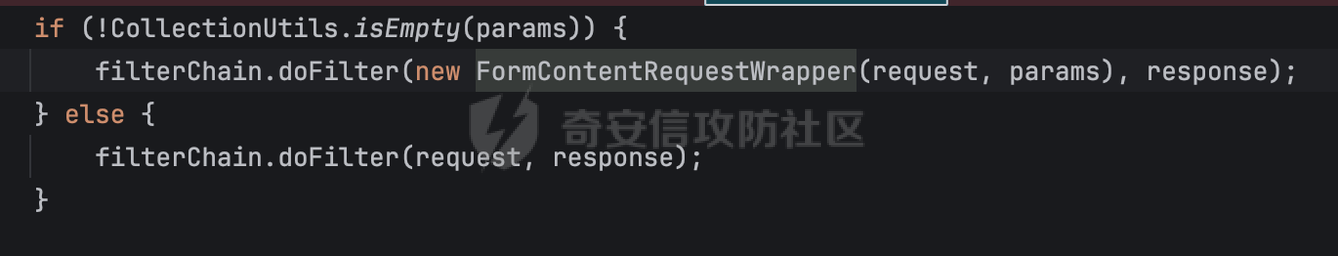 以上是整个Filter大致的执行过程。 ### 1.2.2 解析顺序差异 基于1.2.1的分析,可以知道FormContentFilter会通过Content-type里的charset,对请求的body进行解码,而之前的OrderAuthFilter直接默认了所有的请求都“仅支持”UTF-8。并且在创建Filter时,直接将其执行顺序设置成了最前面: ```Java @Order(Ordered.HIGHEST_PRECEDENCE) ``` 而对于FormContentFilter,Spring默认注册的是OrderedFormContentFilter,order值为-9900: 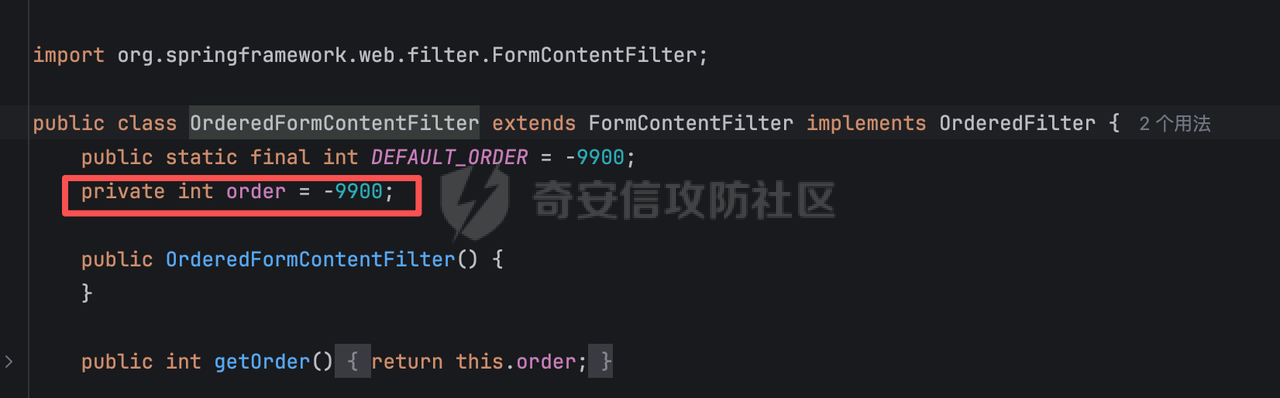 明显执行时会在鉴权Filter之后,因为OrderAuthFilter无法解析`charset=utf-16le`,导致分析时orderId为null,直接豁免了,但是在后续FormContentFilter进行了解析并还原,最终在Controller成功执行达到绕过鉴权逻辑的效果。 从对应的debug信息也可以印证这一点,执行时会遵守值越小越靠前的原则: 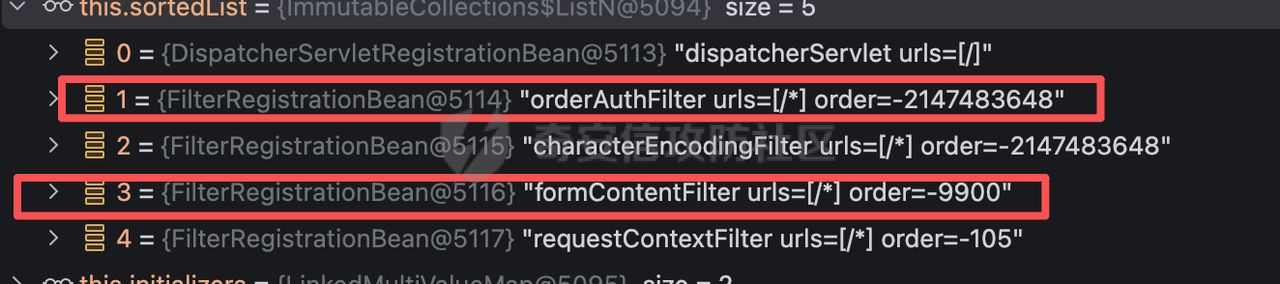 1.3 其他编码 -------- 基于前面的分析,charset 是 HTTP 中唯一由攻击者可控、又能合法切换后端解码器的开关, 结合解析顺序的差异可以达到绕过当前鉴权方式的效果。下面对其他几种编码方式也进行了尝试: | | | | |---|---|---| | charset | 结果 | 原因 | | utf-16le / utf-16be / utf-16(带 BOM) | ✅ 200 绕过 | 宽字节,ASCII 字符编码后夹 00 | | utf-32le / utf-32be | ✅ 200 绕过 | 同上,夹更多 00 | | cp037(EBCDIC) | ✅ 200 绕过 | 与 ASCII 完全不同的码表 | | gbk / iso-8859-1 等 | ❌ 403 被拦 | ASCII 兼容——orderId=... 编码后与 ASCII 逐字节相同,filter 照常解析 | 这里大致可以总结出来一个规律:**凡是 ASCII 不兼容、且 JDK 可以解析的 charset,都可以进行尝试,而** ASCII 兼容编码(GBK、Big5、ISO-8859 等)大概率是没办法达到类似的效果的。 0x02 一些思考 ========= 基于上面的案例,可能有的研发会觉得,这里本质的原因其实是因为Charset不一致的问题,是不是可以考虑通过 request.getCharacterEncoding()限制对应的白名单,是不是也能解决对应的风险? 首先看一下在tomcat里request.getCharacterEncoding()的具体实现,大概逻辑是**先返回缓存的 set 值,否则解析 Content-Type**: <https://github.com/apache/tomcat/blob/10.1.26/java/org/apache/coyote/Request.java#L401-L407> 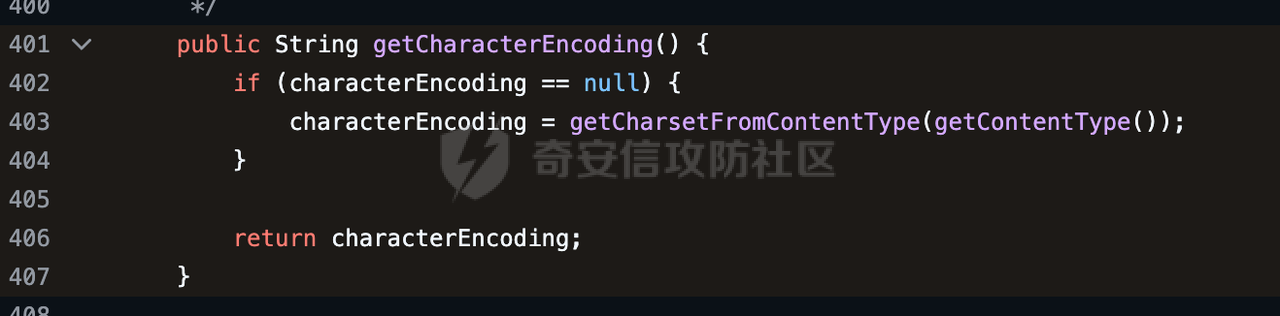 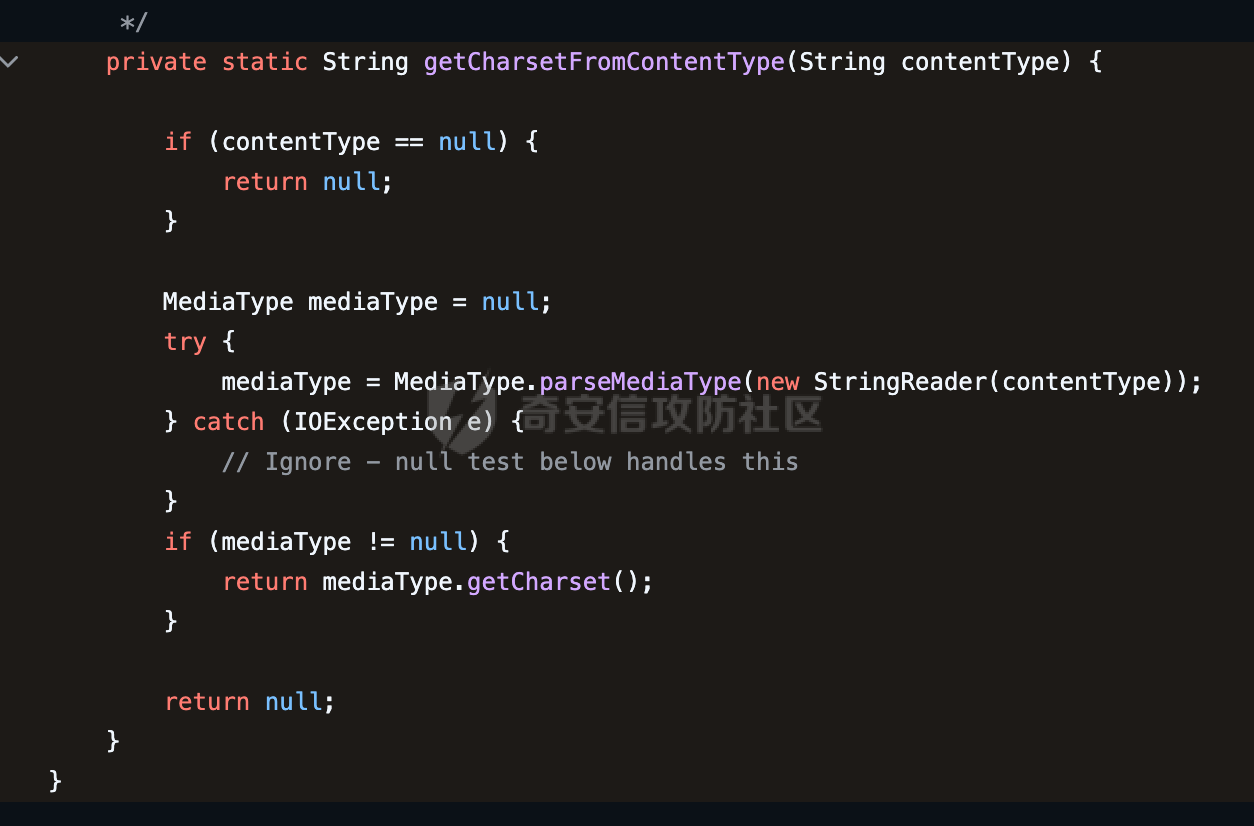 那么Spring中是否有什么机制会影响CharacterEncoding的值呢,答案是有的,也是一个filter——CharacterEncodingFilter。 Spring Boot 默认的 CharacterEncodingFilter会把请求的 characterEncoding **强制设为 UTF-8**,同时它也是默认注册的,下游 filter 用 `getCharacterEncoding()` 判断声明的 charset 永远得到 UTF-8: 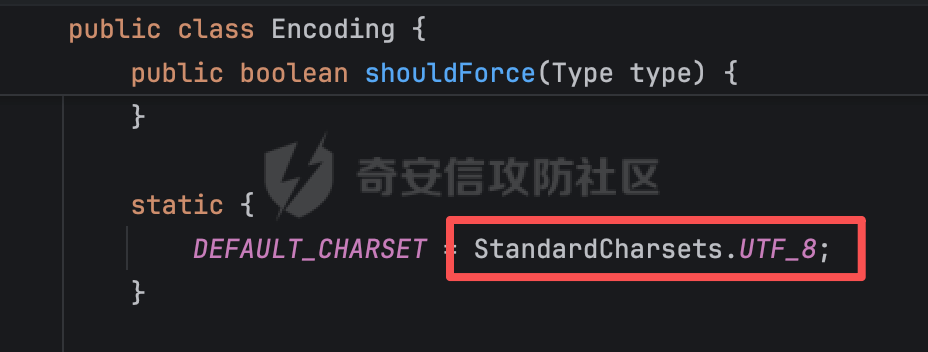 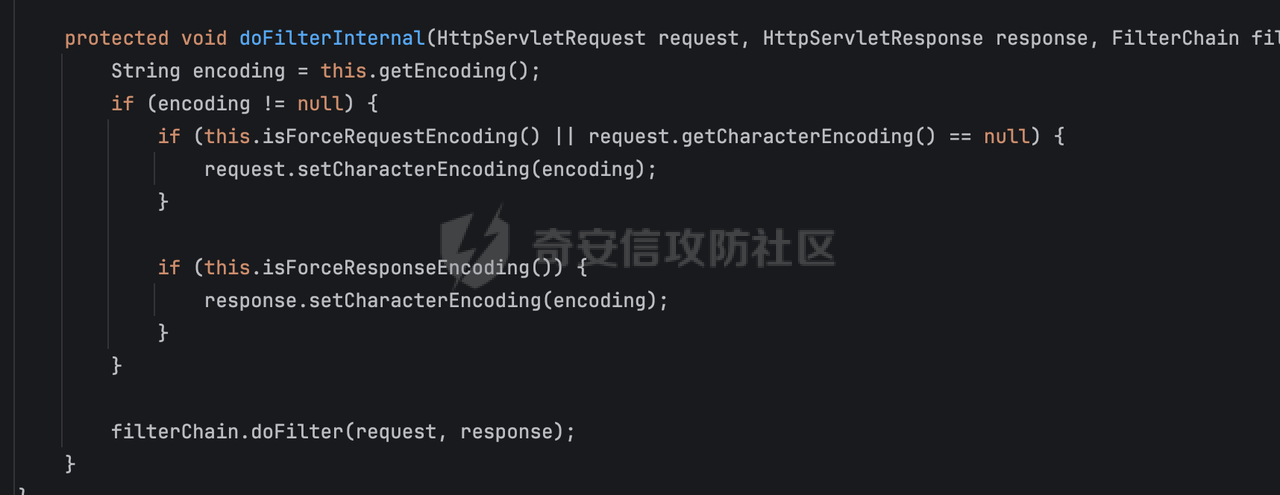 并且,查看对应的注册顺序,可以看到默认放到了最前面:  结合之前OrderedFormContentFilter,order值为-9900,我们可以发现,其实还是会存在风险的。例如鉴权Filter刚好夹在两者中间的情况,此时不论怎么获取,都是白名单的UTF-8,并不会影响后续的Charset Smuggling: 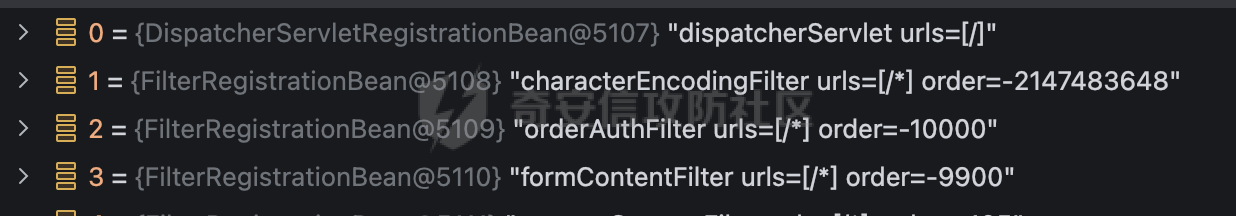 此外,同样的逻辑,如果我把filter的鉴权实现转移到interceptor的话,会发现这里其实不论使用什么编码,都可以拿到orderId对应的内容: 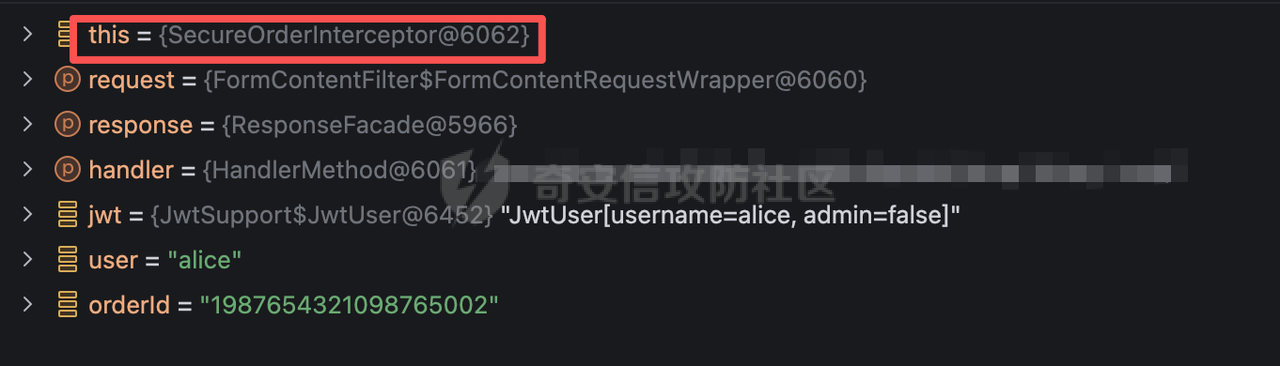 因为拦截器执行时机本身就位于 Filter 链路之后,请求体已经经过前置 Filter 的包装与解析,无需再去处理 Spring 内置 Filter 带来的流重复读取、表单解析这类底层机制问题。 这也是业内常说 Filter 更适合做请求原始日志、跨域这类底层 web 处理,鉴权类业务逻辑优先放到拦截器、切面去实现的重要原因。 但也要注意,拦截器同样存在执行顺序问题,多拦截器叠加时的调用先后会直接影响业务结果,在做链路审计、问题排查时同样需要额外重点关注。
发表于 2026-09-11 09:39:35
阅读 ( 1547 )
分类:
代码审计
2 推荐
收藏
0 条评论
tkswifty
73 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!